刚刚过去的这个 8 月,机器人行业非常热闹:世界机器人大会(WRC)与人形机器人运动会先后在北京举行,宇树科技登陆科创板。热闹尚未散尽,发改委的表态来了,"防止盲目跟风、一哄而上"。热闹与冷静之间,一个追问变得迫切:这个行业,究竟走到了哪一步?
我们请回了一位分享嘉宾:源络科技创始人连文昭。两年前他和丰叔对话时,机器人赛道还没火起来,他提出的 "直觉物理" 还是个冷门词;如今,它以 "世界模型" 之名成了最热的创业方向。当时他用 "不可能三角" 来形容机器人落地之难并表达自己的偏好:在可靠性、泛化性和速度这三者之间,他选择不苛求速度,优先保证前两者。如今,源络开始在这个方向上交出应用上的证明。 连文昭有一份少见的履历:杜克大学博士毕业后,他从硅谷通用人工智能公司 Vicarious,到 Google X 的机器人项目 Intrinsic,再到人形机器人公司 Figure。2023 年,他回国创办源络科技,不做叠衣服、倒咖啡的 demo,而是扎进泛实验室场景,把长序列、高柔性、高精度的科学实验任务作为机器人的练兵场。他同时在上海交大人工智能学院担任教授。 这场对话从今年 WRC 的现场体感谈起,谈到机器人出海的真实需求、世界模型的收敛方向、具身智能软硬件两年来各自的真实进展,最后落到一个正在升温的判断:当 AI 改变了科学发现的范式,瓶颈来到湿实验——机器人,可能是打通"干湿闭环"的物理接口。 以下为对话正文,希望能给大家带来不一样的角度和启发。欢迎移步小宇宙 APP 或 Apple Podcasts,搜索并订阅「高能量」收听完整的访谈实录。
李丰: 机器人行业火热了两年,这周宇树机器人也刚刚上市,虽然之后表现跌宕起伏,但不管怎样是个标志性事件。结合正在北京举行的世界机器人大会(WRC),我们请回了两年多以前来录过播客的 CEO 嘉宾连文昭。请连博士先简单介绍一下自己和源络科技。 连文昭: 我们是一家做 AI 机器人的创业公司,既做硬件本体——类人形机器人,现在也有更多种硬件架构;同时我们在大脑算法模型这侧的投入越来越大,在推以物体为中心的物理原生模型,持续提升机器人的可靠性和泛化性。 我们切入的场景是科学智能(AI for Science),选了泛实验室场景的一大类任务,作为练兵场和试金石,跟一些企业(如华大智造)和科研单位(如中科院)合作部署了机器人,证明在这个最难的考场上机器人能实现很多高柔性、高精度的技能。
我自己一方面负责源络的研发运营,同时在上海交大人工智能学院担任教授,带学生探索具身智能的技术边界。回国前我有三段工作经历:先在硅谷 AGI 创业公司 Vicarious 做类脑神经网络,把机器人部署到美国邮政等客户的物流场景;后来在 Google X 参与早期机器人项目、也就是后来的 Intrinsic ——很神奇,今年初它又被并回了 Google——做机器人操作系统,就像手机里的安卓系统;2023 年加入 Figure,搭建了最早的一些数据采集链路和模仿学习框架。
李丰: 信息量挺大。回到最简单的现实问题:横向比较,今年 WRC 现场是什么感受?
连文昭: 展馆越来越大,探索各行各业场景的都有:搬箱子的、分拣的、工业装配的、做饭的、端茶倒水的。几百家公司像在做几百个平行实验——说明行业还没有共识,方法上也百花齐放:有点到点纯预编程的,有靠视觉语言动作模型的,也有靠生成世界模型的……这是好事,证明行业的天花板是高的,人们对于机器人未来的预期是高的。
但如何兑现预期,是值得思考的问题——让机器人真正从 demo 走向可用的生产力。跟去年比,不同公司展示出来的能力其实差不多——叠衣服、折盒子、搬箱子、抓东西——但今年明显是 "场景化" ,都在强调场景、落地标准、产业价值,之前更多的是 "展示性" :机器人做一个很短的任务、展示一个小能力就结束了。
今年双足跳舞还是很热闹,情绪价值也是一种真正的价值;但我更关注操作这一层:它明显在从能力展示,往可靠性这个行业目标迁移。
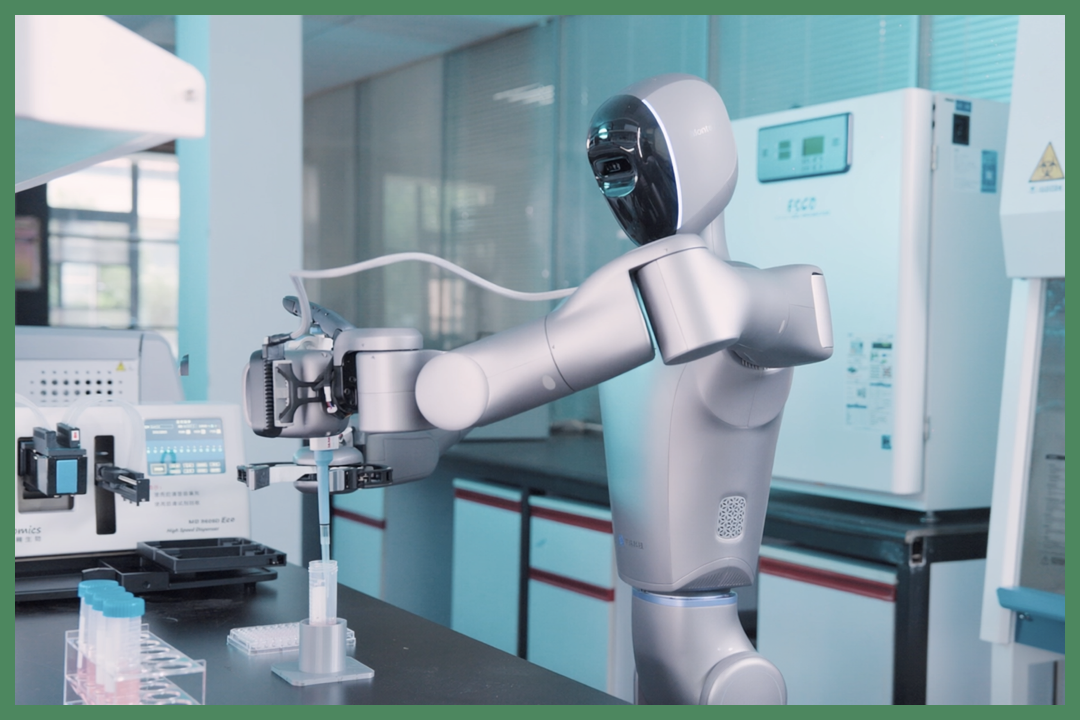
源络今年是第二次参展。我们还是以生命科学领域里长序列、高柔性、高精度的操作牵引研发,展示了细胞学实验,包括细胞毒性检验这种长序列流程——要处理移液枪、液体、试管、离心机等各种仪器——又要柔性又要精度,既要智能又要可靠。
连文昭: 确实,非华人面孔明显多了:欧洲的,日韩的,还有中东、东南亚的。有些是做商业的,希望把中国产的智能机器人引入当地;也有的想自己做机器人公司,来看看和学习。海外对中国的机器人研发和生产制造能力是绝对认可的。我们正在成为事实上的机器人全球中心。
李丰: 这些外国友人里,多少是带着商业和需求目的想找解决方案的,多少只是看看热闹?
连文昭: 更多是前者,至少是尝试实质合作——比如作为集成商或分销商卖到当地,这个意愿很高。
李丰: 在你接触的小样本里,需求有多少是可行的,有多少还在机器人能力之外?
连文昭: 从能力讲,绝大多数都可以做到,前提是付出足够的成本。他们提的多是很惯常的诉求:机床上下料、装配自行车(不知道他们为什么要在当地做自行车,应该从中国买),也有做超市服务的、制药公司的,大家实实在在有诉求。这些需求发生在中国,我们肯定能做,但在海外难一些:当地工程师数量低于国内,人员协同的投入会更大,地缘政治因素也需要考虑。
连文昭: 初期小量肯定都可以做;真要上量,还是回到是不是能可靠地做。如果只是推一台特定的机器,定价都可以谈,但最终总要形成标准、然后规模化,这时就需要机器人证明它是可靠的。
什么叫可靠?机器人在一个地方跑了一天,第二天客户是不是还主动愿意开机?愿意开机,就可以覆盖成本,付费意愿就强;如果第二天没开机,比如"工程师不来就不开机",成本肯定高。所以要筛选,这是个动态过程。
另外,行业过去传递的信心也让市场预期偏高——经常有人拿一个很复杂的流程说,这个你们应该很容易做。但预期高也是好事,需求池子更大,可以筛选。
李丰: 看起来机器人的国际化,可能成为中国新出口中的一个潜在增项,虽然现在量还小。
李丰: 两年多以前录上一期时,你提了一个当时不受关注的词,叫 "直觉物理" ——说白了,人知道怎么拿东西,用什么姿态、力道对物体做动作,也包括常识性的物理。而从去年年底开始,最热的机器人创业方向叫世界模型、物理模型。虽然定义非常多,总之是让机器人理解这个带物理量的世界,并与物理世界交互。我们也投了几家这样的公司,估值涨得非常快。因为你两年前就在思考 "直觉物理" 这个话题,你怎么看待今天世界模型的发展阶段和解决方案?
连文昭: 机器人要做的事情,本质上是两个问题:一是知道要动到什么地方,二是怎么安全可靠地动到那。运动大体分两类:自由空间里从 A 点到 B 点;以及有接触、有交互——把这个东西也从 A 挪到 B,这个 A 到 B 不光是空间上的,也是状态上的。另一个问题是:如何决定我的 B 点在哪、目标是什么。
之前行业在推的视觉语言动作模型(VLA)也好、世界模型也好,都是想理解常识,方式是采集大量数据。VLA 是采完数据做一个回归:从观测到的量直接决定往哪动。它其实是一条捷径,绕过了理解,直接生成动作。但后来大家发现有点问题——它是过拟合的,泛化性没有想象的好。
插一句,现在我的学生也经常说泛化,说一个东西往左移 0.5 厘米还能抓,就叫泛化了。我从来不觉得这叫泛化——大家往 VLA 走的时候,反而把标准降低了。
慢慢大家意识到这个问题,又开始做世界模型:用神经网络、Transformer提特征,做决策时不丢掉理解世界的信息——不光生成动作,还要理解客观物体的发展规律。但过去这些世界模型往往还是 pixel to pixel。
连文昭: 每一个像素都要预测、重建出来。这其实是反直觉物理的——模型把大量表达能力都用在重建和恢复上。我们一直在践行"以物体为中心"的思路:不过度建模不用去关心的小细节;但有一些重要的细节,以前的视觉世界模型里没有的,我们反而要关心——比如力,力的模态是很关键的模态。
力这个模态很有意思:视觉上,你换个角度,得到的信息跟你的本体可能没有太大关系;但力是你的本体施加到环境中的,完完全全取决于你自己。你施力大,反馈就大,是跟动作极其绑定耦合的东西。我们在做的世界动力学模型先建模原始的图像和动作输入,然后一边预测未来的图像和力,一边把预测结果跟实际施加动作后实测到的力做比较。
连文昭: 不能只做前馈。我预测会感受到多大的力,也预测我的动作;动作施加到环境中,又感觉到一个新的力;新的力跟预测的力比较,反哺回来纠正预测能力。形成这么一个闭环之后,随着数据增多,机器人跟物体交互的直觉规律,就能被理解得越来越好,估计误差越来越小。
李丰: 今天这些方向肯定没有收敛,概念也变了好几个,包括 VLA、VLM、世界模型等等。从你的角度看,当然只代表你个人观点:接下来一两三步,大家在建模世界、理解世界上可能向哪几个方向收敛?
连文昭: 需要从最终目标倒推:一是零样本、小样本的泛化——扔到新环境,一次演示甚至零演示,它就能动起来、理解任务并去执行;二是绝对安全,知道自己的边界,有异常也能处理。就是可泛化且可靠。倒推回来:需要数据效率最高的方式,也要能评估自己输出的不确定性边界,保证自主的安全性。应该沿这两条路线走。
关于提高数据效率,大家在做各种尝试。一是让数据采集更便宜,比如egocentric(第一人称视角)的视频数据,丰叔应该还记得 2023 年我们讲公司的具身路线时,就已经在大量采集。
二是让数据里能榨出的信息密度更高、更贴近直觉物理,比如以物体为中心而非一个个像素点,以及从 2D 或多视角 2D 中隐式推出 3D,因为 3D 是对环境更本质的理解。
另一个维度是安全性:过去的数据集通常以视觉为主甚至只有视觉,现在行业也在采集力觉甚至触觉,有做触觉手套、做各种传感器的。我们自己也在探索把视、力、触觉融合起来,也做了自己的数据采集链路。这也是个比较显著的趋势。
李丰: 回到中国机器人行业。过去两三年,软的——算法,和硬的——电机、关节这些硬件和手的控制,各自进步的状态和速度是什么样的?
连文昭: 硬件看起来发展没那么快,但工程上实质取得的进展很快;软件上大家看到的演示很漂亮、变得特别快,但拉长时间维度看,进展可能没有想象的那么快。
硬件上很多人会说,两三年前 WRC 展示的就是这些协作臂、人形机器人,现在还是这些,关节可能还是谐波或者行星减速器。但背后的供应链、设计、系统集成,实质发展比想象快很多,成本自不必说。
另外是可靠性:像我们自己做的,绝对定位精度已经能逼近以往工业机器人,这在两年前不太敢想象。硬件的迭代速度甚至已经逼近软件迭代的曲线。这得益于国家的大量投入和行业的百花齐放,使得上游机加工、电子、传感器产业很成熟,生态越来越好,协议和标准也逐渐形成。进展比大家的体感快一些。
模型算法这一侧,新成果很多,不管是纯端到端的 VLA,还是基于世界模型,展示出的能力越来越强。但透过展示看本质,研发范式没有特别大的颠覆。可以讲我们还在 "抄大语言模型的作业"。
连文昭: 我更期待找到一个不一样的范式:语言本质上是一个维度,token 空间是离散的,观测空间和预测空间一致,语言是个很特殊的问题;但机器人的输入空间如此之多——力、触觉、自己的关节,甚至环境中视觉观测不到的状态,水是满的还是空的、电器是开的还是关的,都要融合进来,而输出空间只是机器人自己的控制。它跟大语言模型本质上不是同一个问题,但我们还在按大语言模型的方式在推。拉长时间看,机器人模型的训练推理范式,还需要更多思考。
李丰: 我不是技术背景,试着简单归纳一下。语言预测 token,字词之间是"逻辑关系",不是绝对零和一,换句话说一句话可以有很多种表达,虽然也有一些简单约束。但机器人涉及到物理关系:比如你不能把手穿过桌面,它受非常严格的物理和环境约束,很多是零和一、中间没有 0.1、0.3 的过程。既然机器人和语言存在这个差别,它最终有多大可能借鉴大语言模型的能力和架构,又有多大比例会不同于语言模型?
连文昭: 挺难的问题。我完全赞同这个归纳:大语言模型本质在学逻辑关系,约束更简单、解空间更大。但物理世界约束更多,它蕴含了逻辑问题,之上还有物理和几何问题。几何是运动学相关的:关节动多少度,杆子末端相应动多少厘米;物理是动力学相关的:施加多大的力,东西被推多远,摩擦力是多少;逻辑也包括任务层面的,比如大象放冰箱分几步。所以有逻辑、物理、几何,机器人是一个更高维、更复杂的问题。
给具身智能一个不那么正式的定义:在很多约束条件下,如何改变目标物体的状态。它很多时候有精确解,做到就是做到,没做到就是没做到;语言则可以模棱两可。
如果我们同意具身智能是个更难的问题,我们肯定可以借鉴大语言模型很多东西,比如 next token prediction 这种学过去与未来关联、用关联近似因果的范式。但只有这些不够,因为文字没有时间概念,物理有时间维度,几何还有很多约束。把因果、约束、时间维度加进来,是必须的。
李丰: 回到源络本身。两年半以前确定应用场景时,大家还在做叠衣服、倒咖啡之类的 demo,你选了一个比较不同、相对难做的方向。你是怎么考虑的?
连文昭: 上次谈到 "不可能三角":通用性、可靠性和速度,不能同时达到,牺牲哪一个?我们的选择是:速度不苛求,达到阈值就行;通用性则不是一开始解决一万件事情,而是在一个真实场景里先解决几十件事情。
基于这个假设,我们找现在的机器人"踮踮脚够得着"、能在可预见时间内落地的场景,但又不希望这个场景把我们的天花板锁死、把我们牵引到短视的技术路线上。
所以要选难的场景:长序列,拷打逻辑能力;高精度,考验对几何和物理的理解;同时高柔性,区别于以往的工业自动化。我希望在最难的考场里去牵引我们的技术研发,如果这些能做好,未来走向家用的一万件事一定能解决。
同时,从行业本身讲,它得是真的需求:生化环材、生物医药行业,确实需要这样的智能体做物理操作。科学家、博士生做实验,很大的痛点是不可复现。
即使流程写好了,"把 A、B、C、D 在 25 度下混匀",有人的理解是从 4 度冰箱拿出来放一小时、真到了25度再混匀;有人理解为在 25 度的环境下,拿出来直接混就行,哪怕 A 其实还是 4 度的;倒完 A 才想起要拿 C,又去冰箱跑一趟,反应条件自然就不一样了。类似的细节很多,更别提做实验时还可能打个喷嚏。
所谓新药研发"十年十个亿、成功率 10%",这还是很大的痛点。机器人干这件事天然比人好:每个步骤都忠实地按细粒度做下来,今天怎么做,第二天还怎么做,每个条件参数都记录下来,可靠性就提升了。
另一个点,实验室研发依赖仪器,仪器依赖人操作。人朝九晚五,人不工作,仪器就闲置,利用率可能只有百分之三四十,而仪器往往很贵,研发流程就被无限拉长。在计算机和 AI 领域,我们能并行跑一大堆实验;如果机器人做实验助理,把仪器串联、调动起来,质量和吞吐量都能提升,更不用说有些危险实验本身就不适合人做。
AI 已经让我们人类快速走向"好吃懒做",它已经在帮助我们思考,机器人应该能比较快地帮我们"不用怎么做事情";如果科研的研发方式能有一个比较好的变革,人类追求的另一个目标"长生不老",应该也能比较快地实现。
李丰: 在我念书时,生化环材是"天坑专业",今天都变成热门方向了。最近的好消息是:前些天,当年做 mRNA 疫苗的莫德纳,个性化肿瘤疫苗三期临床拿到显著结果,算是个大突破,新闻里说筛选时用了 AI。还有一篇文章说:如果 AI 改变了科学发现的范式,最大的瓶颈就来到湿实验,因为只有湿实验和发现效率配套,提供足够多、足够快、足够整齐的数据来验证和循环。这让我想起自己念研究生时做化学实验的痛苦——每次和每次都不太一样。那今天机器人在实验环节里,能力上到底能解决到什么程度?哪些难的技术节点被你们克服了?
连文昭: 过去两年多积累的能力,至少覆盖常见的实验流程,包括处理液体、固体、粉末或颗粒状的样品,操作离心机、PCR 这些常见仪器。我们把实验流程拆解成相应的技能,现在 80% 以上的常见流程都可以复现,一些局部已经能做到小闭环。
相当于 PI、甚至博士生也可以享福,有了研究助理:发一个指令,机器人调度实验室里的相关要素来完成局部闭环,导出结果,他根据结果决策下一步。
所以我们现在是辅助科研人员的阶段,不会去替代科学家,类比自动驾驶上高速开 L2。一个人下班前六点想做一组实验,不用半夜两点回来换液,机器人干这个事,保证他第二天早上九点来时结果是读出来的。这种能力我们的机器人已经达到了。
数字 AI 已经能把"生成"解决得很好,在极大的搜索空间里提假设、提可能的流程。但当流程提得越来越多,不可能靠人海战术一个一个去验。这里存在一个很大的鸿沟,大家经常提机器人的 sim to real 鸿沟,这个更像"生成到验证"的鸿沟,即实验的缺失。
我们一直在提供一个物理的界面把这个鸿沟闭环掉:数字 AI 利用这些数据,我们的物理 API 可以被调度,整个流程就闭环了。现在也在跟很多客户逐渐验证,开始规模化。
李丰: 能做什么大概听懂了。你在 WRC 里溜达时,有看见跟你们方向类似的公司吗?如果很少,你们做的事难在哪儿?
连文昭: 场馆太大,我走得很快,我感觉信息量不太大,很多是相似的。至少在能看到的范围内,在科学智能领域做高精度、高柔性的事情,我们还是比较独特的。
连文昭: 硬件的提升是下限的保障——必须达到某种能力,才可能去解决这些问题。刚成立时我们外采过机械臂,精度到不了;自研最初期也抖动很厉害,但现在能到了。到了这个程度,才有可能达到软件模型带来的上限,也就是用多大的成本训好一个模型,让它快速学会移液、操作离心机。
我们现在的状态是比较健康的:下限比较稳,上限也做到了可部署、可交付;当然我们会持续提升上限,让处理新任务所需的样本量减少,甚至真正零样本泛化出来。

 Scan to open this article