这一功能已通过 Gemini API 在 Google AI Studio 上对视频上传和 YouTube 视频开放:https://ai.google.dev/gemini-api/docs/video-understanding#agentic-video-understanding 以及在 Gemini 企业代理平台:https://docs.cloud.google.com/gemini-enterprise-agent-platform/models/capabilities/video-understanding 间提供。开发者在 API 配置中将处理模式设置为 “agentic”,并按标准 Gemini API 令牌费率支付,无需额外费用。更多详情可参见开发者指南:https://aistudio.google.com/learn/agentic-video-understanding-with-gemini。广告
Google 计划将这些改进带入自家产品。该功能很快将在 Flash 和 Flash Lite 设备的所有 Gemini 应用用户中推出。在未来几个月中,基于代理的视频分析还将为播放页面上的“Ask YouTube” 功能提供支持:https://the-decoder.com/googles-ask-youtube-turns-video-search-into-a-conversation/,使答案更紧密地对应视频中实际可见的内容。
保持对人工智能的了解。清晰、有用,无废话。
关注 The Decoder 获取 AI 新闻、背景故事和专家分析。
解码器:https://the-decoder.com/
Google is adding agent-based video analysis to several Gemini models. Instead of scanning a video frame by frame at a fixed rate, the model hunts for relevant sections on its own, which Google says cuts token usage and costs by a wide margin.
The latest models, Gemini 3.7 Flash:https://the-decoder.com/gemini-3-7-flash-lands-with-coding-gains-and-undercuts-its-three-week-old-predecessors-price-by-50/, 3.6 Flash, and 3.5 Flash-Lite:https://the-decoder.com/googles-gemini-3-5-flash-follows-anthropic-and-openai-in-making-newer-ai-models-significantly-pricier/, can pick up moments shorter than one second, including state changes or cuts that would slip through at one frame per second. Google says this makes automated video editing far more precise.
The system can also track down individual scenes in hours of footage without burning through millions of tokens. It spots anomalies by resampling suspicious time windows at a higher frame rate and accurately counts repeated movements and individual objects over time. Ad
Until now, Gemini relied on static processing, sampling video at a fixed frame rate of one frame per second by default and adjustable through the API. Since native video analysis launched in 2025:https://the-decoder.com/googles-gemini-models-add-native-video-understanding/, Gemini has been transcribing the audio track and analyzing frames on a per-second basis. Ad
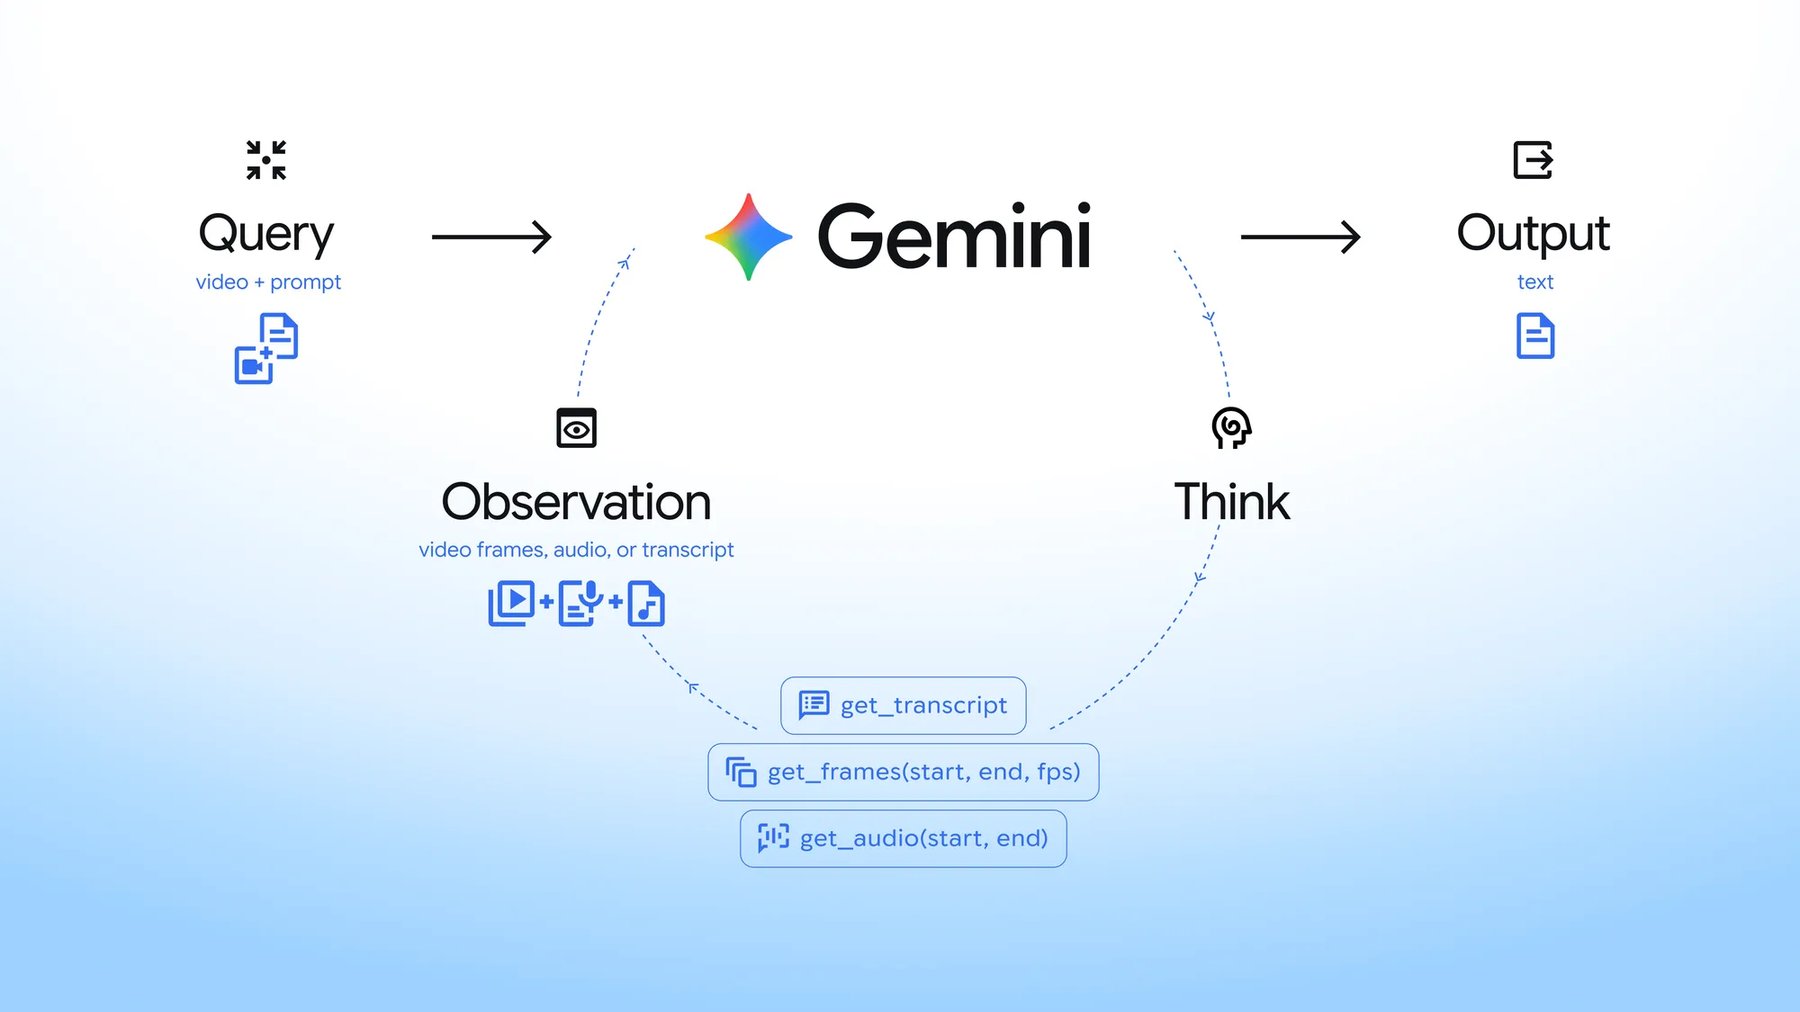
Google says the agent-based variant ties the model's reasoning directly to native video tools. The model decides on its own which sections to look at, at what speed, and through which modality, whether that means frames, audio, or transcript. It only pulls the moments and signals it actually needs for a given task.
Gemini now uses an internal tool to grab just the relevant portion of the video file. Developers could build this kind of selective approach manually before, but the model now handles it on its own. Ad
The approach builds on "agentic vision," which Google shipped for Gemini 3 Flash in January:https://the-decoder.com/google-deepmind-gives-gemini-3-flash-the-ability-to-actively-explore-images-through-code/. That feature let the model write and run Python code to zoom, crop, and annotate images, checking each result in a think-act-observe loop before responding. It didn't work automatically in every case at launch, but the groundwork was already there. When Google announced Gemini 3 Flash back in December:https://the-decoder.com/google-makes-gemini-3-flash-the-default-for-search-and-slashes-reasoning-costs/, the company flagged visual and spatial reasoning for video as a coming capability.
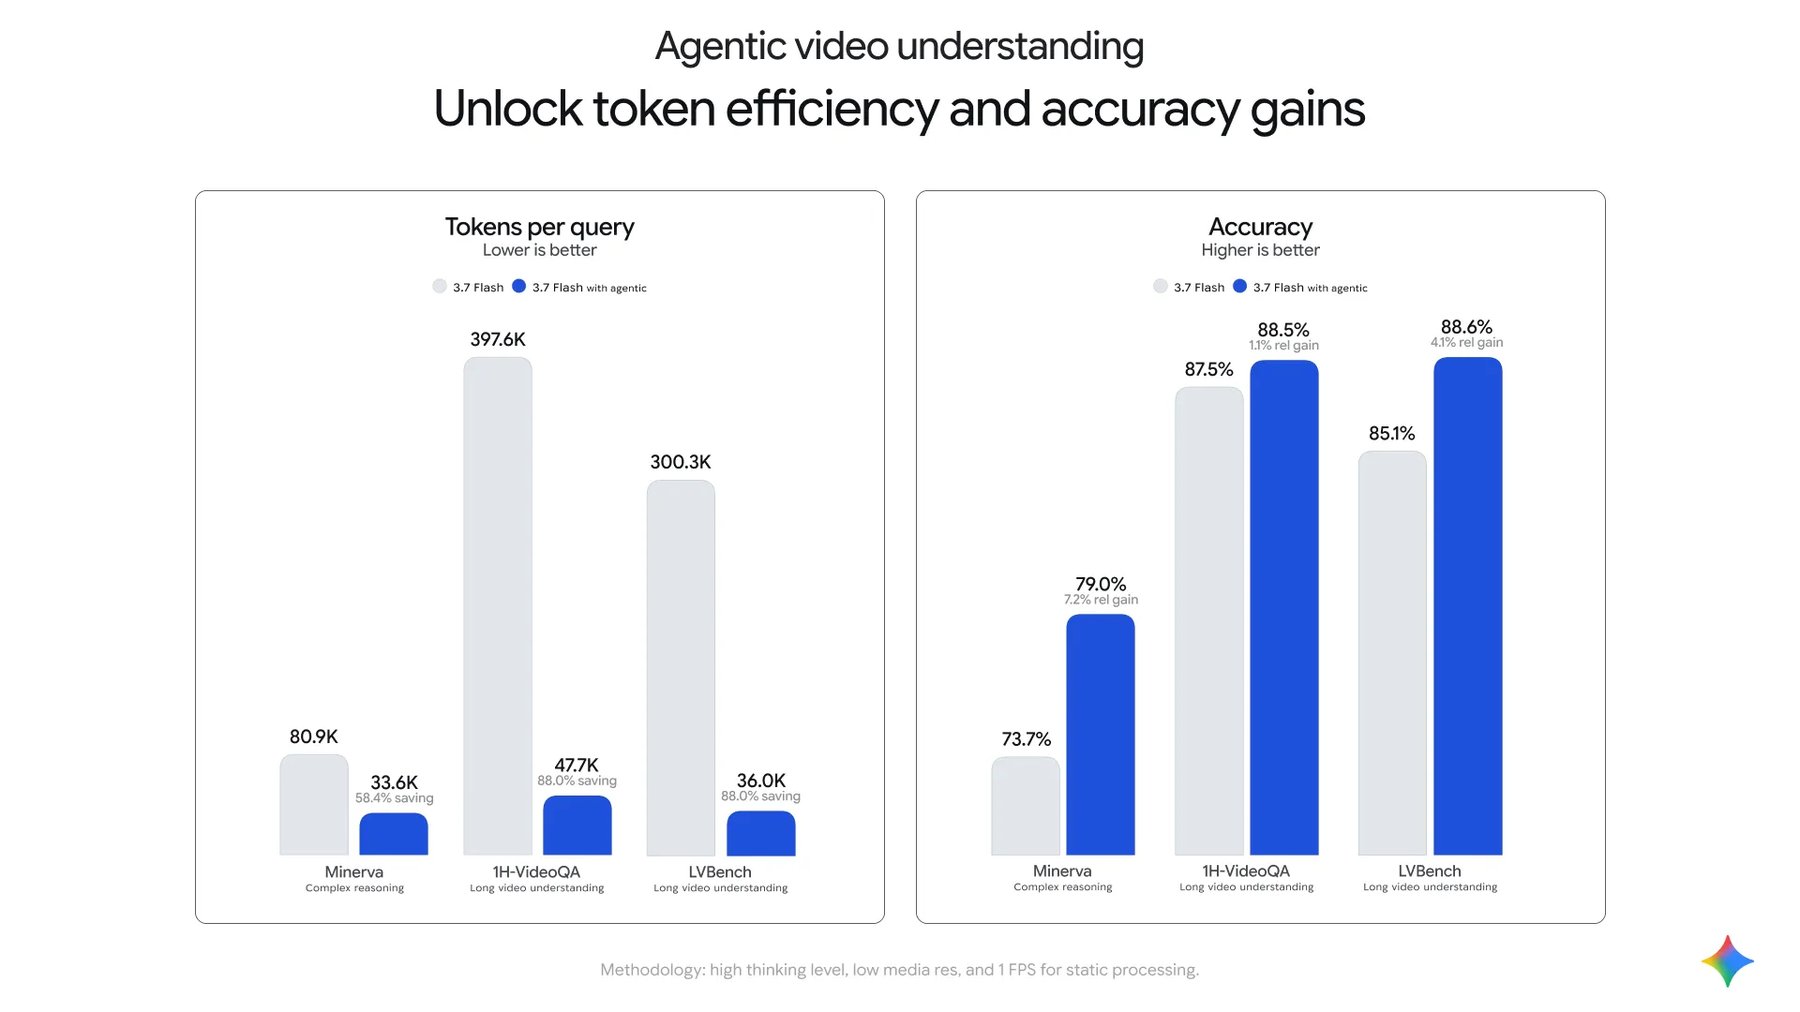
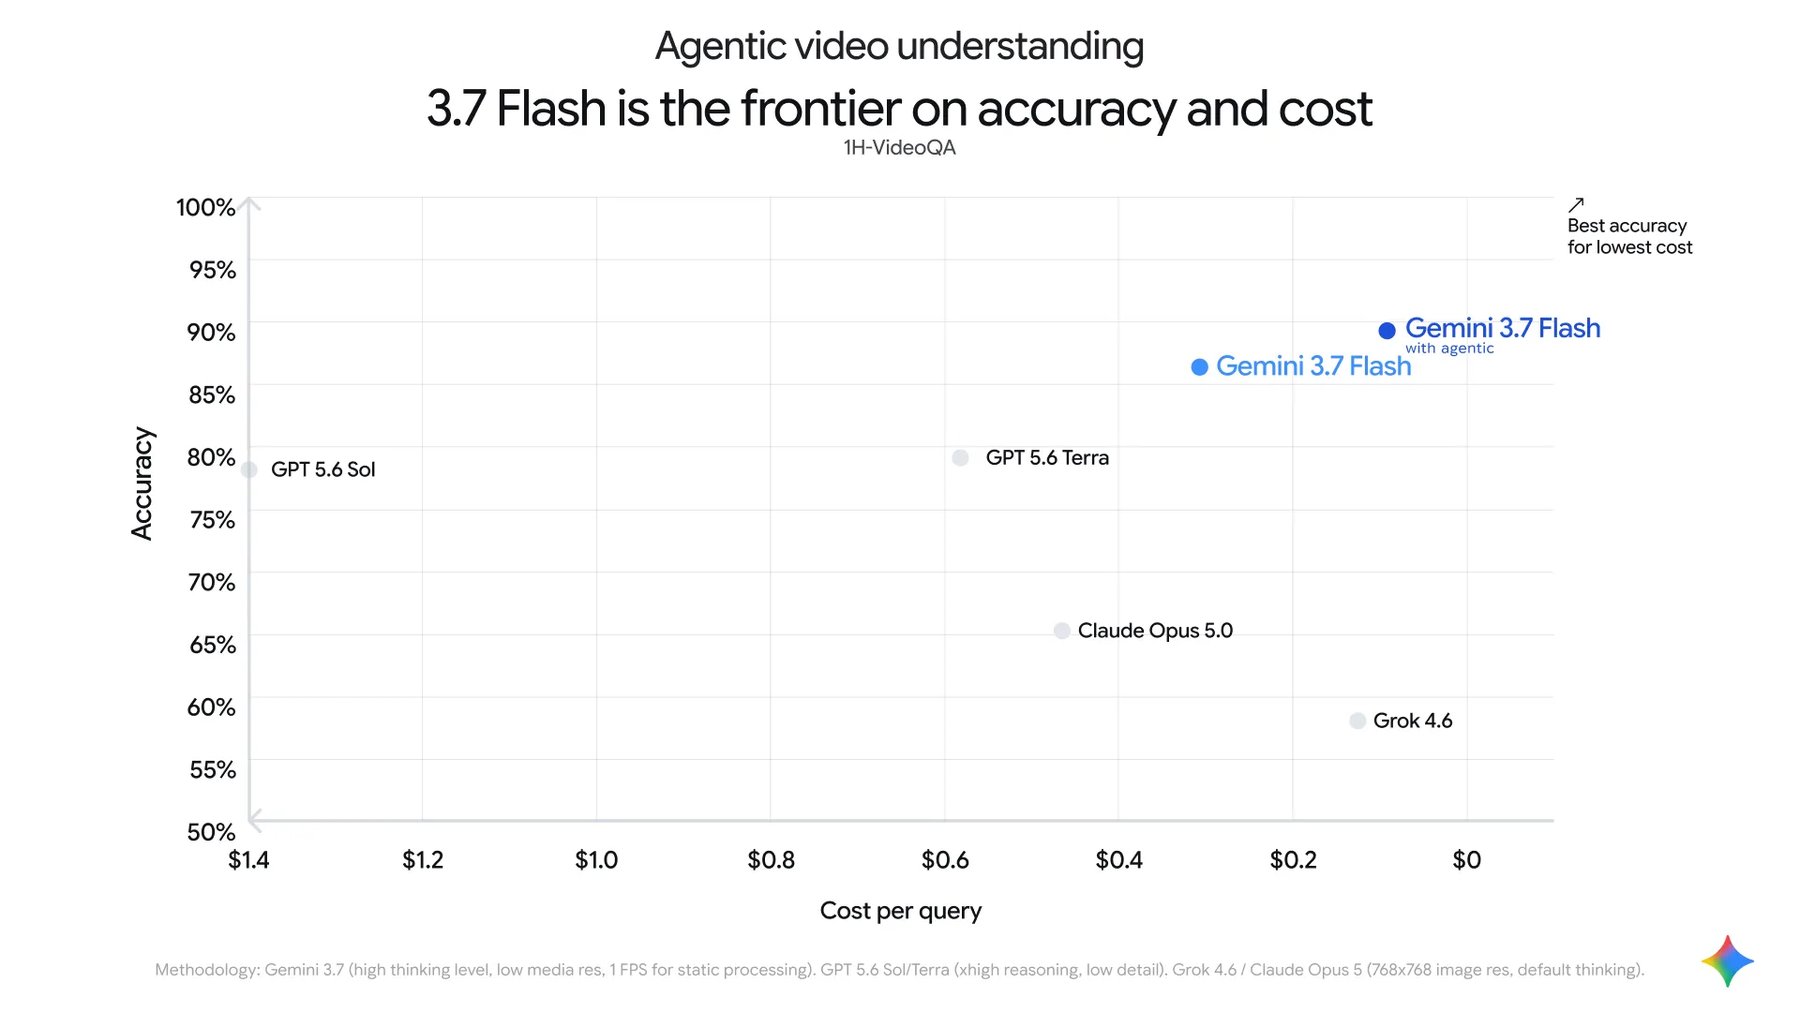
The efficiency gains show up most with long videos, anywhere from 10-minute tutorials to 90-minute lectures and multi-hour recordings. With static processing, developers had to pick between high token costs and methods that throw away important details. On Google's own benchmarks, including LongVideoBench, Gemini 3.7 Flash with agent-based analysis scores the highest overall quality and delivers the best mix of accuracy and cost efficiency. Ad
The feature is live for video uploads and YouTube videos through the Gemini API in Google AI Studio:https://ai.google.dev/gemini-api/docs/video-understanding#agentic-video-understanding and on the Gemini Enterprise Agent Platform:https://docs.cloud.google.com/gemini-enterprise-agent-platform/models/capabilities/video-understanding. Developers set the processing mode to "agentic" in the API config and pay standard Gemini API token rates with no added fee. More details are in the Developer Guide:https://aistudio.google.com/learn/agentic-video-understanding-with-gemini. Ad
Google plans to bring these improvements to its own products too. The feature should roll out soon to all Gemini app users on Flash and Flash Lite devices. Over the coming months, agent-based video analysis will also power the "Ask YouTube":https://the-decoder.com/googles-ask-youtube-turns-video-search-into-a-conversation/ feature on the playback page, giving answers more closely tied to what's actually visible in the video.
Stay in the loop on AI. Clear, useful, no fluff.
Follow The Decoder for AI news, background stories and expert analyses.

 扫码直达文章详情