Quasar sets a new benchmark for European AI, outperforming comparable European models on seven of eight selected Artificial Analysis evaluations.
Quasar 438B is our flagship reasoning model, built for enterprise-scale agents and coding. It is the first large model Multiverse Computing has released, it runs in English and Spanish, and it scores 43 on the Artificial Analysis Intelligence Index, the highest result of any European model in the field.
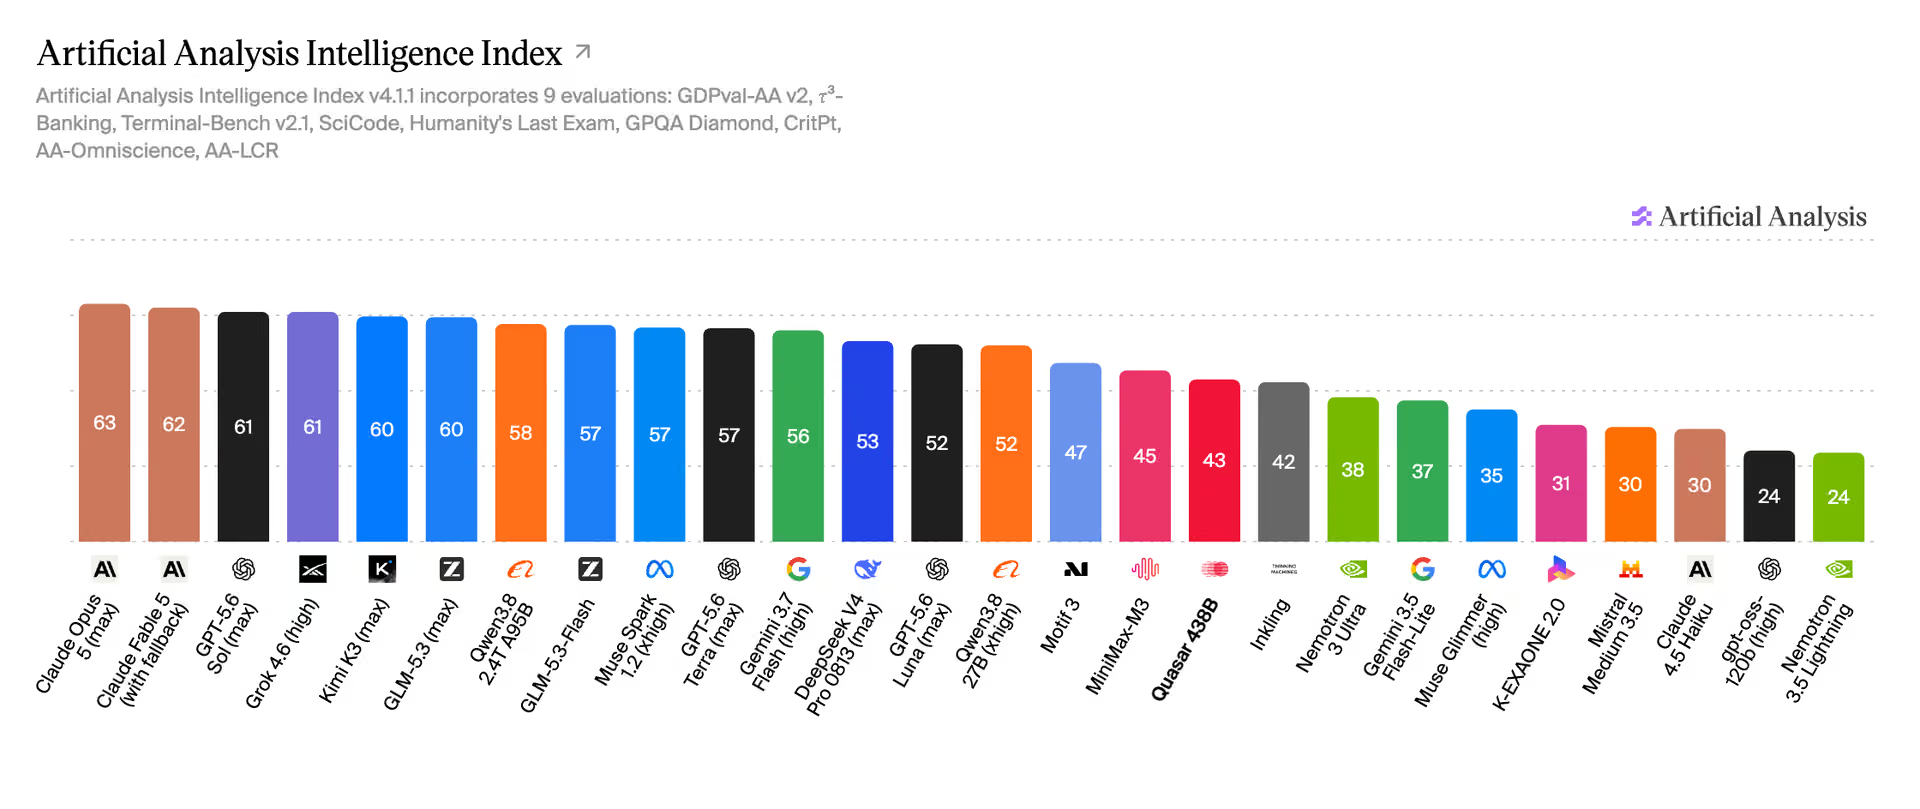
The Intelligence Index v4.1.1 combines nine evaluations: GDPval-AA v2, τ³-Banking, Terminal-Bench v2.1, SciCode, Humanity's Last Exam, GPQA Diamond, CritPt, AA-Omniscience and AA-LCR. Quasar's 43 puts it ahead of Mistral Medium 3.5 at 30, NVIDIA Nemotron 3 Ultra at 38 and Inkling at 42, in a field led by Claude Opus 5 at 63.
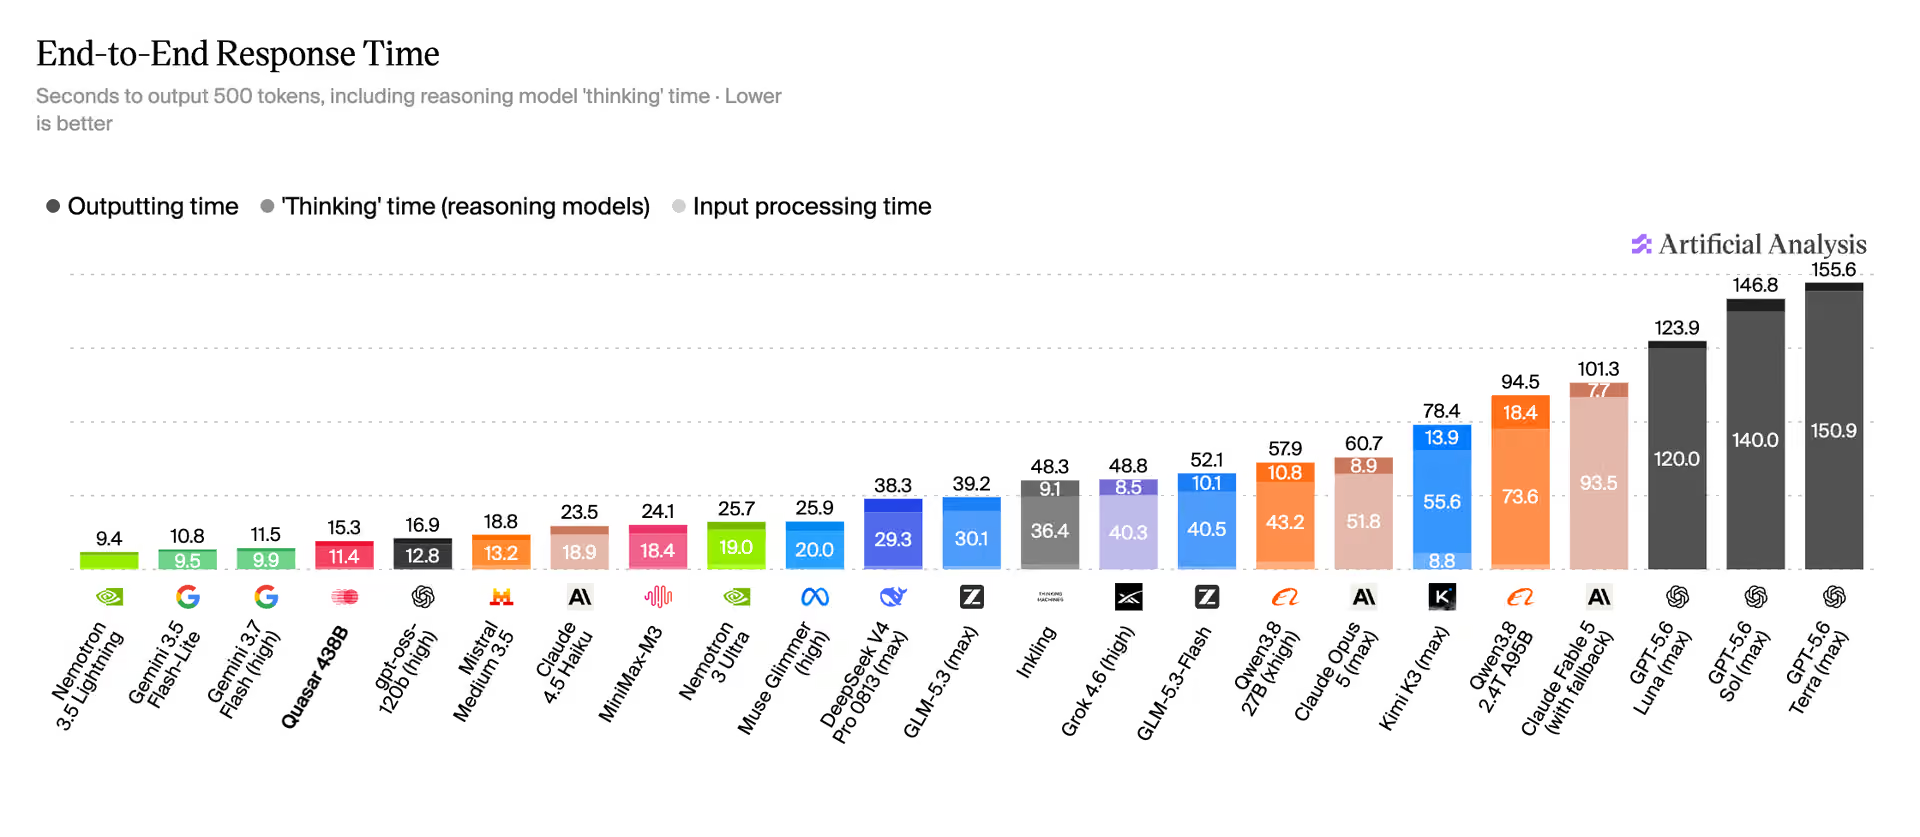
Quasar is not only intelligent, it is also fast. It returns 500 tokens, thinking time included, in 15.3 seconds. Only three models in the comparison are faster, and only one of those, Gemini 3.7 Flash, scores higher on the index. Of the models that do outscore Quasar, only two answer in under 25 seconds. The rest take between 38 and 156.
Multiverse Computing has built its position on making AI more efficient and deployable. Quasar brings that work into the 400B-plus parameter class: a reasoning model for multi-step tasks that need planning, tool use, code execution and large context, without the latency that class normally carries.
The model is available through the CompactifAI API, so teams can test it without standing up infrastructure.
Figure 1. Artificial Analysis Intelligence Index v4.1.1, a composite of nine evaluations. Higher is better.
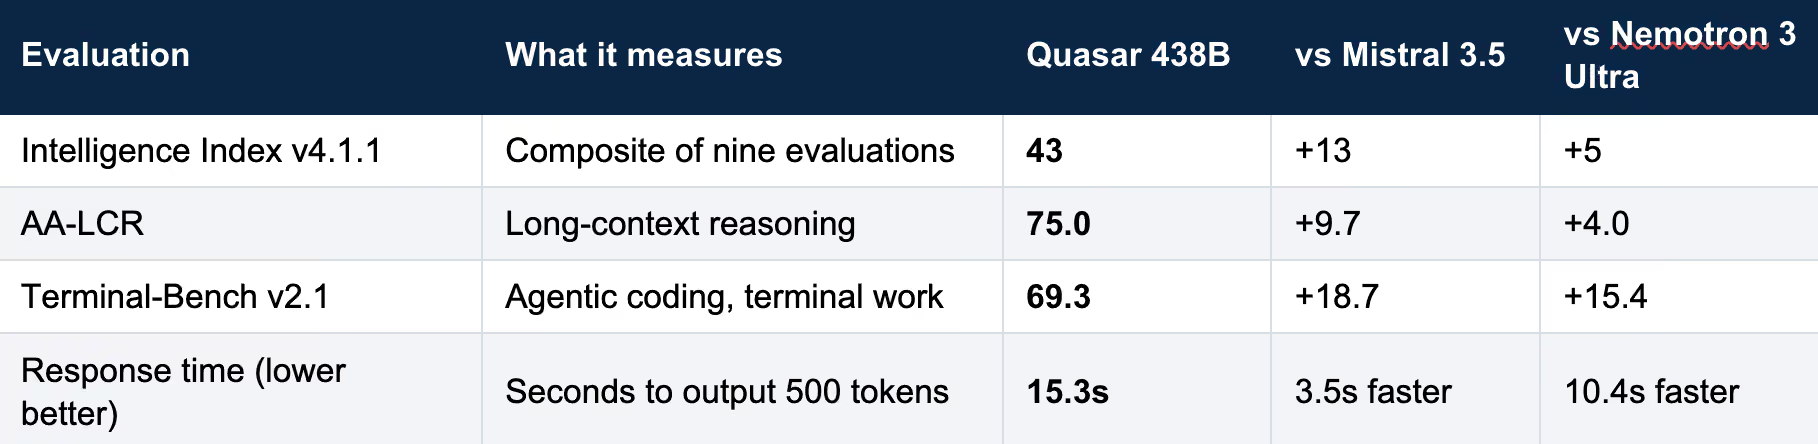
Quasar scores 43 on the composite index. That is 13 points ahead of Mistral Medium 3.5 and 5 ahead of Nemotron 3 Ultra, which carries 112 billion more parameters.
Figure 2. End-to-end response time: seconds to output 500 tokens, including reasoning time. Lower is better.
Quasar completes a 500-token response in 15.3 seconds. The three faster models in the comparison are Nemotron 3.5 Lightning at 9.4s, which scores 24 on the index, Gemini 3.5 Flash-Lite at 10.8s, which scores 37, and Gemini 3.7 Flash at 11.5s, which scores 56. Only the last of those is both faster and more capable.
Read it the other way and the gap is wider. Quasar scores 43 and takes 15.3 seconds. Mistral Medium 3.5 scores 30 and takes 18.8 seconds. Nemotron 3 Ultra scores 36 and takes 25.7 seconds, Inkling scores 42 and needs 48.3 secods, more than double than Quasar 438B.
Against Mistral Medium 3.5 the comparison runs one way on both axes: Quasar scores higher (43 against 30) and answers faster (15.3s against 18.8s).
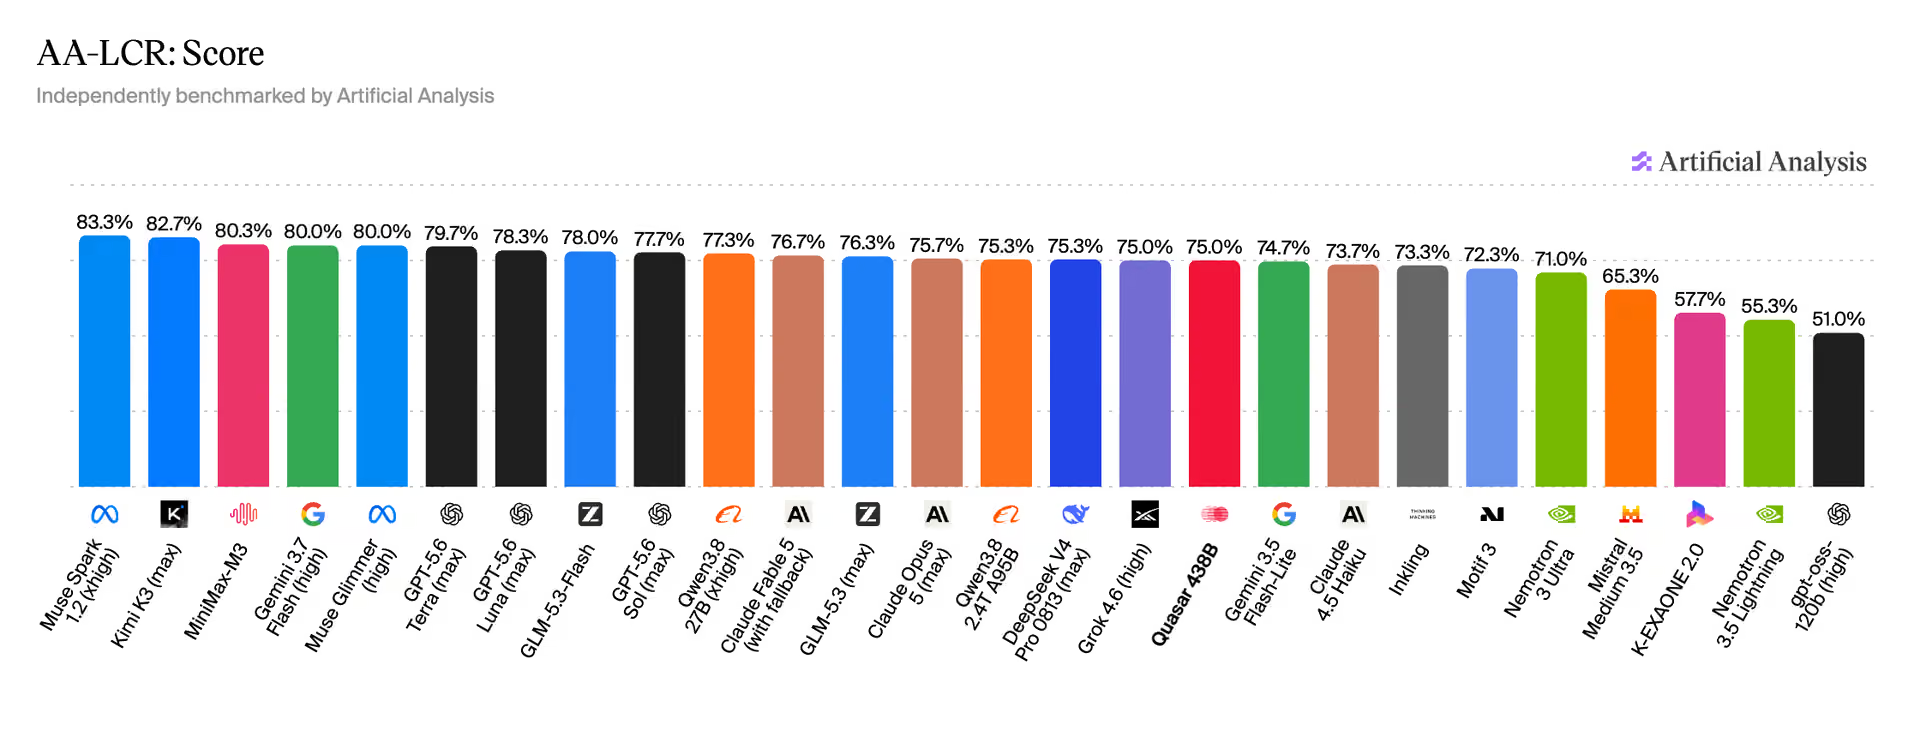
Figure 3. AA-LCR score. Higher is better.
Quasar scores 75.0 on AA-LCR, which tests the ability to extract, connect and reason over information spread across long documents. That is level with Grok 4.6 (high) at 75.0, and within a point of Claude Opus 5 at 75.7 and Qwen3.8 2.4T A95B at 75.3. It leads Nemotron 3 Ultra by 4.0 points and Mistral Medium 3.5 by 9.7.
Long-context handling is what enterprise research, document analysis and agentic workflows are built on, and it is where Quasar comes closest to the frontier group.
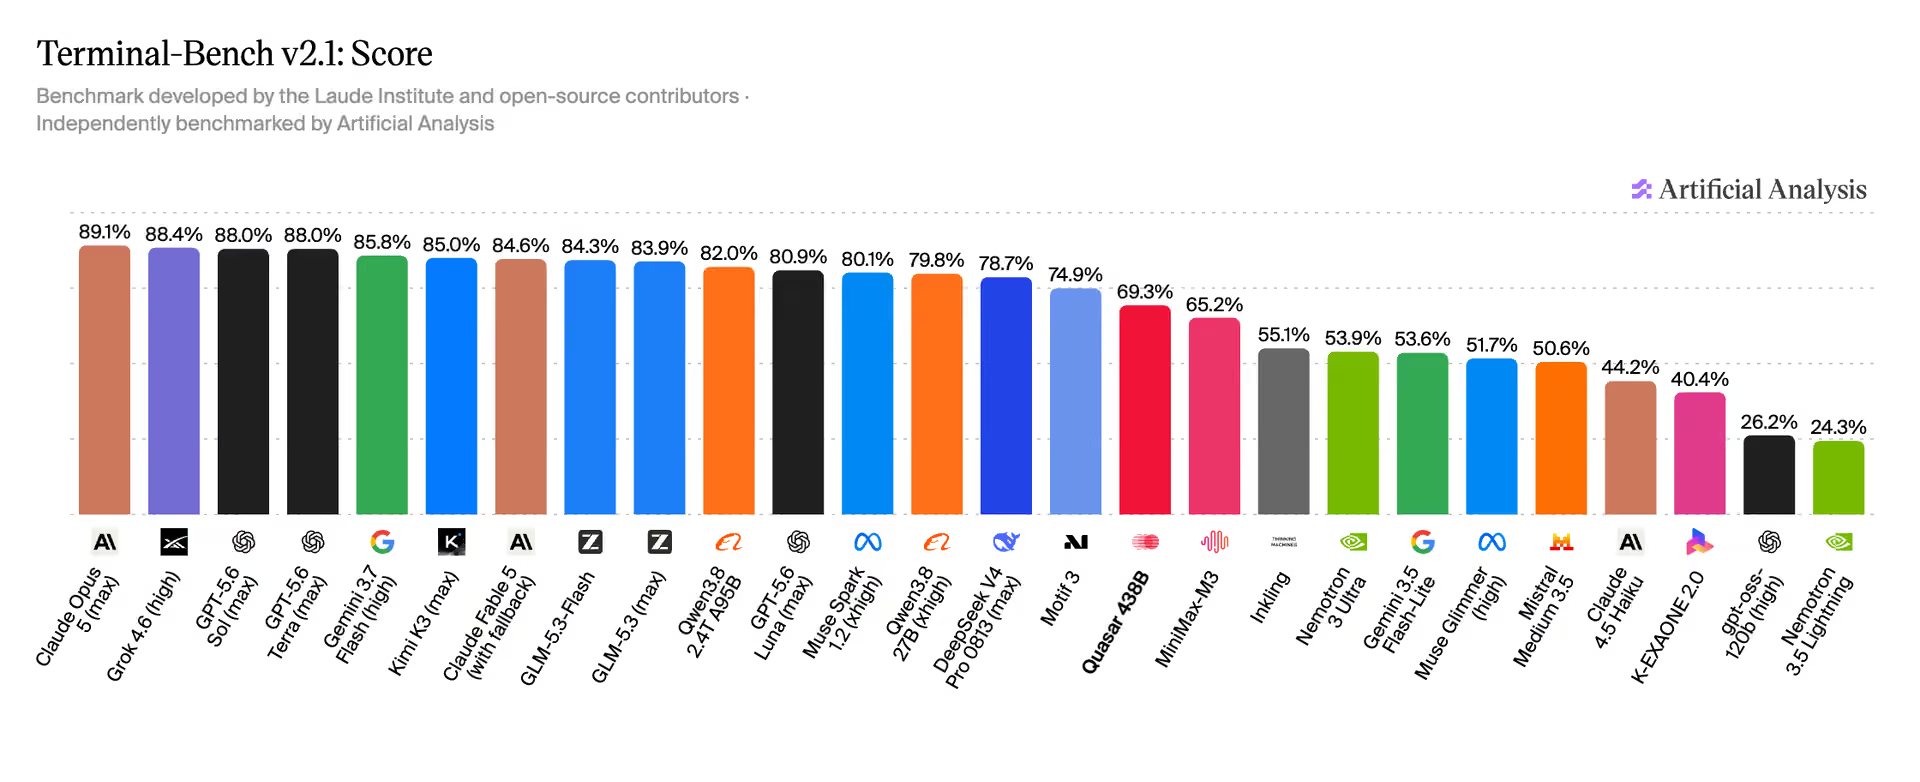
Figure 4. Terminal-Bench v2.1 score. Higher is better.
Quasar scores 69.3 on Terminal-Bench v2.1, which puts agents to work in real terminal environments. It leads Mistral Medium 3.5 by 18.7 points and Nemotron 3 Ultra by 15.4, and trails the frontier group led by Claude Opus 5 at 89.1. This is the evaluation with the most headroom for Quasar, and it is where the next round of work is aimed.
Table 1. Quasar 438B on the four supplied Artificial Analysis charts. Source: Artificial Analysis.
Built for enterprise-scale agents and coding
Quasar is built for organizations running software development agents, technical copilots, research systems and workflow automation. The Terminal-Bench and long-context results support agents that have to hold context, coordinate actions and work through multi-step tasks. The response time keeps those loops fast enough to sit inside an interactive product rather than a batch job.
Support for English and Spanish makes Quasar a practical foundation for European and international enterprises that need reasoning without narrowing deployment to a single language. Teams can put it to work across engineering, operations and knowledge work, wherever accuracy, context and reliable task completion decide the outcome.
More updates are coming for Quasar. Stay tuned.
Artificial Analysis. Check out the benchmarks:https://artificialanalysis.ai/models/quasar-438b
Contact. Reach out our team too at business@multiversecomputing.com
Reach out to us at business@multiversecomputing.com
Unlocking the Quantum AI Software Revolution.
情报判断
Aioga 编辑摘要
Multiverse Computing 发布首款大模型 Quasar 438B,定位为面向企业级智能体和编码的推理模型,支持英语和西班牙语,并可通过 CompactifAI API 进行测试。

 扫码直达文章详情