顺便提一下,在我们推出 ARC-AGI-3 之前,我们假设行动效率将继续作为人类与 AI 之间的分水岭。我们预计,即使 AI 解决了一个环境,它可能也需要比人类更多的探索(行动)。对于蛮力方法来说,这仍然是正确的,但前沿 AI 展现出更类似二进制的模式。一旦前沿 AI “理解”了机制,它通常可以在接近人类效率的范围内执行。
ARC-AGI 基准系列设计为与前沿 AI 同步发展。这在新兴研究问题与 AI 能力进步之间建立了反馈循环。ARC-AGI-3 是我们的第一个交互式基准,它要求 AI 高效综合因果世界模型并在没有具体指令的情况下实现目标。Astra 达到了这一标准。同时,ARC-AGI-3 的范围和格式都严格限定,其环境具有确定性、封闭式的机制和目标。它并不代表现实世界的复杂性和开放性。
我们正在积极探索应当塑造下一代基准的问题,包括如何评估递归自我提升和开放式创新。Astra 的进展有助于澄清哪些 AI 能力尚无法达到,以及哪些问题仍未解决。
感谢 François Chollet、Mike Knoop、Matt Mazur、Ethan Bond 和 Derek Smith 对本文的早期审阅。
开始使用并接收官方竞赛更新和新闻。
ARC-AGI-3 is a benchmark for studying agentic intelligence through novel, abstract, turn-based environments. Agents must explore, infer goals, and build internal models of environments to effectively plan actions without explicit instructions. You can play ARC-AGI-3 yourself:/tasks/ls20.
Your browser does not support embedded video.
These environments only contain core knowledge priors:https://arcprize.org/arc-agi#:~:text=towards%20general%20intelligence.-,Core%20Knowledge%20Priors,-A%20principle%20underlying and are difficulty-calibrated through controlled testing with human participants. Humans can solve 100% of the environments:/blog/arc-agi-3-human-dataset.
The goal of the ARC-AGI series is to measure the “residual gap” between current artificial intelligence and AGI. We define AGI as a system’s ability to acquire any skill a human can, as efficiently as a human can.
ARC-AGI-3 is the third generation of the ARC-AGI benchmark series:/arc-agi. It tests agentic capabilities beyond ARC-AGI-1:/arc-agi/1 and ARC-AGI-2:/arc-agi/2. Each generation expands on the one before it - as frontier AI capabilities advance, our benchmarks must advance with them.
ARC-AGI-3 tests four components of agentic intelligence:
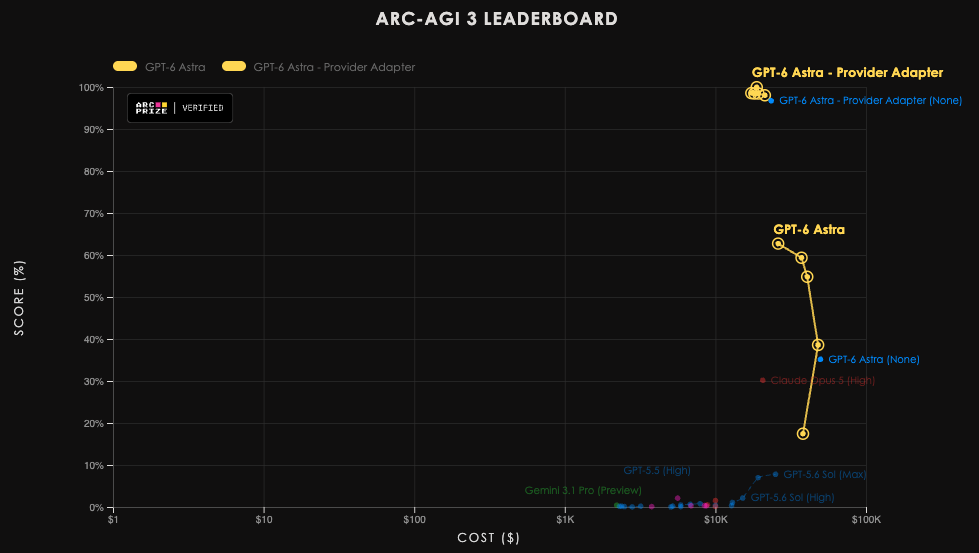
With our Standard harness Standard harness enables a model to carry forward notes it chooses to keep with it throughout the environment. , OpenAI’s Astra (max) scores 62.7% on ARC-AGI-3 Semi-Private:/results/openai-gpt-6-astra for $26K. With the Provider Adapter harness The Provider Adapter harness preserves opaque reasoning state between requests and uses compaction for longer conversations, allowing the model to reuse prior work. , Astra (high) scores 99.9% for $19K. Both are state-of-the-art scores. See the full leaderboard:/leaderboard.
At max reasoning effort, Astra solves games more efficiently, requiring fewer actions and therefore lowering total cost relative to the other reasoning-effort levels.
For a cost comparison, during our controlled testing, human participants were paid $115 per 90-minute session, plus $5 per game completed. Participants attempted approximately nine games per session, roughly $12.78 per attempted game before bonuses.
Most of this fee pays for the participant’s time and willingness to take the test, rather than the energy their brain uses (a closer proxy to compare with AI). If we look at only the brain’s energy, and price it as electricity, the estimate drops to about 0.6 cents per session, or 0.067 cents per game attempted. 1:#fn-1
Beyond the scores, Astra’s replays show how it turns unfamiliar game mechanics into useful working models. Three findings stood out: the compact algebraic notation it develops, its action efficiency compared with humans, and the custom tools it builds.
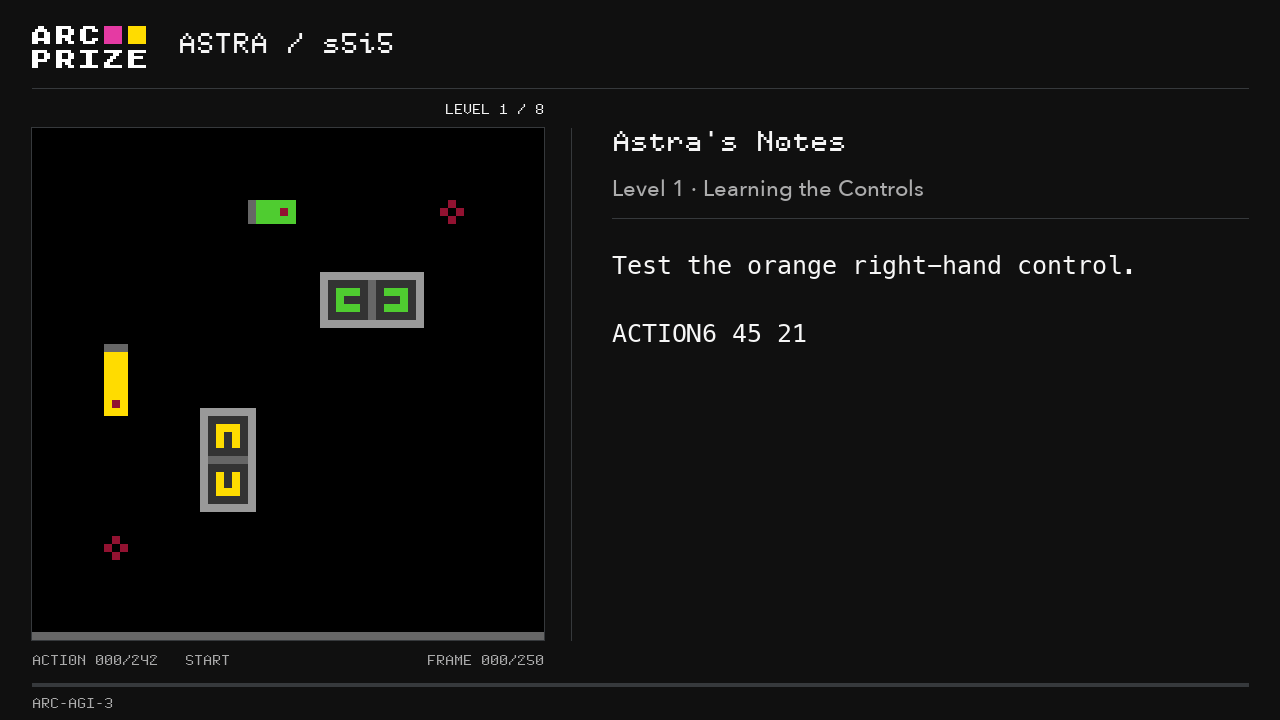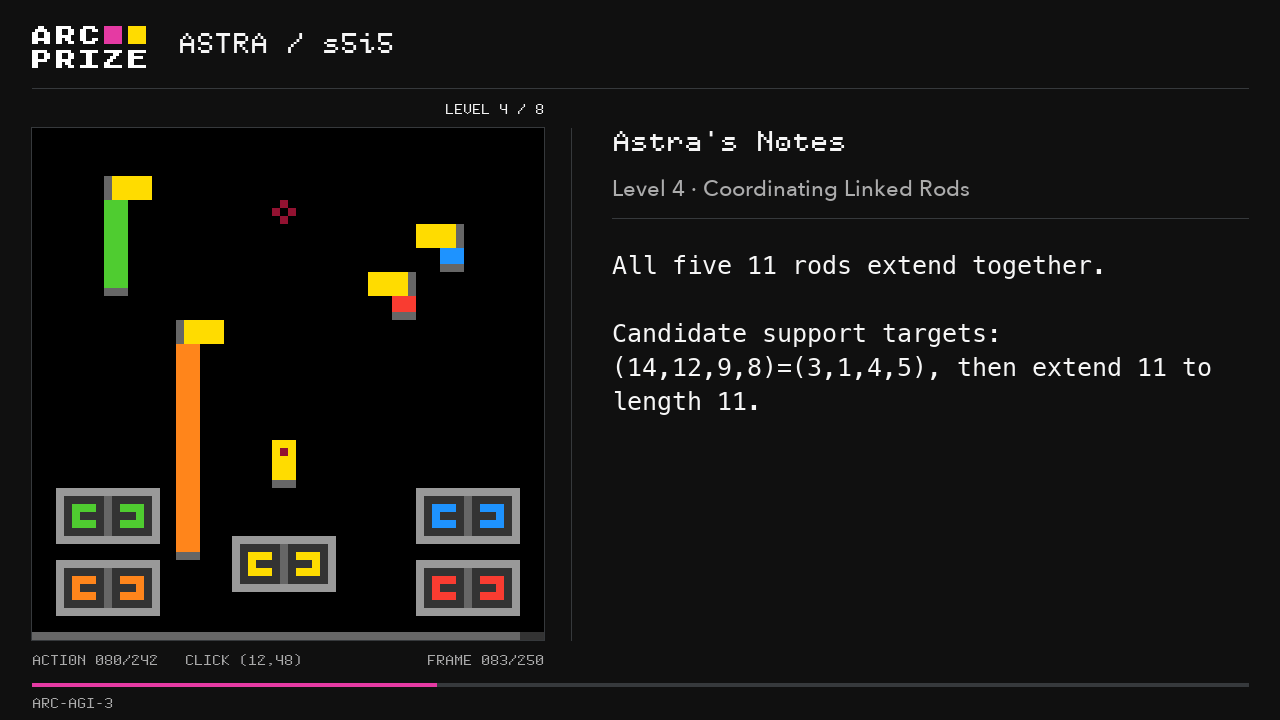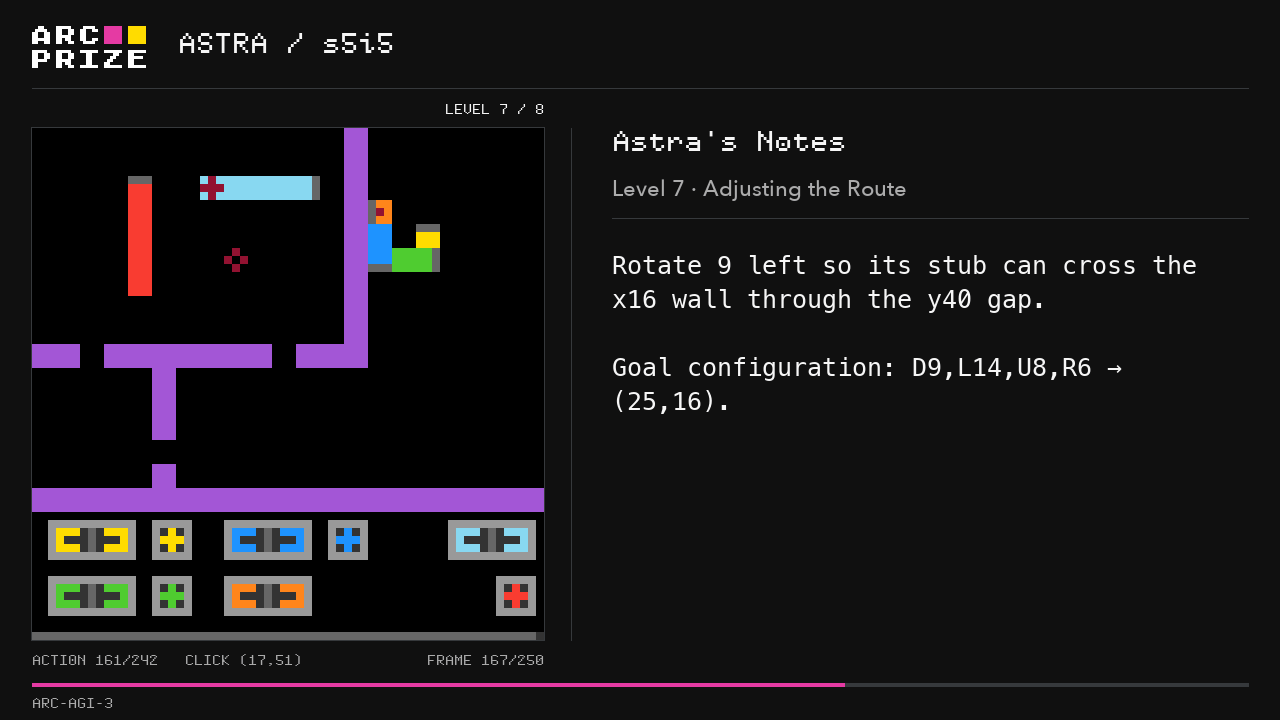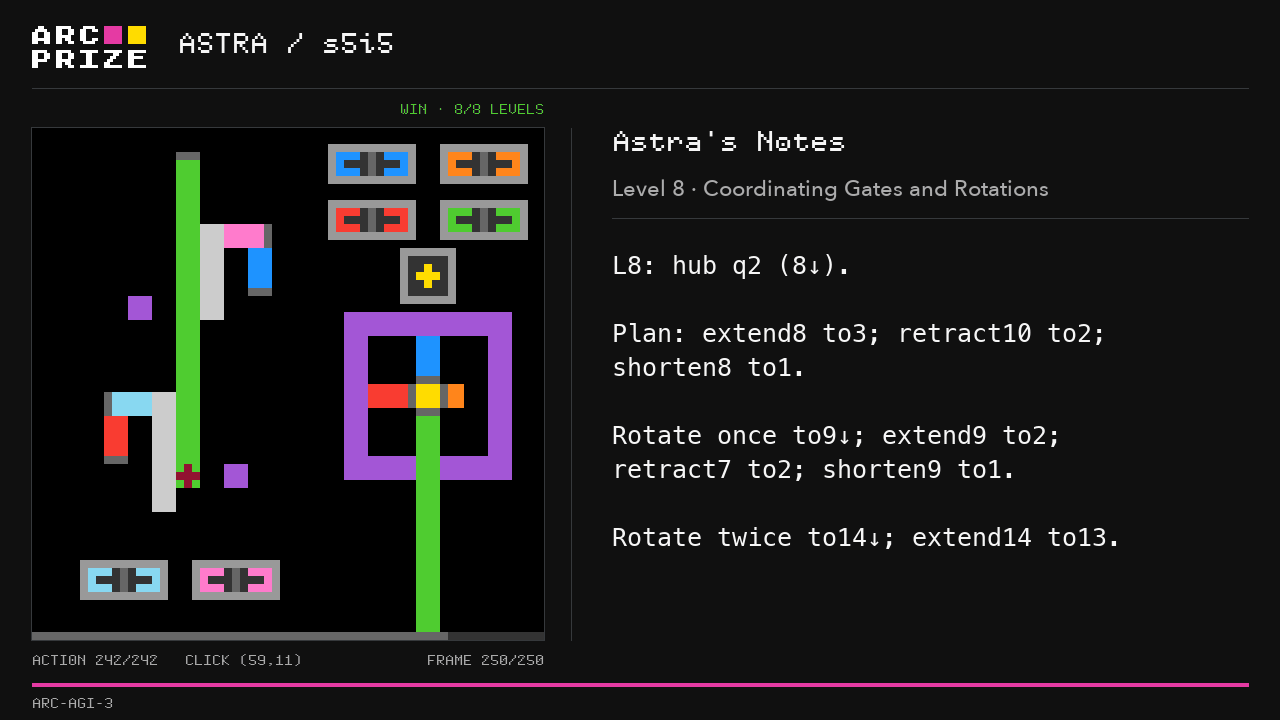
When playing ARC-AGI-3, Astra chooses which strategy notes it would like to carry forward. It tracked objects, coordinates, rules, and unfinished plans, while also using a custom domain-specific language notation it generated for the environments.
We’ve seen similar behavior in other models:https://x.com/arcprize/status/2080716567760007317, but Astra’s notes stood out for their precision and information density. It distilled the scene into a compact code-like symbolic model: where objects were, how they interacted, and exactly which actions needed to happen in what order. This is an on-the-fly algebraic shorthand rather than a fully fledged programming language. For example:
Before launching ARC-AGI-3, we tested approximately 500 members of the general public to establish a human baseline for action efficiency, or simply, how quickly did people solve each environment. Participants were not selected for puzzle-solving experience or ability. 2:#fn-2
For each level, we defined the “human baseline” using the median action count among players who completed it. This gives us a reference for comparing human and AI performance. An AI that needs more actions is less action-efficient, while one that needs fewer actions is more action-efficient.
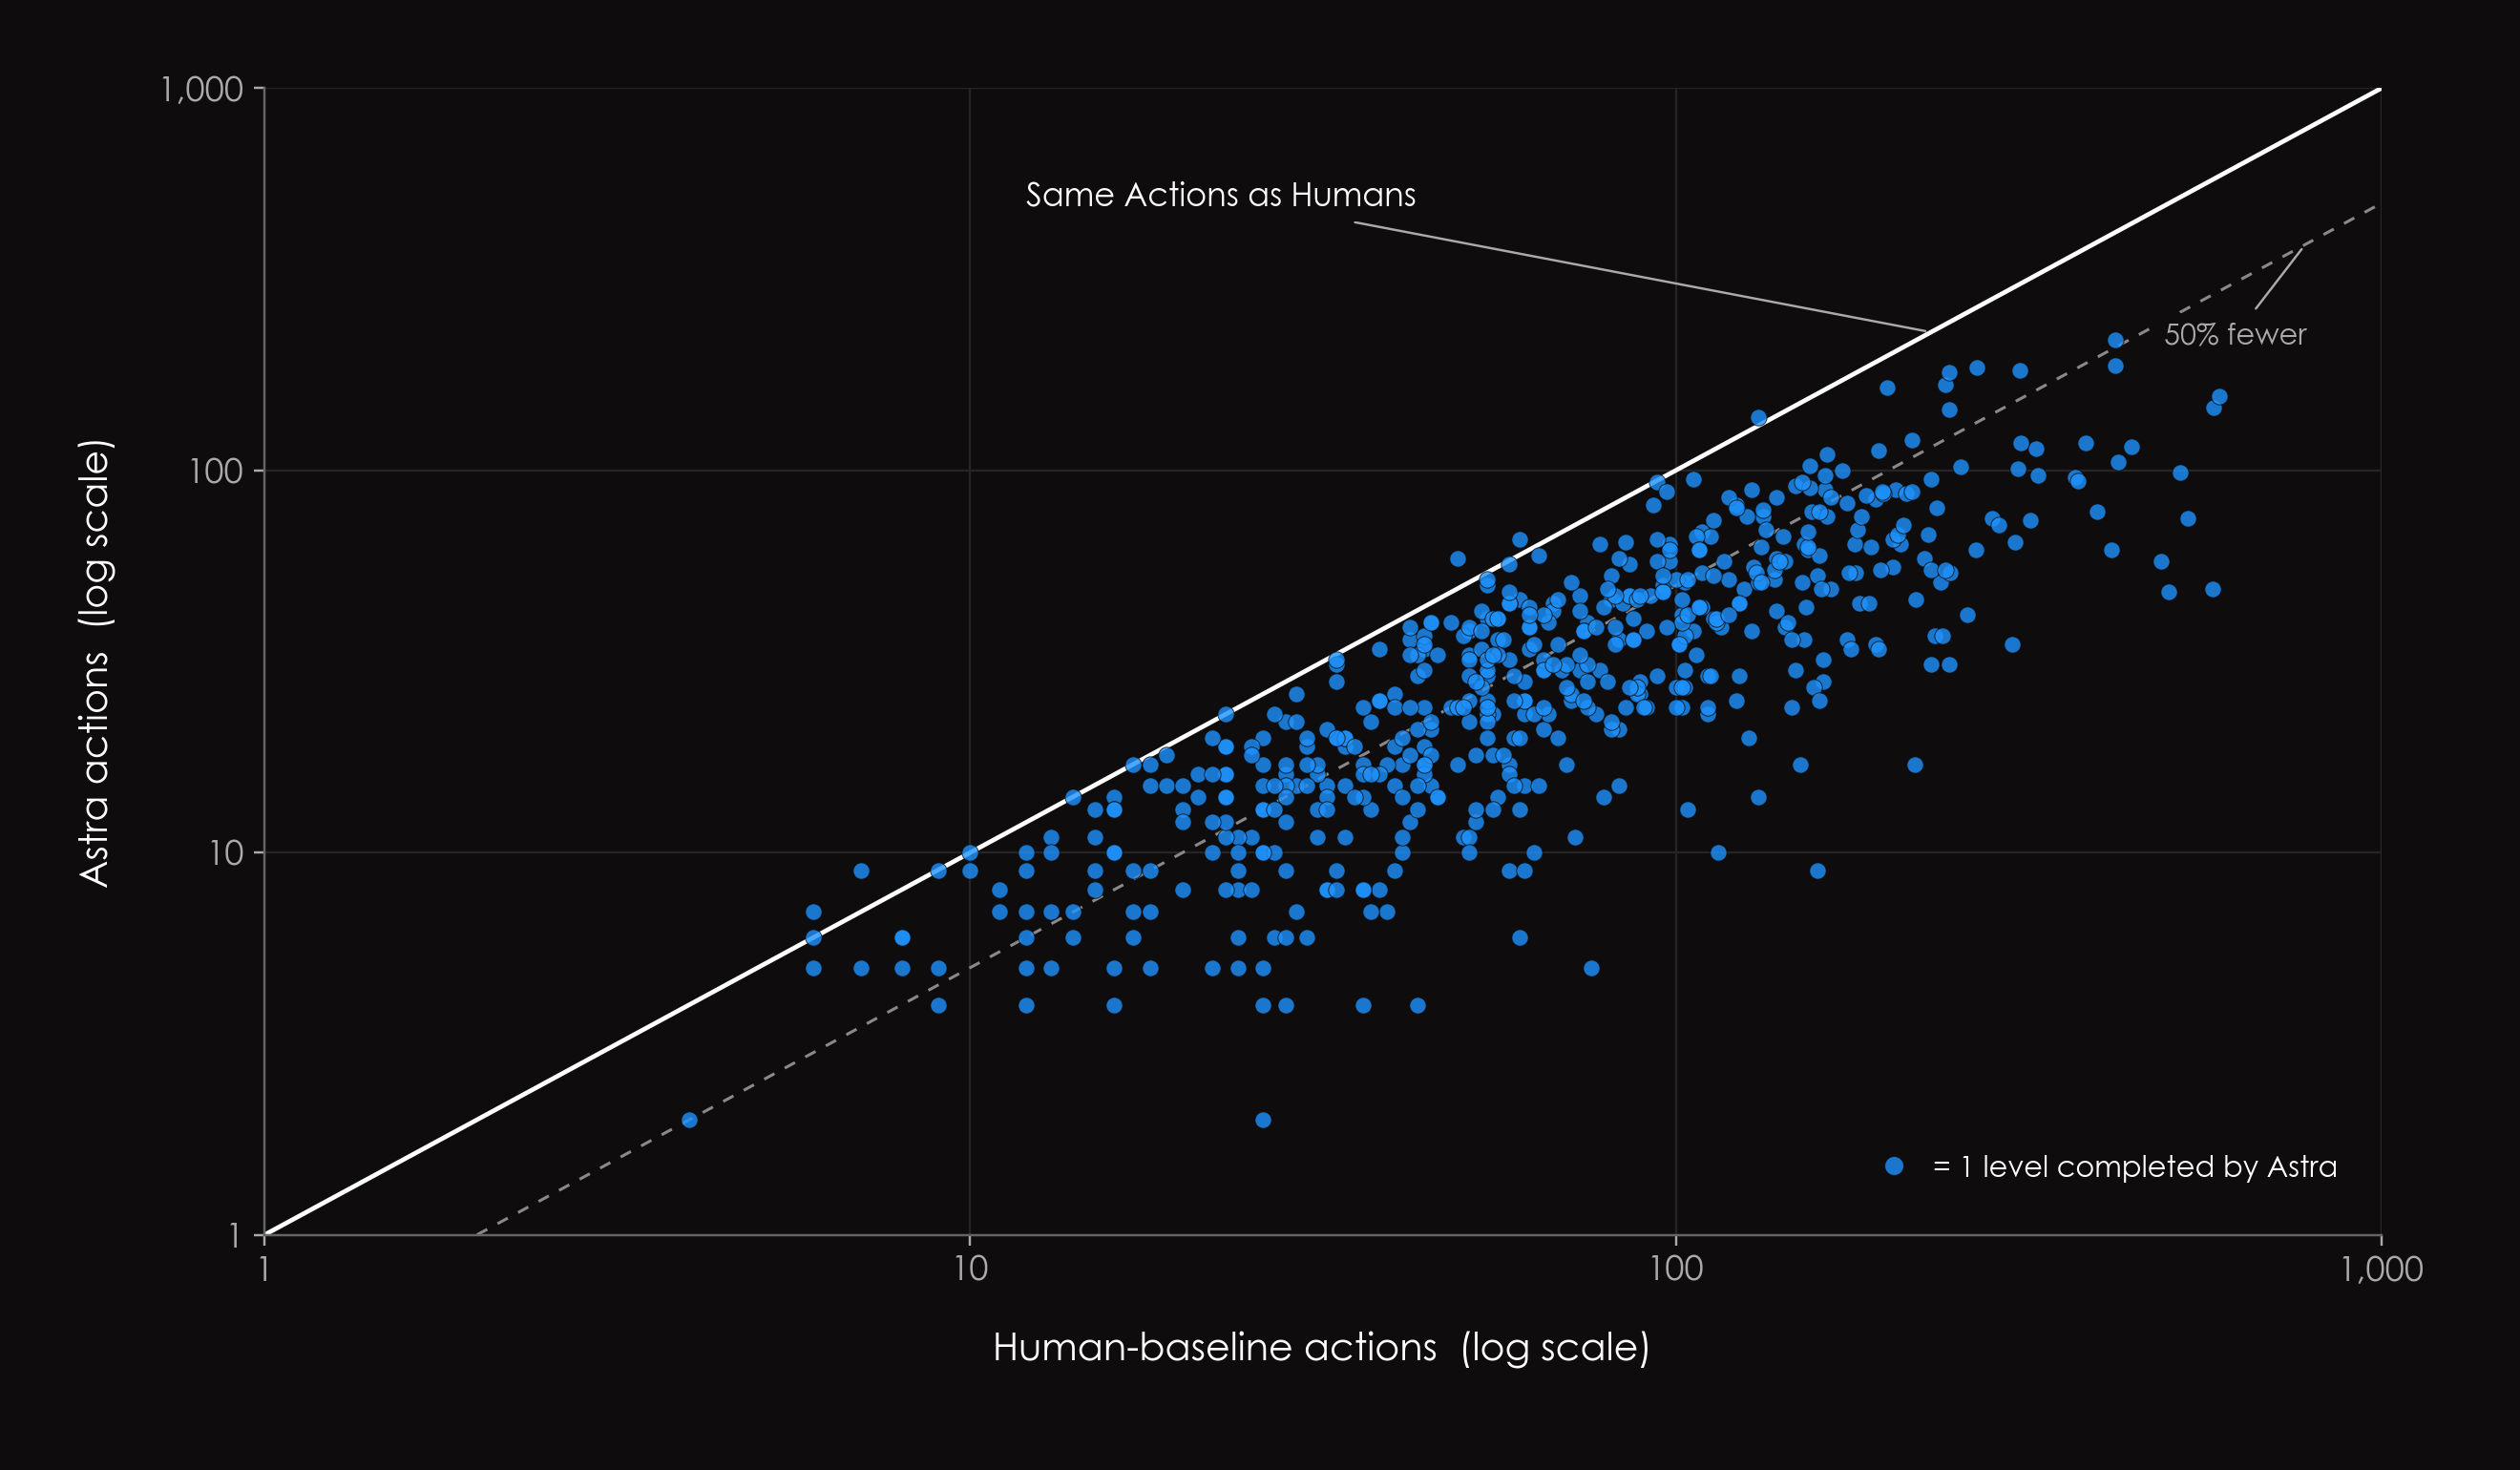
In the Provider Adapter harness The Provider Adapter harness preserves opaque reasoning state between requests and uses compaction for longer conversations, allowing the model to reuse prior work. , Astra (max) used fewer actions than the human baseline on 96.0% of levels and used 51.7% fewer actions per level on average . This is a material milestone. This means by ARC-AGI-3’s measure of action efficiency, Astra matched and surpassed human parity.
As an aside, before we launched ARC-AGI-3, we hypothesized that action efficiency would remain a dividing line between humans and AI. We anticipated that even when an AI solved an environment, it might require substantially more exploration (actions) than a person. That remains true of brute-force approaches, but frontier AI shows a more binary-like pattern. Once frontier AI “understands” the mechanics, it generally executes within the range of human efficiency.
Astra’s Action Efficiency Compared to Humans
Each dot represents one level that Astra (max) completed. Points below the solid line indicate fewer actions than the human baseline.
The plot above compares the number of actions Astra used to complete each level with our human baseline. This reinforces why ARC-AGI-3 measures action efficiency, not just task completion. A completion-only score would tell us that Astra completed an environment, but not how efficiently it learned to solve them.
Most benchmarks only measure cost efficiency, which measures the computational resources used, but action efficiency measures how much experience with an environment was required.
Astra’s results show that it needed fewer interactions than the human baseline to execute a solution.
We also evaluated Astra in the PRO-LONG harness:https://github.com/alexisfox7/PRO-LONG (paper:https://arxiv.org/pdf/2607.20064), an early ARC-AGI-3 red-teaming partner. In this advanced setup, Astra had access to a sandbox where it could execute custom code 3:#fn-3 .
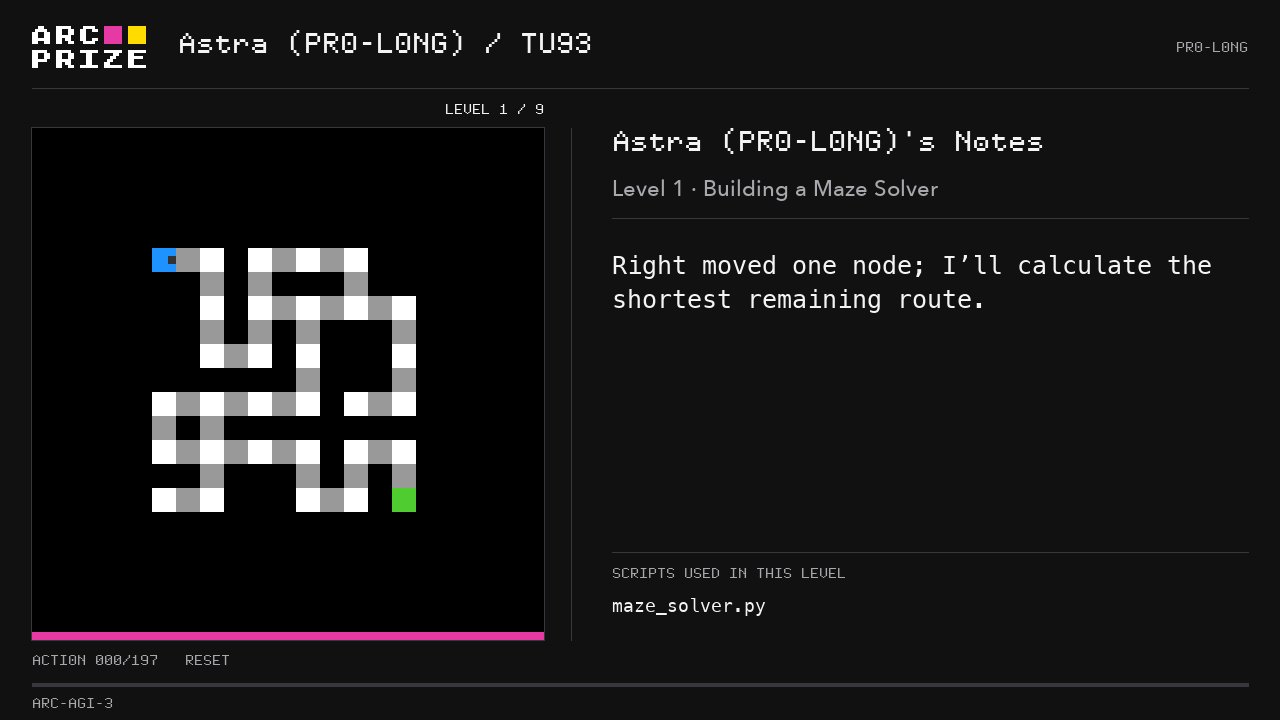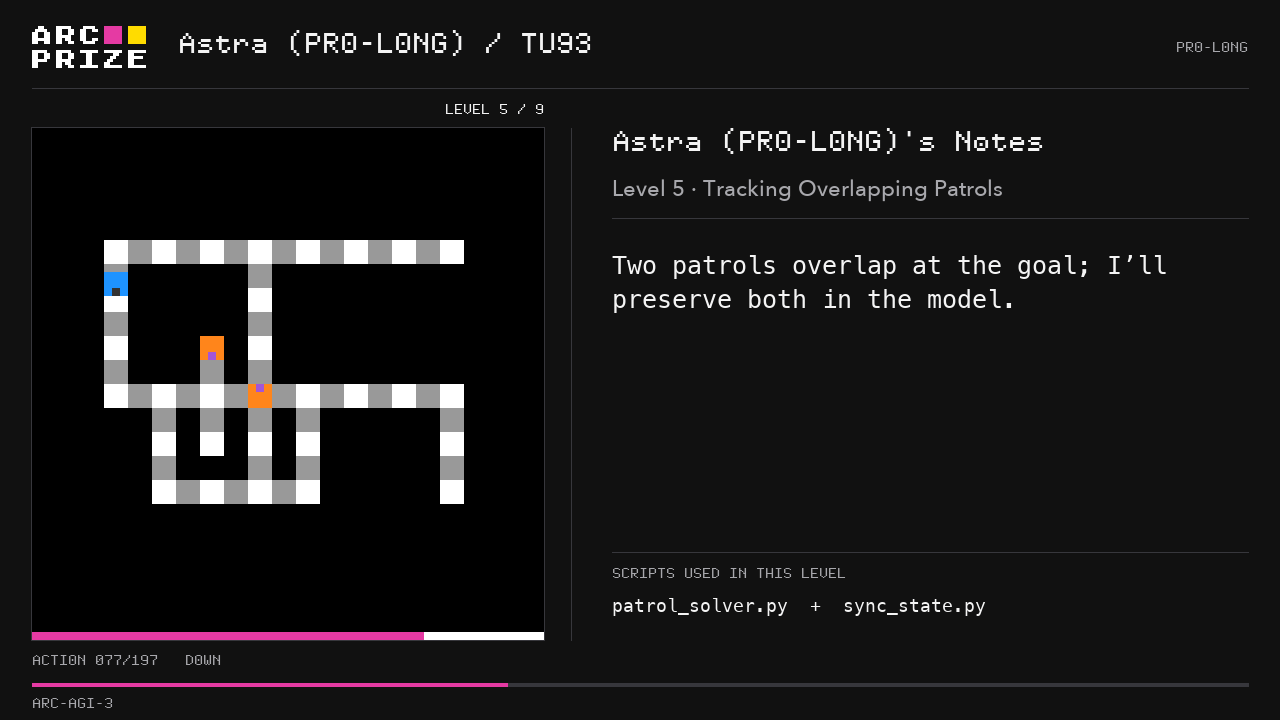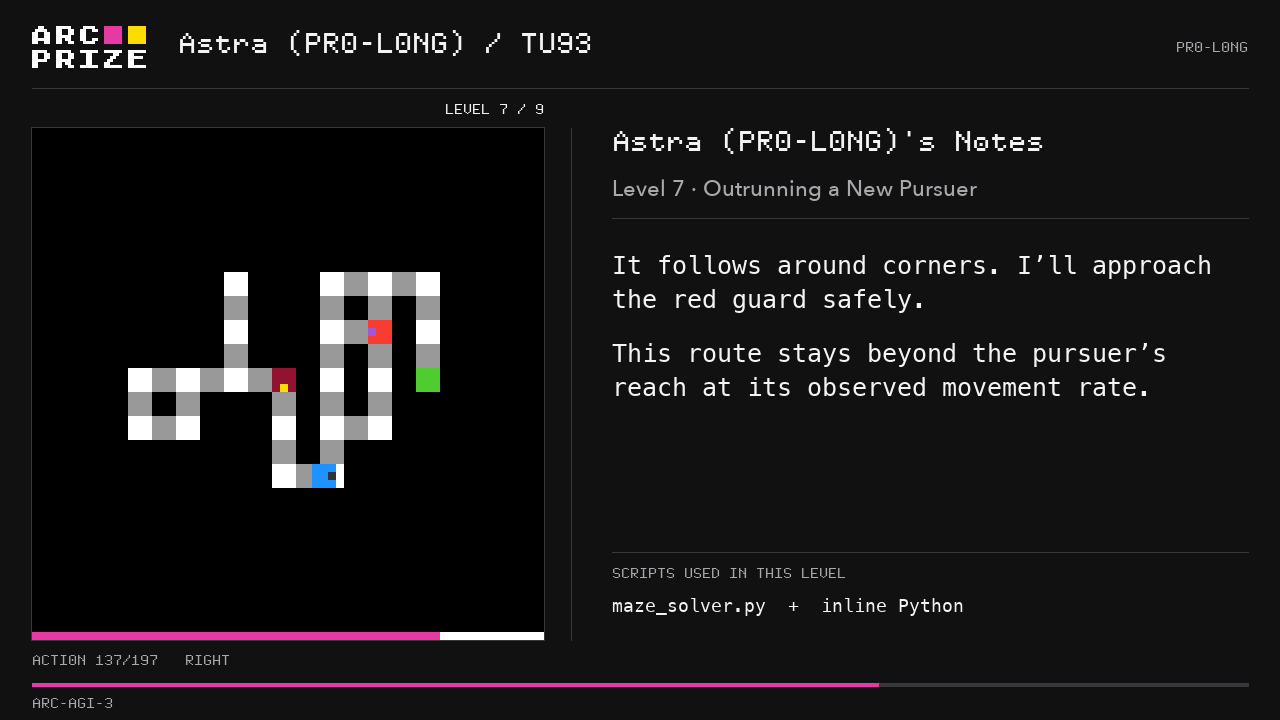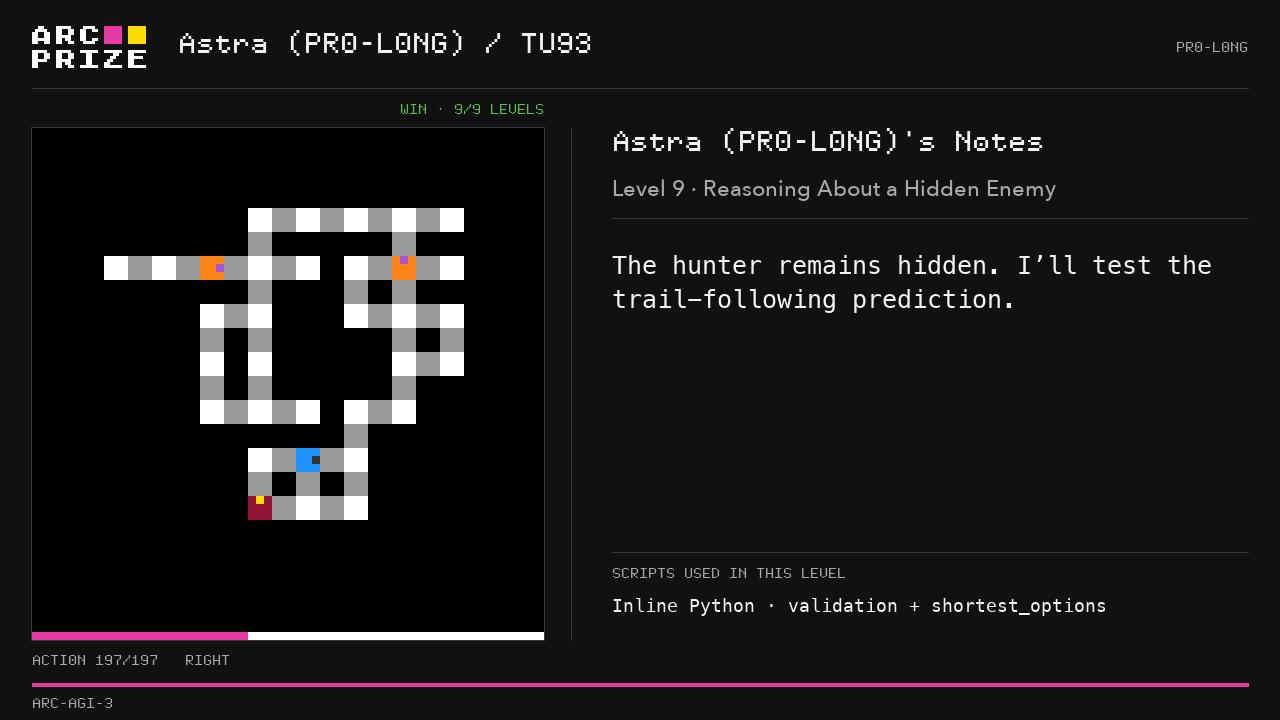
We observed Astra create a custom set of tools for each game: board parsers, game-state models, search algorithms, planners, and persistent notes. For more involved runs, Astra even produced small, game-specific software libraries.
For example, in tu93 :/tasks/tu93, a maze-like game with guards and moving patrols, Astra started with navigation and built maze_solver.py . It added combat rules in combat_solver.py , modeled moving patrols in patrol_solver.py , and used sync_state.py to check its predictions against observations.
Examining Astra’s performance in PRO-LONG is useful because we see what it can do with external tools. However, this represents different evaluation conditions from our controlled human testing. Our testing participants did not have a code interpreter, scratch pad, etc., so PRO-LONG’s results should be understood as the combined performance of the model and its tools.
Our Standard harness for ARC-AGI-3 asks how models compare under the same minimal, provider-neutral interface. It provides all the information required to solve each game, but leaves the model responsible for deciding what to preserve in its visible notes. We believe a future AGI should be able to solve ARC-AGI-3 under these conditions. The shared interface also gives us a consistent, apples-to-apples comparison across providers.
Alternatively, there is a separate question: how well does a model perform when it can use the context-management features its provider designed for it? For Astra, this means preserving the opaque reasoning state (which we don’t see) between requests and using compaction to manage longer conversations.
With the Provider Adapter harness, Astra's best observed score on ARC-AGI-3 Semi-Private increased from 62.7% to 99.9%. Looking across Public and Semi-Private and all reasoning levels, Provider Adapter runs were approximately 3.66x faster by aggregate recorded elapsed time and used 49% fewer total tokens across the 167 game-reasoning pairs both harnesses solved.
Going forward, we will report both Standard harness and Provider Adapter harness results on the ARC-AGI leaderboard, with each evaluation condition clearly labeled. Our open-source testing repository:https://github.com/arcprize/arc-agi-3-benchmarking and testing policy:/policy document both approaches.
ARC-AGI-3 continues to be a useful playground for researchers and agents to explore unfamiliar environments, discover rules, and learn through interaction. Astra’s results are also a major milestone worth celebrating. From our perspective, Astra represents a noticeable step-function change in frontier model capabilities.
When we launched ARC-AGI-3, we made it clear:https://arxiv.org/pdf/2603.24621 that saturating the benchmark would not represent “proof of achieving AGI.” Therefore, while we believe Astra represents meaningful progress towards generalization, we are not claiming that it is AGI.
The ARC-AGI benchmark series is designed to evolve in tandem with frontier AI. This creates a feedback loop between emerging research questions and advances in AI capabilities. ARC-AGI-3 was our first interactive benchmark, which asked AI to efficiently synthesize causal world models and achieve goals without specific instructions. Astra clears this bar. At the same time, ARC-AGI-3 has a tightly bounded scope and format, and its environments have deterministic, closed-ended mechanics and goals. It does not represent the complexity and open-endedness of the real world.
We are actively exploring the questions that should shape the next generation of benchmarks, including how to evaluate recursive self-improvement and open-ended innovation. Astra’s progress helps clarify which AI capabilities are out of reach and which questions remain open.
Thank you to François Chollet, Mike Knoop, Matt Mazur, Ethan Bond, and Derek Smith for early review of this post.
Get started and receive official contest updates and news.

 扫码直达文章详情