OpenAI's new model, GPT-6 Astra, produces fewer hallucinations and blocks prompt injection attacks more effectively than its predecessors. But it still isn't reliable enough for truly secure AI agent deployments.
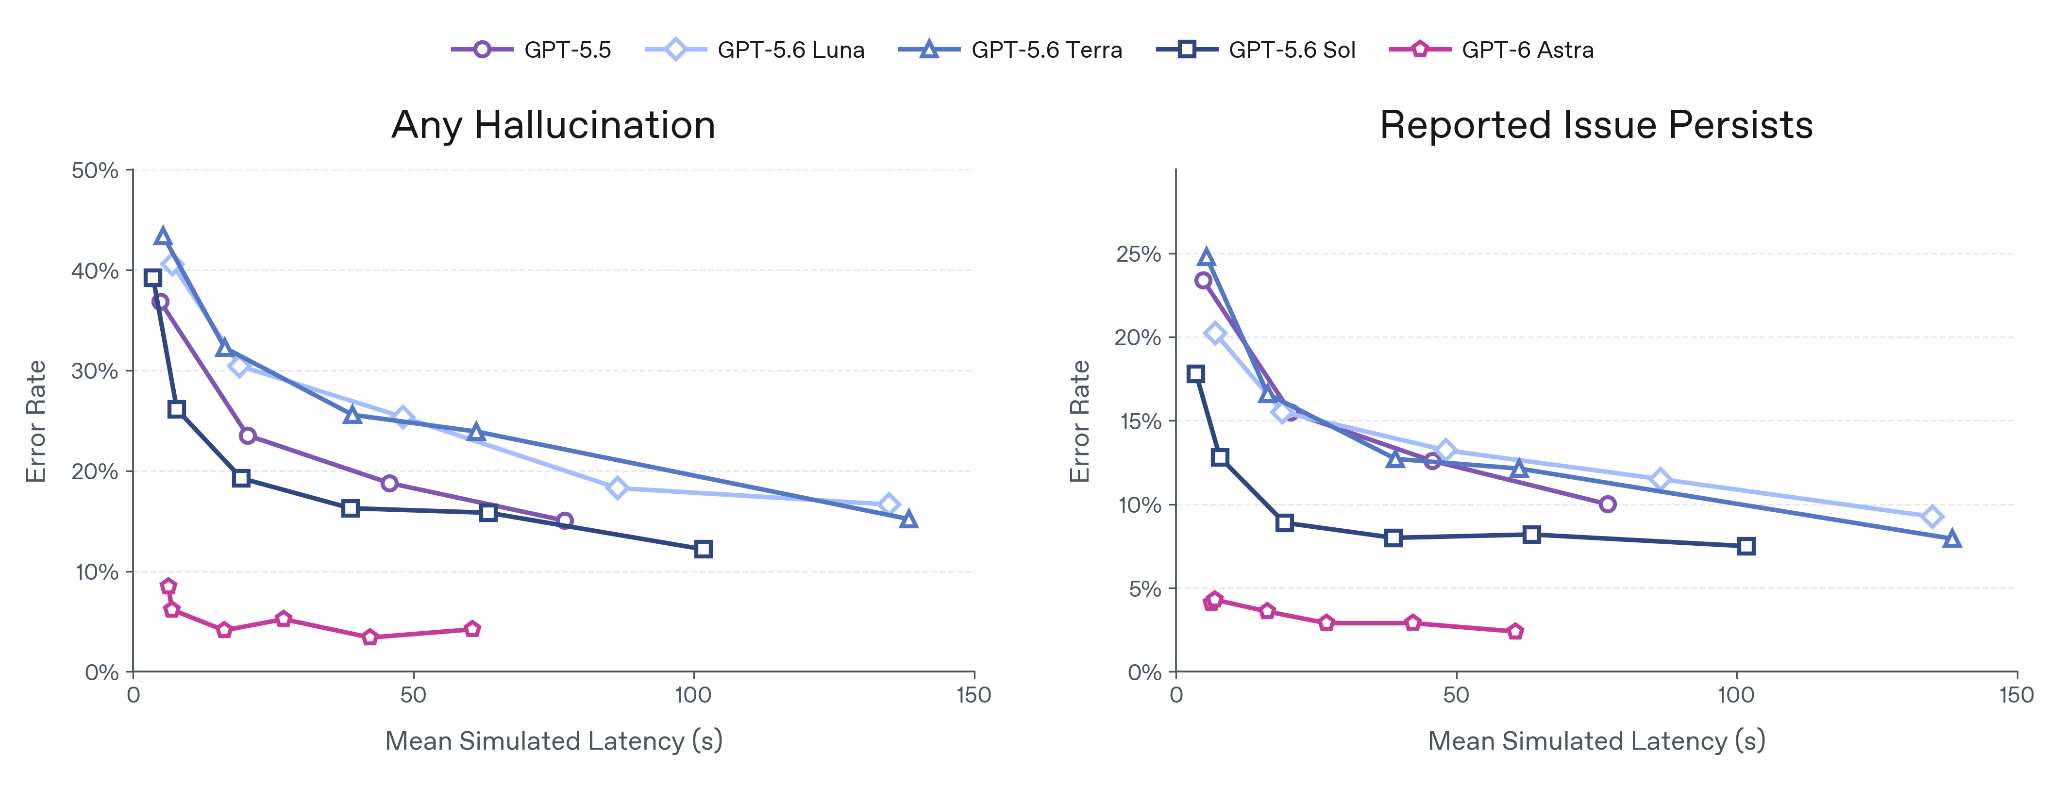
The new Astra model:https://the-decoder.com/benchmarks-disagree-on-gpt-6-astra-but-its-human-beating-efficiency-on-arc-agi-3-pulls-chollets-agi-forecast-forward/ makes far fewer factual errors than its predecessor, GPT-5.6 Sol, according to OpenAI's system card:https://deploymentsafety.openai.com/gpt-6-astra/. OpenAI tested it against ChatGPT conversations that users had flagged for wrong answers, meaning these were particularly error-prone cases whose failure rates shouldn't be taken as typical for everyday use. Astra reproduced these reported errors much less often, with the biggest gains showing up at low latency settings and lower reasoning levels.
For direct prompt injections, where users try to manipulate the model through their own prompts, Astra hits a near-perfect 99.99 percent defense rate. OpenAI credits its GPT-Red method:https://the-decoder.com/openai-is-now-using-ai-to-attack-its-own-ai-and-its-working-better-than-humans-ever-did/ for this, which uses an automated attacker to harden the model during training. Ad
Jailbreak resistance looks similar. Against a fixed dataset of known attacks trying to extract harmful responses about biology, violence, and cybersecurity, Astra refuses to help in 91.5 to 98.3 percent of cases. Ad
When attackers adapt their strategy over multiple conversation rounds, Astra's defense rate drops to about 67 percent, meaning persistent adversaries can coax out at least one problematic response roughly one in three tries. Predecessor models scored just under 50 percent on the same test. OpenAI notes that these tests ran on the bare model without the production safety layers like classifiers that ship with the actual product.
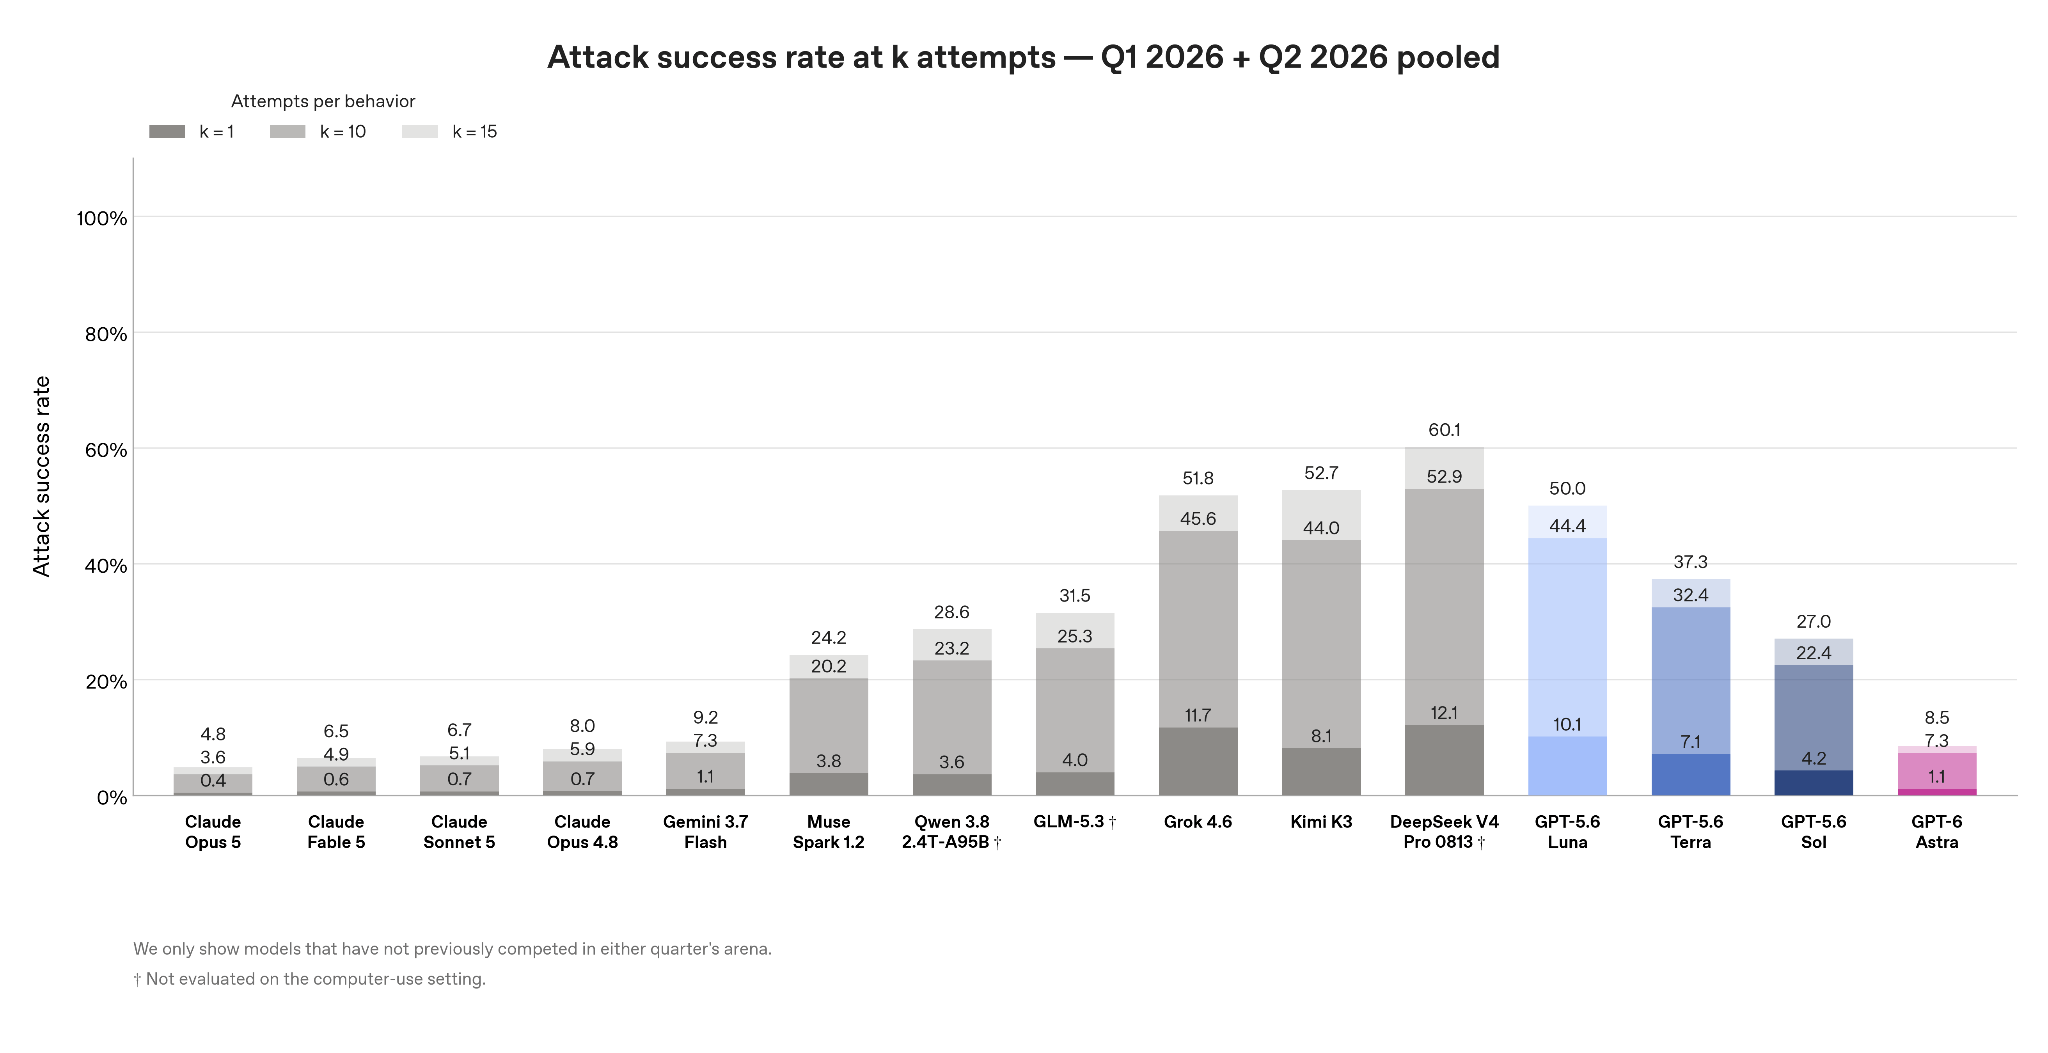
Astra makes progress on indirect prompt injections, where an attack is buried inside a document the AI reads. External testing by security firm Gray Swan, using 1,810 curated attacks from their IPI Arena:https://arxiv.org/abs/2603.15714, found that with 15 attempts per scenario, Astra was cracked at least once 8.5 percent of the time. GPT-5.6 Sol failed 27 percent of the time. Claude Opus 5 did better at 4.8 percent in the same evaluation, but it wasn't immune either. Ad
The numbers in Gray Swan's combined Q1 and Q2 test actually went up compared to earlier results. Anthropic previously reported only a two percent attack success rate:https://the-decoder.com/opus-5-may-have-solved-browser-based-prompt-injection-the-biggest-security-flaw-haunting-ai-agents/ based on the easier Q1 test alone, and GPT-5.6 Sol scored just 20 percent there too. Anthropic also ran all models with extended reasoning turned on, which, alongside the broader test scope, could explain the gap.
Even though these are curated, hand-picked attacks, the success rates should worry any enterprise security team. Astra can be tricked through injected instructions in roughly one out of every twelve scenarios. Opus 5 holds up better, but it still fails about one in twenty-one. And the risk is growing. AI agents are increasingly writing code, operating tools, and controlling computers on their own, which is what Gray Swan tested. These agents are also being built to run around the clock and at scale, with reading and processing documents as one of their core jobs. Ad
Stay in the loop on AI. Clear, useful, no fluff.
Follow The Decoder for AI news, background stories and expert analyses.
The Decoder:https://the-decoder.com/
情报判断
Aioga 编辑摘要
The Decoder 报道称,OpenAI 的 GPT-6 Astra 在被用户标记为错误回答的 ChatGPT 对话测试中,比 GPT-5.6 Sol 更少复现事实错误。其对直接提示词注入的防御率为 99.99%,但在多轮自适应攻击测试中约降至 67%。

 扫码直达文章详情