How much GPU RAM do you actually need to run Qwen3.8 27B without sacrificing quality?
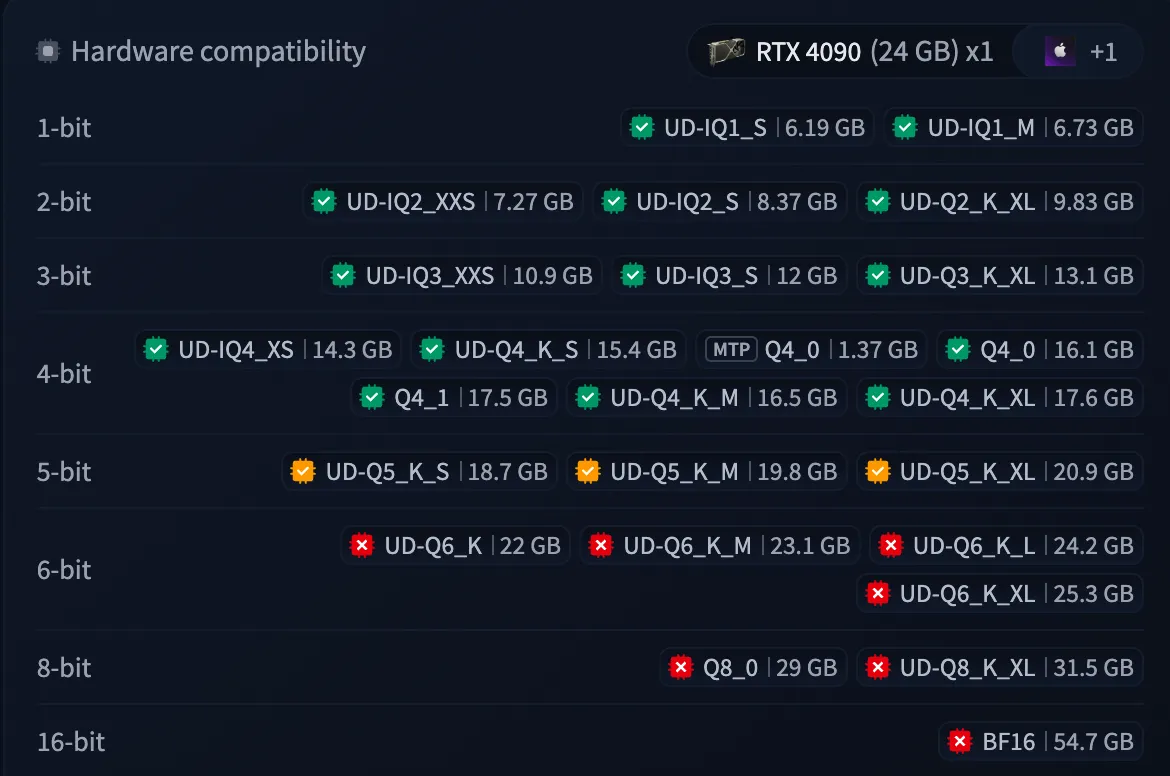
The full BF16 model weighs 55 GB, putting it beyond most consumer hardware. Yet the 17 GB Q4_K_M matches the full model on a popular agentic coding benchmark, Terminal-Bench 2.1. It fits on a 24 GB card such as RTX 4090, still leaving room for about 64k tokens of context.
Compression eventually hits a cliff. At 1 bit, the model performs around random chance on GPQA Diamond, and longer reasoning makes it worse.
Qwen3.8 27B GGUF quantizations available from Unsloth on Hugging Face . So much to choose from! I will check 8-bit Q8_0 (29 GB), 4-bit Q4_K_M (17 GB), 2-bit UD-Q2_K_XL (10.7 GB), and the smallest one possible, 1-bit UD-IQ1_S (6.2 GB).
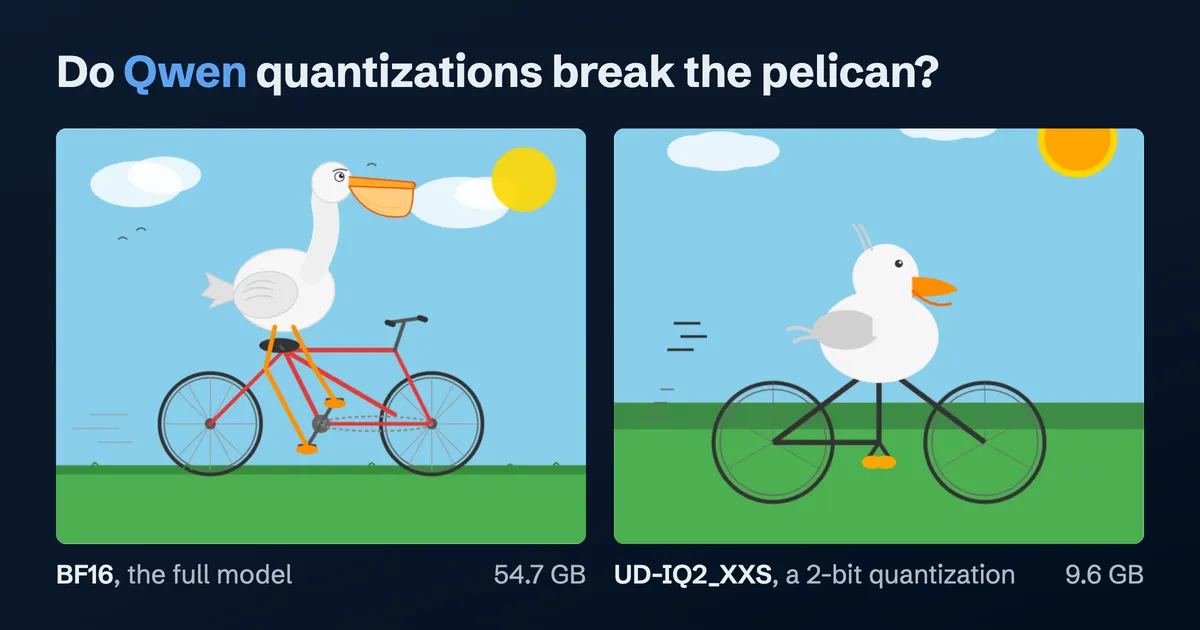
Previously, I investigated the Qwen3.6 27B model, which was good at generating SVG pelicans even at 12GB:https://quesma.com/blog/qwen-quantization-quality/, and maintained most of its knowledge up to 16GB:https://quesma.com/blog/quantization-hurts-knowledge/. At the same time, in Reddit threads, many complain that all quantizations, even the 8-bit ones, give worse results - with people asking why your local LLM feels dumber than it is:https://forum.level1techs.com/t/why-your-local-llm-feels-dumber-than-it-is/253917. Are these complaints grounded?
Measuring token prediction differences (KL-divergence, top-1 predictions) is easy, but it does not tell us whether the model gets worse at solving tasks. Some noise might be irrelevant for solving tasks, as (say) a quantized model generates an answer of precisely the same quality, paraphrased a bit. In other cases, a single different token might be a logical error, or even abruptly end the output.
So, I focus on directly measuring results on popular benchmarks - GPQA Diamond:https://artificialanalysis.ai/evaluations/gpqa-diamond, instruction-following IFBench:https://github.com/allenai/IFBench, programming Terminal-Bench 2.1:https://www.tbench.ai/leaderboard/terminal-bench/2.1. First, to replicate official results of the full model BF16 , and then to see how quantization affects results.
I burned around $3,000 on Modal:https://modal.com/ GPUs when I ran models with llama.cpp:https://github.com/ggml-org/llama.cpp using a build from 16 August 2026 as earlier builds do not work for this model:https://www.paulsprogrammingnotes.com/2026/08/running-qwen-3-8-27b-16gb.html. I could have run it on my own laptop, in principle, but (unlike pelican-generation), these are time-consuming benchmarks.
Note that I use F16 KV-cache regardless of model quantization, weighing around 2.3 GB per 32k tokens.
I used Unsloth quantizations:https://huggingface.co/unsloth/Qwen3.8-27B-GGUF: v2 for the 2-, 4-, and 8-bit models, and v3:https://unsloth.ai/docs/basics/dynamic-3.0-ggufs for the 1-bit models. Unsloth replaced the v2 files on 19 August 2026:https://huggingface.co/unsloth/Qwen3.8-27B-GGUF/discussions/74, so the exact files used for most tests are no longer available.
In short, if you go with a 4-bit quantization Q4_K_M (17GB), you won’t notice a difference on these benchmarks. At the same time, the effort setting matters a lot (note that the default is xhigh ) - and it is a tricky choice, as it can overthink:https://simonwillison.net/2026/Aug/16/qwen-38-27b/.
The easiest ones are one-shot tests: in this case, graduate-level science GPQA Diamond and instruction-following IFBench. I run each at three reasoning efforts: low , medium , and the default xhigh .
First and foremost, I was happy I replicated the official results. Running benchmarks is hard; there are many hidden settings or assumptions that can change the results drastically. Here, on the first go, results were as reported by Qwen.
Second, besides noise (bars are Wilson 95% confidence intervals:https://en.wikipedia.org/wiki/Binomial_proportion_confidence_interval#Wilson_score_interval, very conservative for run-to-run noise), there is little difference down to 4-bit; only the 2-bit scores a bit lower.
At the same time, thinking level changed the score dractically. The best results, for xhigh , needed around 8k reasoning tokens.
Here, to my great surprise, there is no change between models, down to a decent 2-bit one, weighing less than 11 GB. Yet, context is even lower, around 4k tokens.
How does it work for programming? Terminal-Bench 2.1 is a standard agentic benchmark, with 89 tasks. Here I use 3h timeout, xhigh effort. I reserve 98k context.
Not only does my measurement of BF16 replicate the stated result, but, to my surprise, Q4_K_M does as well. I accidentally skipped running Q8_0 ; yet, in this case, I can safely interpolate between 4-bit and the full model’s values. Running it would be both costly and unnecessary (and would exceed an informal blog post’s budget). Only at 2-bit UD-Q2_K_XL things break a bit. A noticeable fall, but still the level of Opus 4.7 or Gemini 3.1 Pro:https://www.tbench.ai/leaderboard/terminal-bench/2.1?lf=%7B%22agent_display%22:%7B%22kind%22:%22categorical%22,%22values%22:%5B%22Terminus+2%22%5D%7D%7D. Again, far from frontier, but also - far from useless.
Results are one thing, but what about the process? Do smaller models need more turns, tokens or time to get the result?
On the same solved tasks, UD-Q2_K_XL takes as many turns as BF16 but writes about a quarter more tokens. The number of turns stay roughly the same.
Quality drops off a cliff at 1-bit. As with knowledge:https://quesma.com/blog/quantization-hurts-knowledge/, quantization damage is nonlinear: first there is no measurable change, then a small decline, and finally a collapse.
While 2-bit quantizations work to some extent, even the best 1-bit model is useless for these benchmarks:
As you may see, the scores are around the random guessing level, with the smallest model being below that threshold. And longer reasoning makes it worse: at xhigh , scores drop below low , as the model more often reasons until the token budget runs out and returns an empty answer. Sure, Unsloth boasts that:
We also made some smaller UD-1bit quants with UD-IQ1_S being 6.2GB (without MTP) which retain around 72% top-1% accuracy yet being 89% smaller.
But in this case, these remaining 28% matter a lot. And this matches another user’s experience, vide Qwen3.8 27b 1bit brain damage quant on r/LocalLLaMA:https://www.reddit.com/r/LocalLLaMA/comments/1vtr3h0/ladies_and_gentlemen_i_present_to_you_qwen38_27b/.
Running these benchmarks isn’t cheap. Running benchmarks via API is costly, as I know from my previous benchmarks:https://quesma.com/benchmarks/. Running on rented GPU is much costlier.
I used Modal, as it is easy to run it from the CLI, including from agents. Other setups may have different pricing. Obviously, this calculation changes if you have your own devices.
It takes some testing to find the optimal way to run models. Usually, instead of using Multi-Token Prediction (MTP), which works well for a single stream, I use a few parallel streams. The key constraint is whether the GPU has enough memory for both the model and the required KV caches.
I used NVIDIA L40S (the same Ada Lovelace chip as the RTX 4090 but twice as much memory: 48 GB), H100 (80 GB) and H200 (141 GB). I would like to share costs to give you a ballpark estimate if you want to run benchmarks yourself.
For comparison, DeepSeek V4 Flash 0731:https://openrouter.ai/deepseek/deepseek-v4-flash-0731#providers, a 284B model, costs around $0.1/Mtok for output from the cheapest providers on OpenRouter. I am not sure how much of this difference comes from the efficiency of running models at scale, pricing strategy, or popularity.
If you run experiments locally, usually pick the best model that fits in your GPU memory together with the required context. For most tasks Unsloth’s Q4_K_M should be good enough, without any noticeable difference; for some simpler tasks UD-Q2_K_XL should be more than fine. Since people report that KV-caches are more susceptible to quantization, I may test it as well.
But in general, I believe that quantization should be embraced, rather than feared.
And what is your experience? Join the discussion on r/LocalLLaMA:https://www.reddit.com/r/LocalLLaMA/comments/1vz3ieu/benchmarking_qwen38_27b_quantizations_4bit_holds/, Hacker News:https://news.ycombinator.com/item?id=49611128, or LinkedIn:https://www.linkedin.com/feed/update/urn:li:activity:7498431004932743168/.
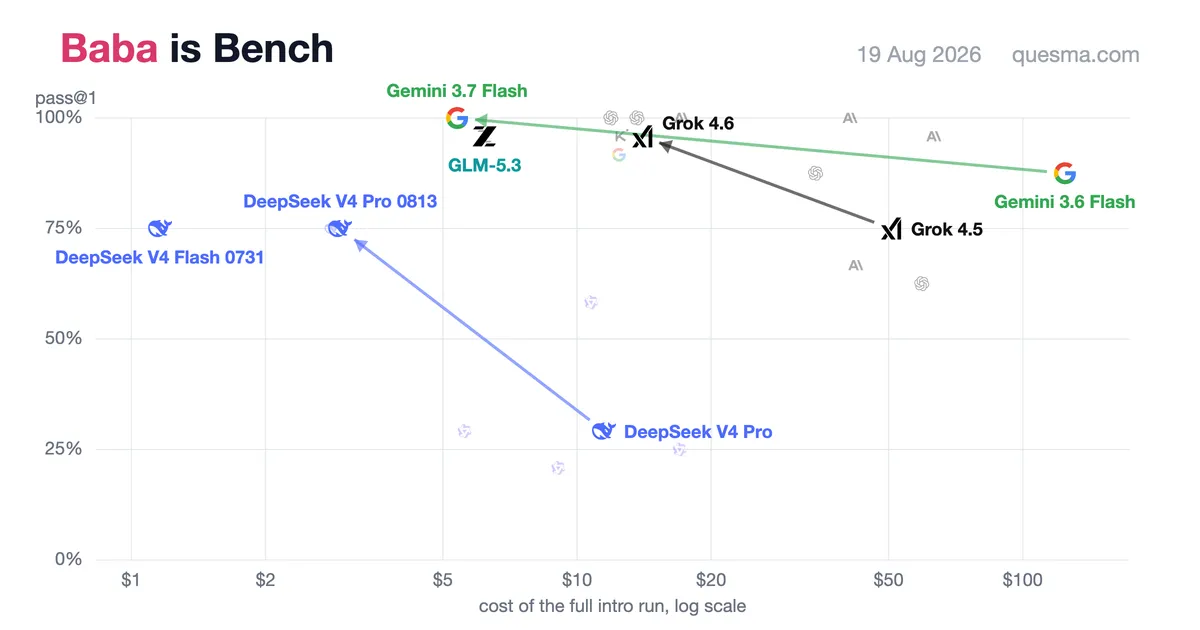
August 2026 on Baba Is Bench: Gemini 3.7 Flash, Grok 4.6 and DeepSeek V4 Pro 0813 each beat their predecessor while costing 3-20x less. For open-weight GLM-5.3 and Qwen3.8 progress is gradual.
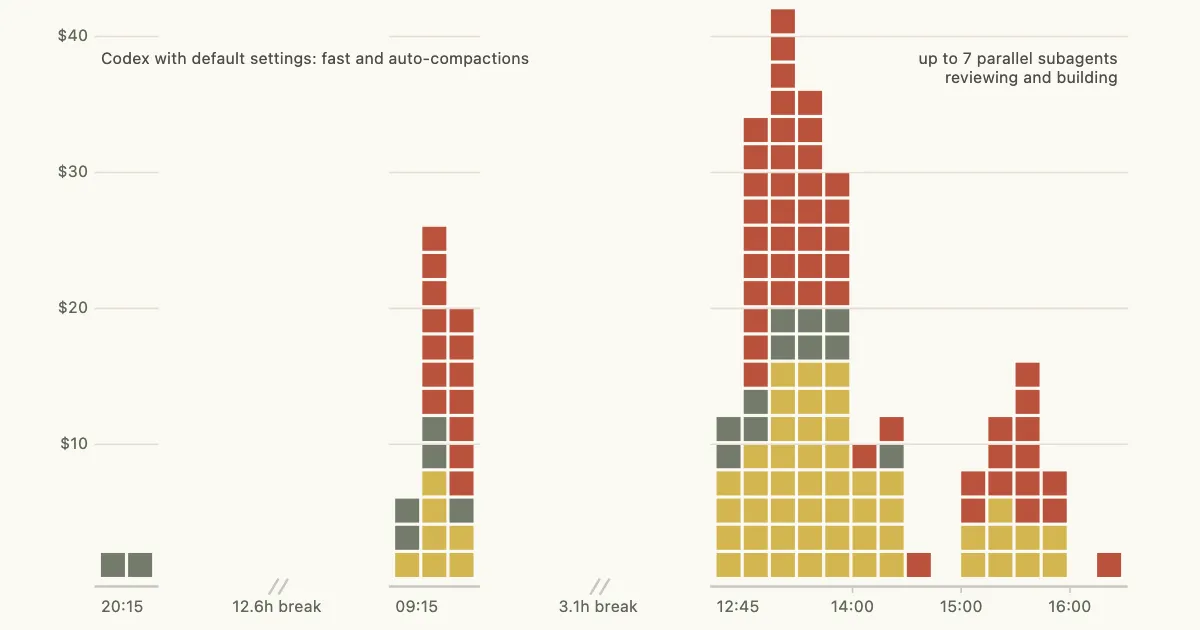
A buyer’s guide to OpenAI Codex for individuals, teams, and enterprises. Includes comparisons with Claude Code.
We tested Qwen3.6 27B quantizations by Unsloth on Hugging Face, with pelicans on bikes, gears, Terminal-Bench 2.1, and AIME-120.

 扫码直达文章详情