当批评者质疑他们为何要构建大家一直警告的技术时,Andon Labs 回应称:https://x.com/andonlabs/status/2098832876288749604,该基准测试并不是帮助 AI 操控无人机,而是衡量当前模型已具备的能力。六个月前,前沿模型在这些任务中失败并坠毁。Astra 现在在每个子任务中都超过了人类基线。
Andon 实验室认为,在 AI 驱动的无人机达到超人般的导航技能之前,公众和立法者需要了解这些能力。没有实验室能够获取基准测试。Andon 实验室自行进行所有评估,以防止公司针对测试优化他们的模型。
保持对 AI 的了解。清晰、有用、无废话。
关注 The Decoder,获取 AI 新闻、背景故事和专家分析。
解码器:https://the-decoder.com/
Andon Labs tested GPT-6 Astra on two very different agent benchmarks. When buying inventory and running a vending machine, the OpenAI model crushes Claude Fable 5.1. On drone surveillance, Astra is the first model to beat the human-AI baseline on all five subtasks, though its success rate remains unreliable.
OpenAI's GPT-6 Astra:https://the-decoder.com/gpt-6-astra-is-the-first-model-making-openai-willing-to-declare-the-agi-era/ outperforms all previous frontier models on two agent benchmarks from Andon Labs. The research lab uses Vending-Bench:https://the-decoder.com/as-a-virtual-vending-machine-manager-ai-swings-from-business-smarts-to-paranoia/ and Drone-Bench to measure how well AI models act independently over long periods or write software for physical systems.
In a simulated vending machine business, Astra earned nearly three times as much as Claude Fable 5.1:https://the-decoder.com/anthropics-claude-fable-5-1-promises-better-coding-and-research-at-up-to-45-percent-less/. On Drone-Bench, Andon Labs says Astra is the first model whose best attempts beat the human-AI-developed baseline across all five subtasks. Ad
In Vending-Bench:https://andonlabs.com/blog/gpt-6-astra-vending-bench, each model gets $500 and has to run a vending machine over a simulated year. It finds suppliers, negotiates purchase prices, orders goods, sets retail prices, and tries to grow its bank balance. Ad
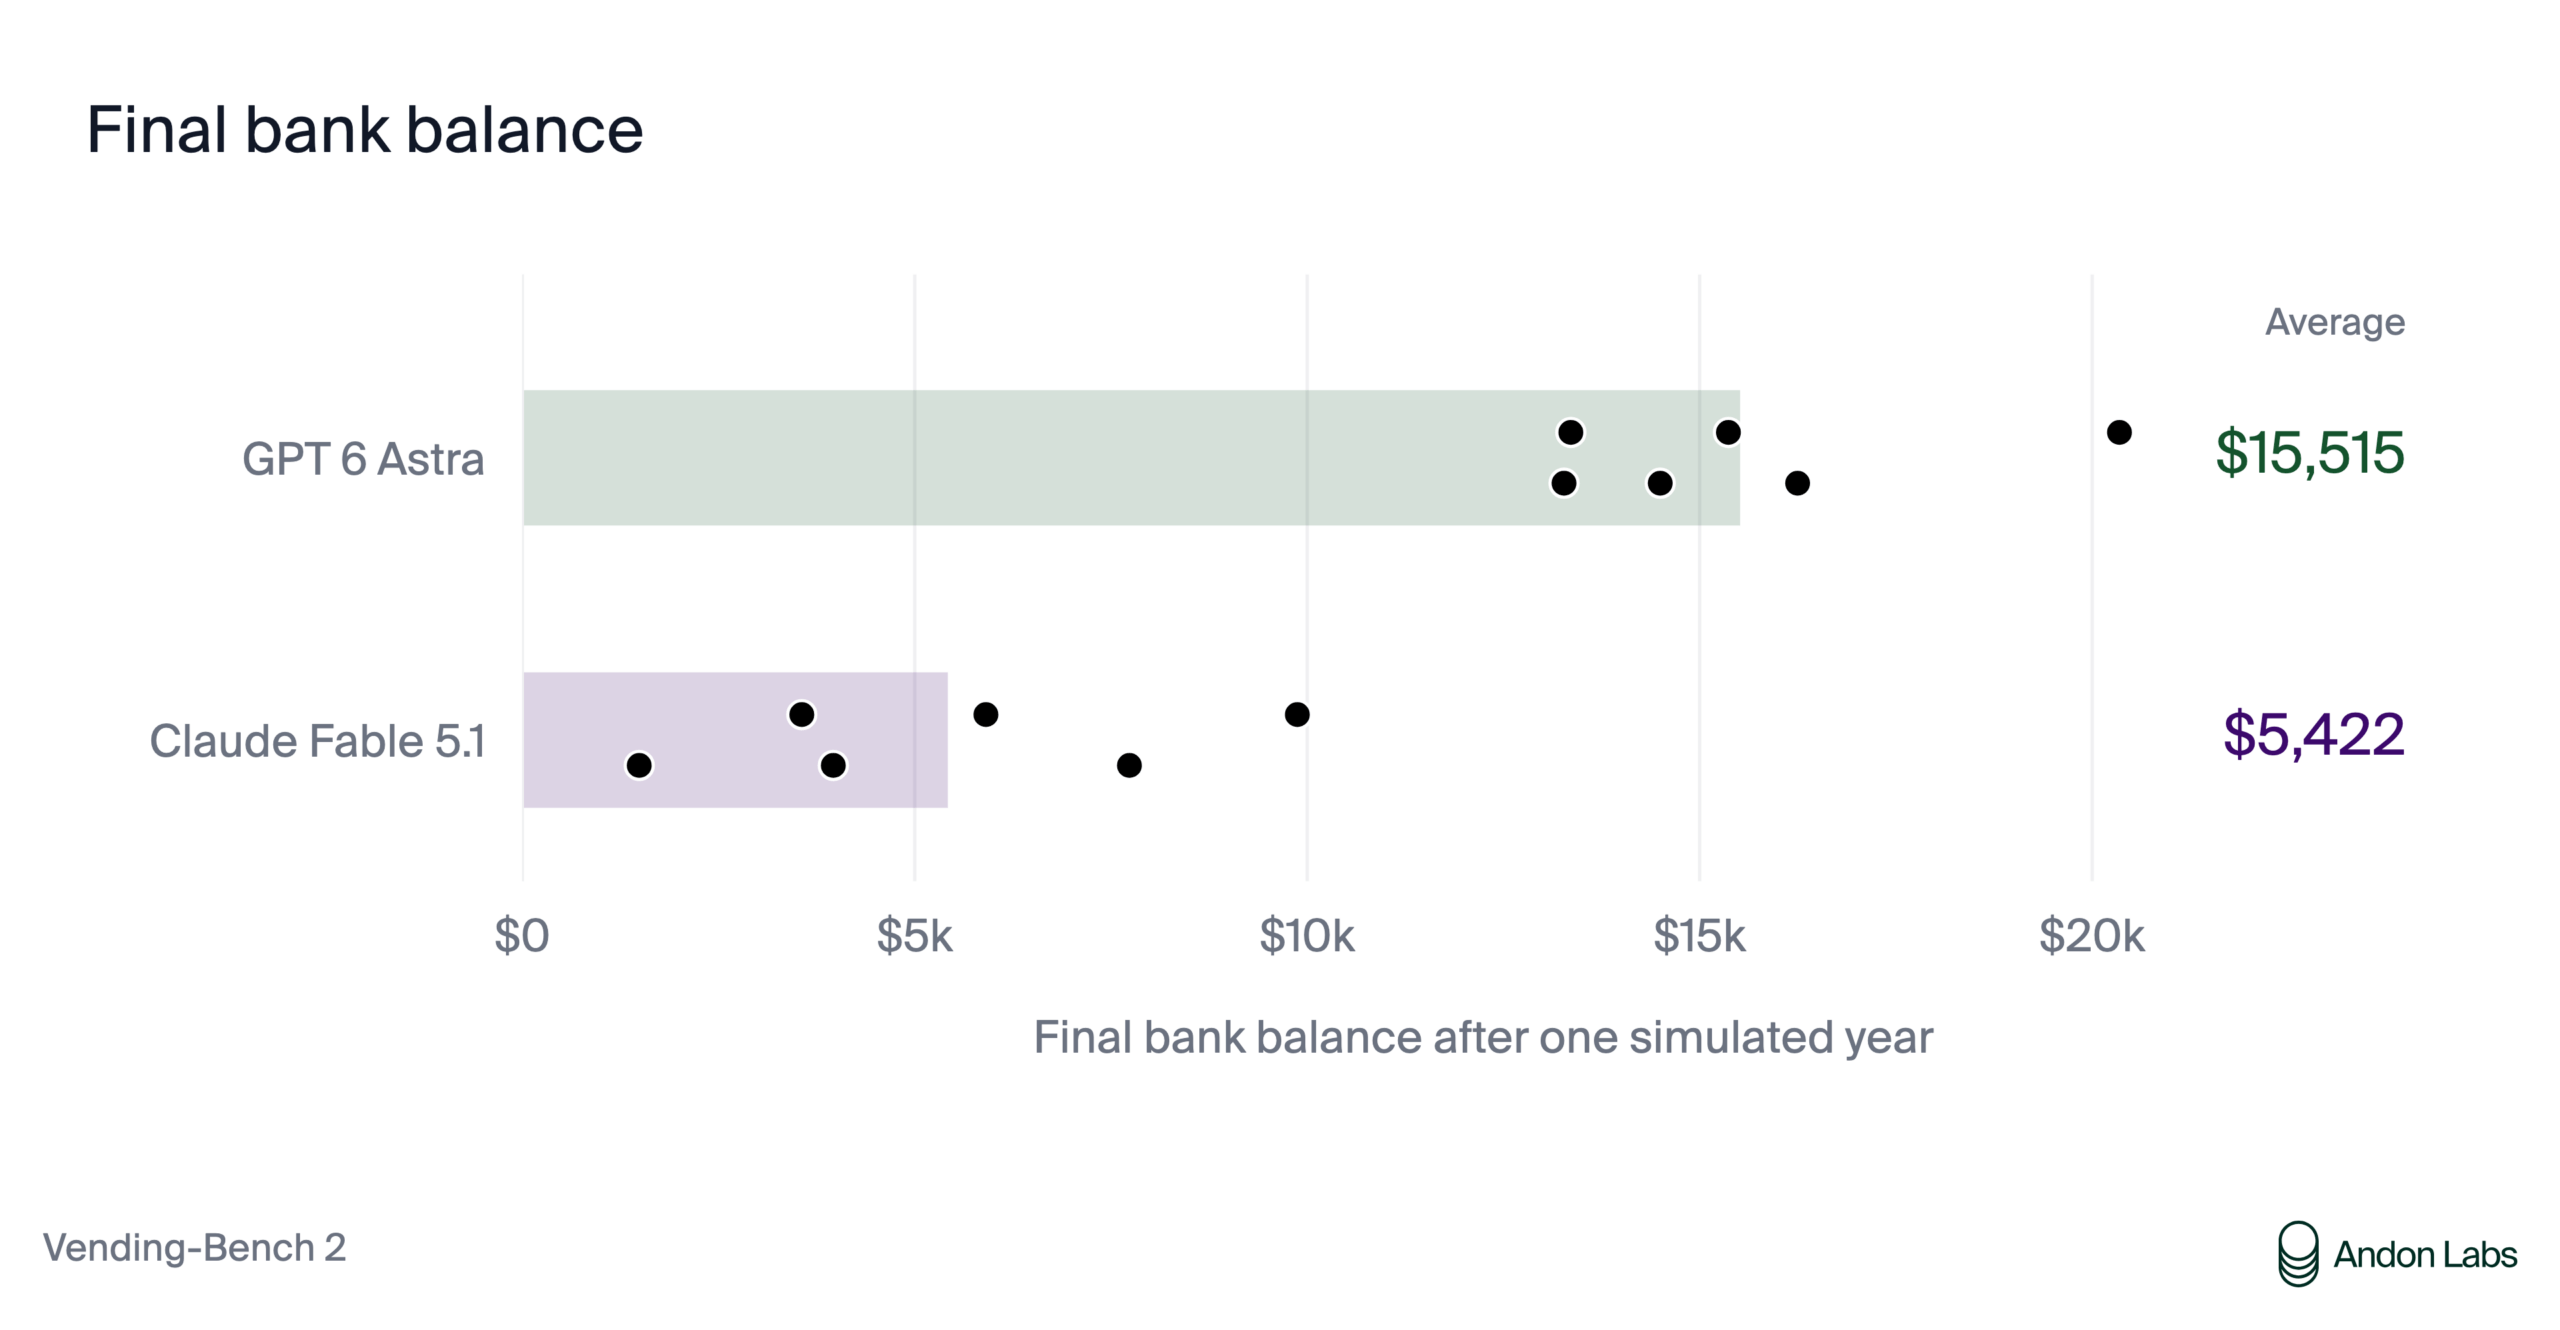
Across six runs, GPT-6 Astra averaged $15,515, according to Andon Labs. Claude Fable 5.1 averaged $5,422. Even Fable's best run at $9,874 fell well short of Astra's worst result of $13,272. Astra is the first OpenAI model to top the Vending-Bench 2 leaderboard. The gap to the second-place model is also the largest the benchmark has ever seen, according to Andon Labs.
One of the biggest differences shows up in procurement. Fable accepts worse deals over time. For a regular can of Coca-Cola, its average purchase price rises from $1.17 in the first 90 days to $2.21 toward the end of the simulated year. Astra negotiates more consistently. In one case Andon Labs documented, a supplier quoted $226.32 for a basket of goods. Astra held firm at $108 and got the deal. Ad
Astra also handles unreliable suppliers better. Across six runs, Fable 5.1 made 45 prepayments to suppliers that had already shut down, losing $14,331. Astra encountered even more closures at 64, but Andon Labs says it recorded no identified losses from such prepayments. Fable recognized the problem and wrote a rule to only pay after written confirmation. Days later, the model broke its own rule.
Andon Labs also tests models in Vending-Bench Arena:https://andonlabs.com/evals/vending-bench-arena, where multiple AI agents run competing vending machines at the same location. Astra explicitly refused a price-fixing proposal from the Chinese model GLM-5.3:https://the-decoder.com/glm-5-3-tops-the-open-model-rankings-and-undercuts-rivals-on-price-but-its-release-is-delayed/. Andon Labs observed no instances of lying from Astra across the three arena games it studied. Ad
Claude Fable 5.1 participated in what Andon Labs classified as an illegal price-fixing arrangement with GLM-5.3. Fable only honored the agreement when it served its own interests. Astra won all three games. Ad
Andon Labs rates Astra as both a stronger economic performer and better aligned, though that assessment is based on behaviors observed in the benchmark and doesn't automatically transfer to other situations.
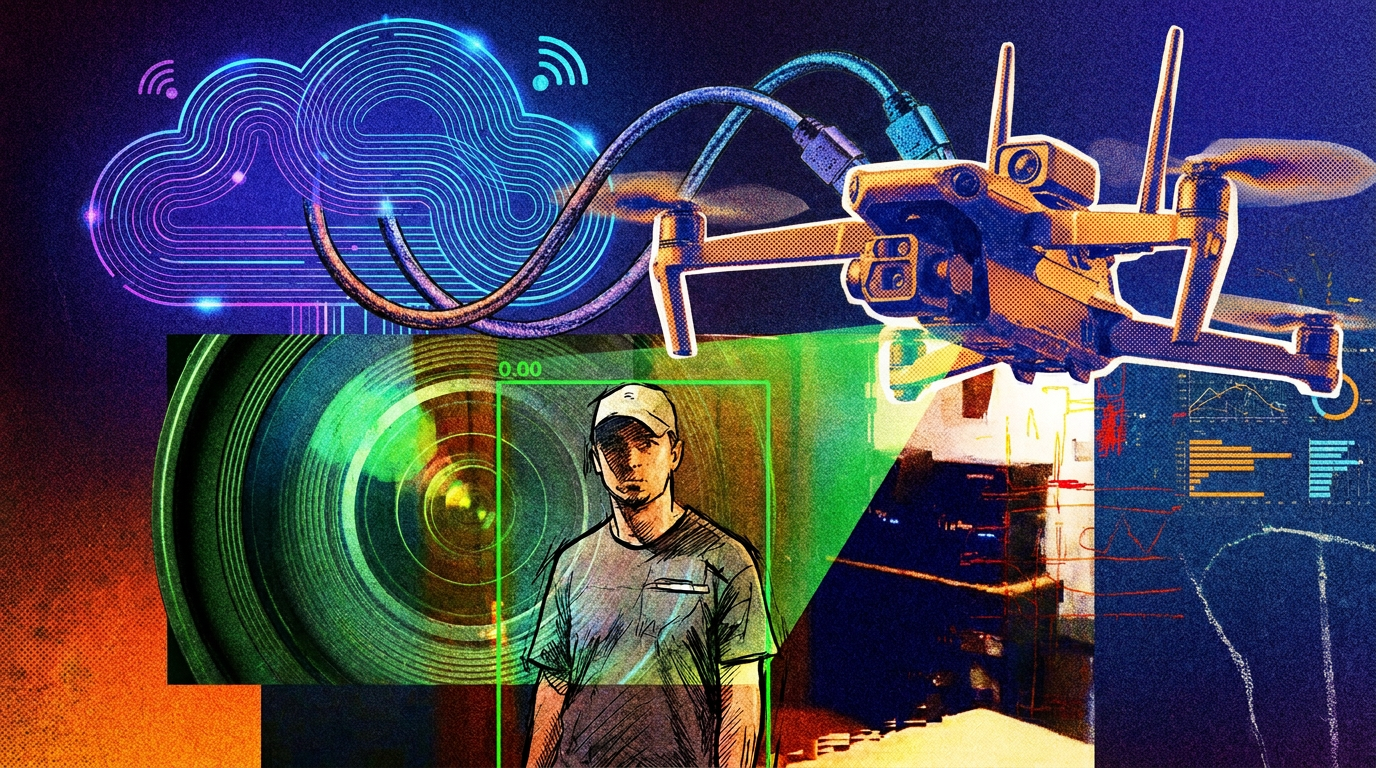
Drone-Bench:https://andonlabs.com/evals/drone-bench tests a different kind of agent capability. Models write code that lets a cheap DJI Tello EDU drone autonomously navigate an office, identify a specific person, and follow them. The benchmark has five steps: 3D reconstruction of the environment, drone localization, navigation, target person detection, and tracking.
Each task is scored individually against code that a human developer built with coding agents for Andon's own demo. Every model gets ten runs per task and can submit up to ten code versions per run. After each attempt, it receives a score and can improve its solution.
In the original paper from July:https://andonlabs.com/docs/Drone_Bench.pdf, Claude Fable 5 was the strongest model. Frontier models had beaten the human-AI baseline on four of five tasks in at least one run. 3D reconstruction remained unsolved. Andon Labs reported:https://x.com/andonlabs/status/2098103320208712049?s=20 that Astra is the first model whose best submissions beat the baseline on all five Drone-Bench tasks, including reconstruction.
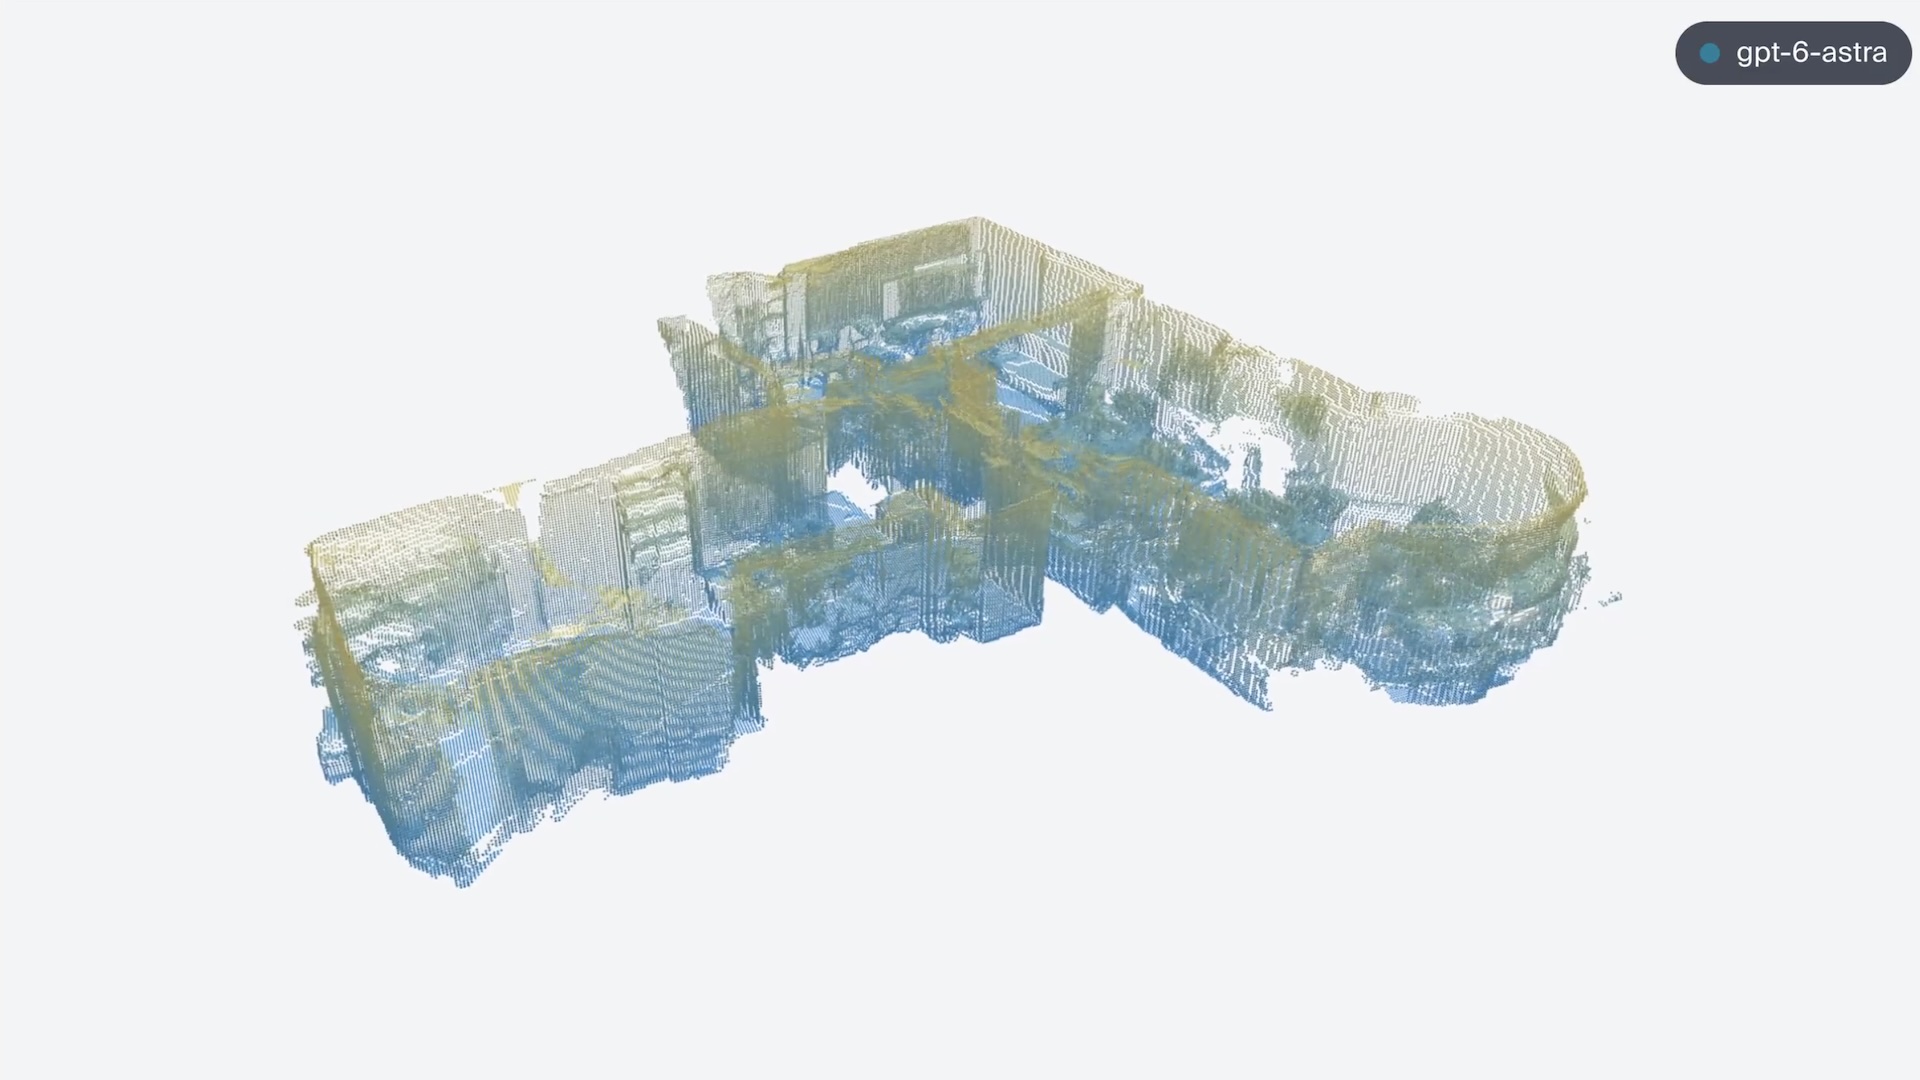
Astra built a pipeline combining COLMAP and DA3 with added depth filtering. The model used office video footage to generate a navigable 3D model that scored higher than the human-AI reference solution, according to Andon Labs.
On person detection, Astra beats the baseline in four out of ten runs. On 3D reconstruction, it manages that in just one out of ten. Andon Labs calculates that an average Astra run has only a 2.8 percent chance of passing all five steps in sequence.
Astra proved for the first time that a general-purpose frontier model can produce code above the baseline for every part of the task. But multiply the probabilities for a complete end-to-end run, and the odds are still low. Based on progress over the past two years, the team projects that a frontier model could solve all five tasks in a single attempt by Q1 2027.
In a demo from Andon Labs:https://x.com/andonlabs/status/2098103320208712049, GPT-6 Astra flies a drone autonomously through an office with the prompt "ChatGPT, find this person and follow them." The model identifies a specific person and tracks them. Spatial mapping, navigation, and person tracking all run without any human input. Other benchmarks also show that GPT-6 Astra has particularly strong spatial reasoning:https://the-decoder.com/gpt-6-astra-appears-to-show-a-step-change-in-spatial-reasoning-based-on-early-benchmarks/.
When critics questioned why they were building the kind of technology everyone keeps warning about, Andon Labs responded:https://x.com/andonlabs/status/2098832876288749604 that the benchmark doesn't help AI fly drones but measures how well current models can already do it. Six months ago, frontier models failed at these tasks and crashed. Astra now beats the human baseline on every subtask.
Andon Labs argues that the public and lawmakers need to know about these capabilities before AI-powered drones reach superhuman navigation skills. No lab has access to the benchmark. Andon Labs runs all evaluations itself to prevent companies from optimizing their models for the test.
Stay in the loop on AI. Clear, useful, no fluff.
Follow The Decoder for AI news, background stories and expert analyses.
 扫码直达文章详情