How much better could a coding agent perform if it used the best model for each task?
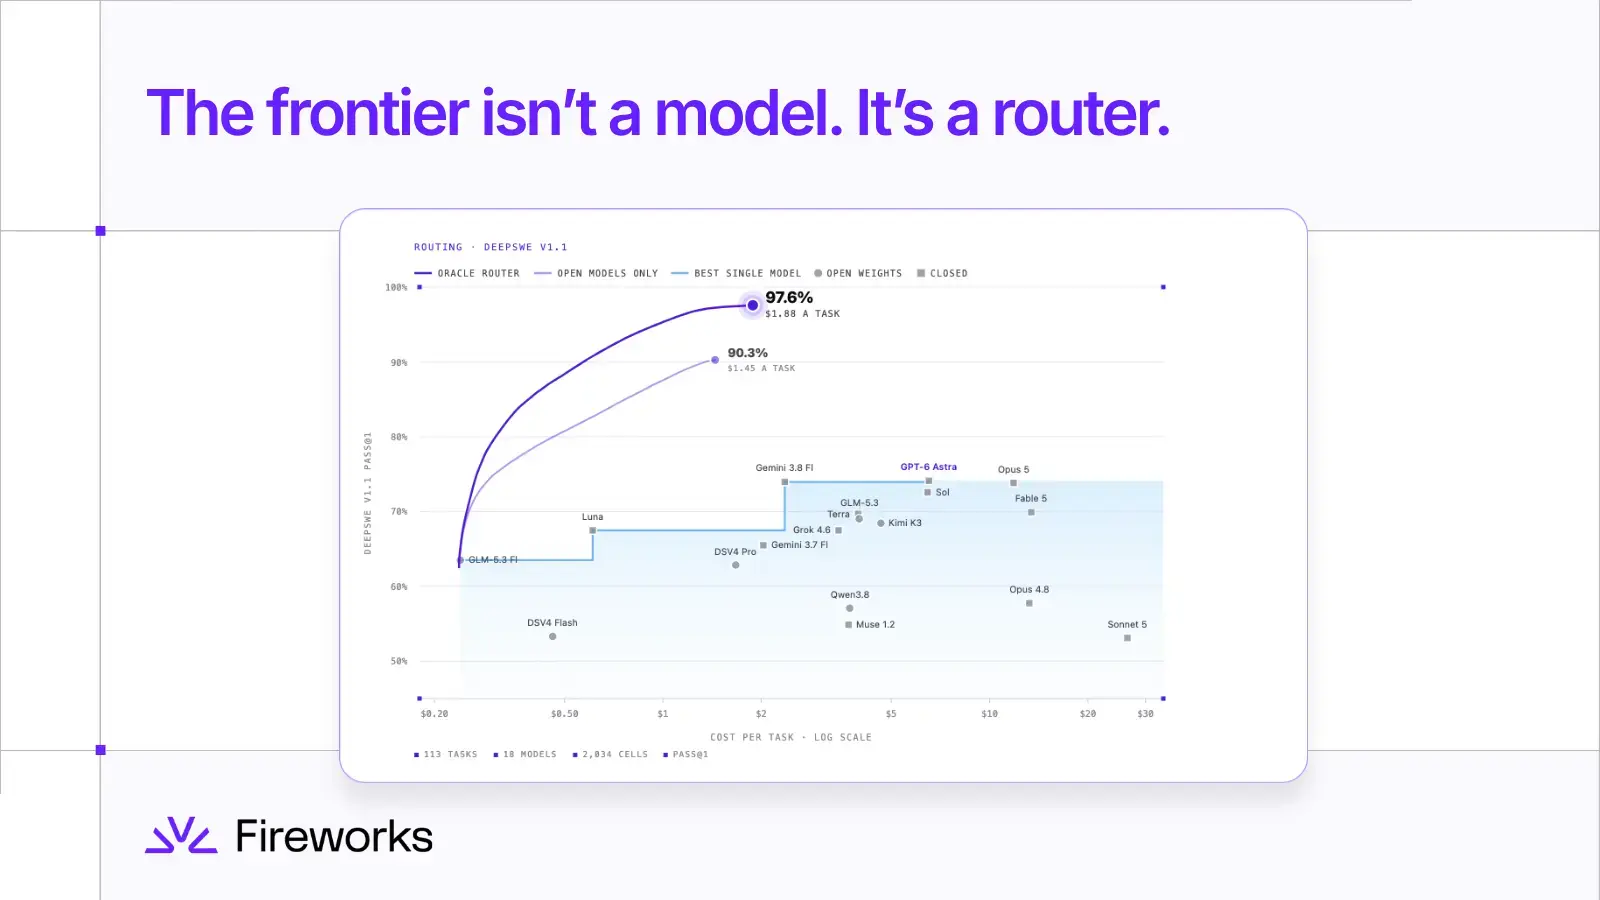
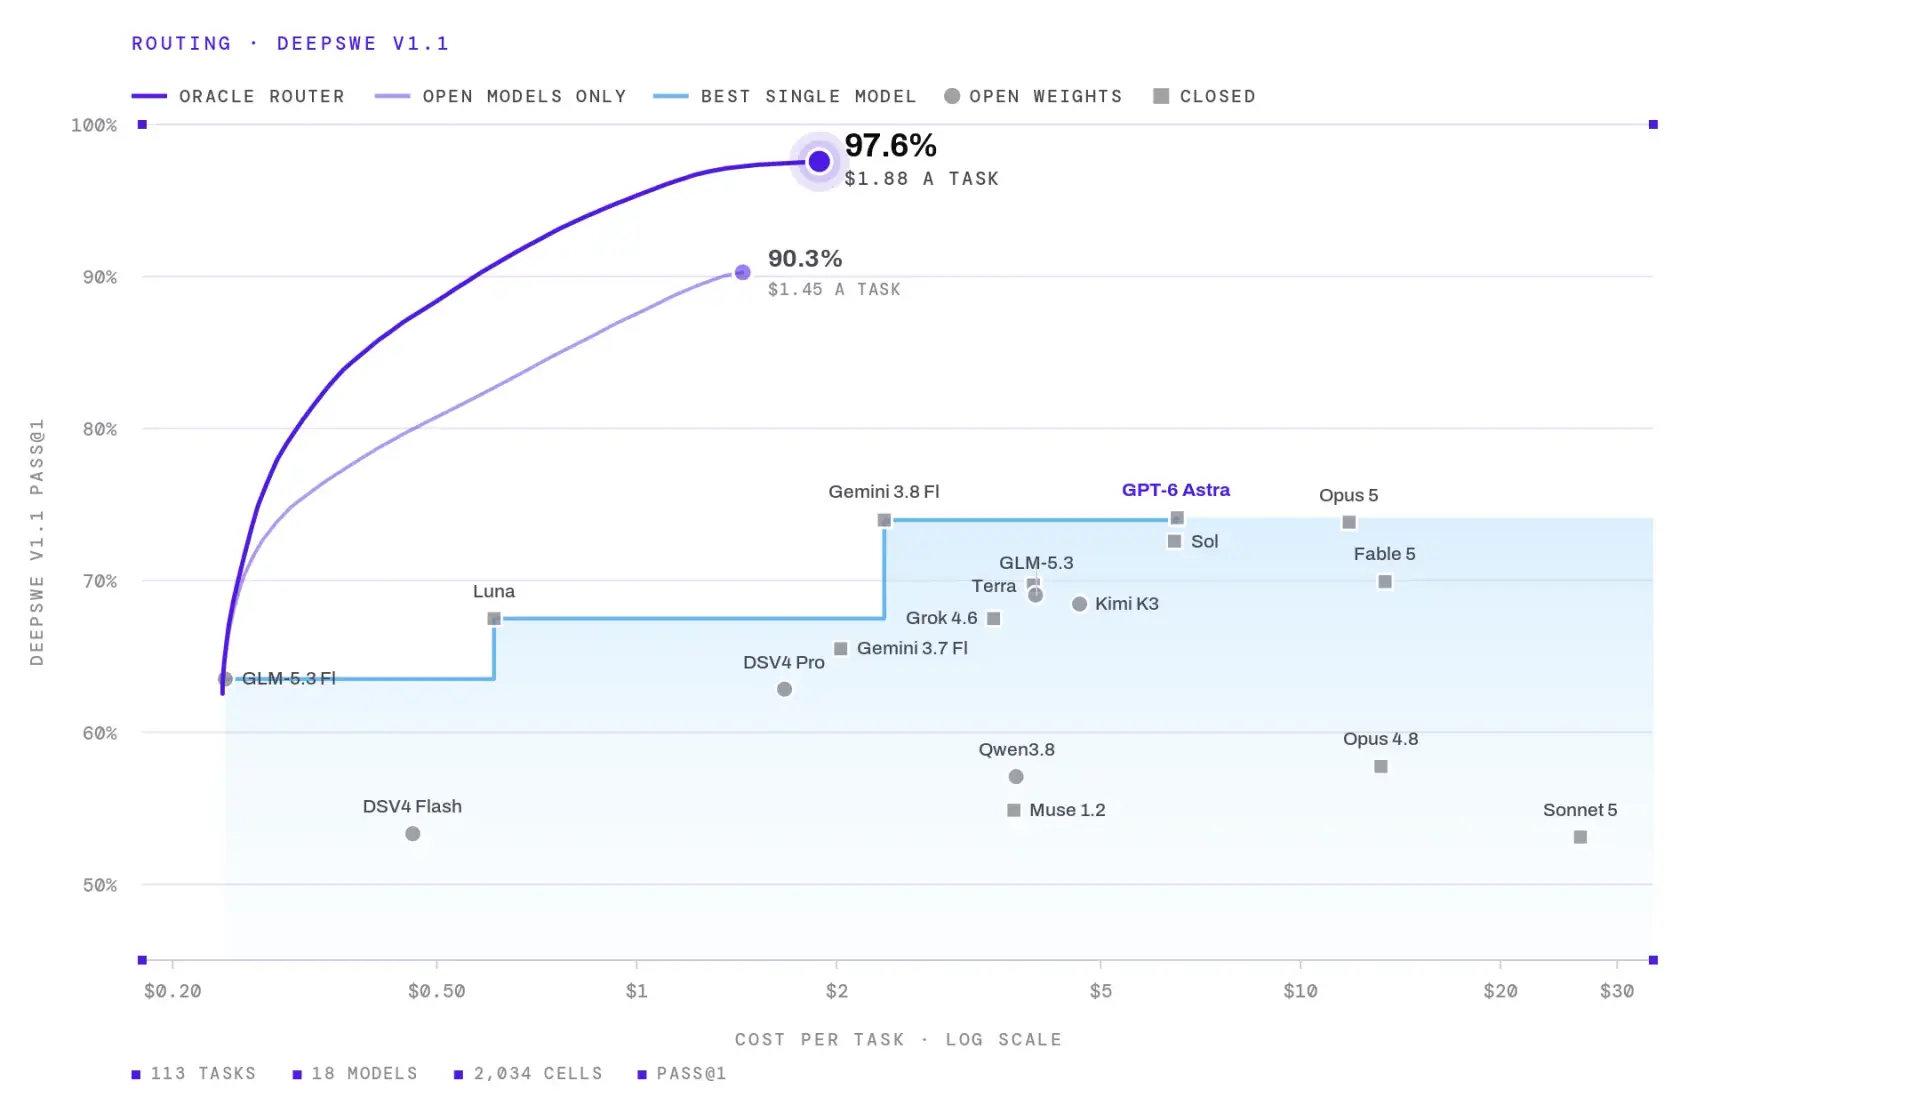
The best single model, GPT-6 Astra, gets 74.1% of DeepSWE tasks at $6.52 each. Pick the right model for each task and the same eighteen models get 97.6% at $1.88. 23 points better, at under a third of the cost.
That number comes from hindsight. We ran all eighteen models on every task first and picked the winner for each one. What it measures is the capability already sitting in the pool, but it's split across models that nobody uses together.
Putting them together is a router's job. It picks which model handles each task before the work starts, and before is the hard part. Looking back, it's easy to point at a task and name the model that would have done it better. A router has to choose before it sees the outcome, and a wrong choice costs far more than the few dollars it saved.
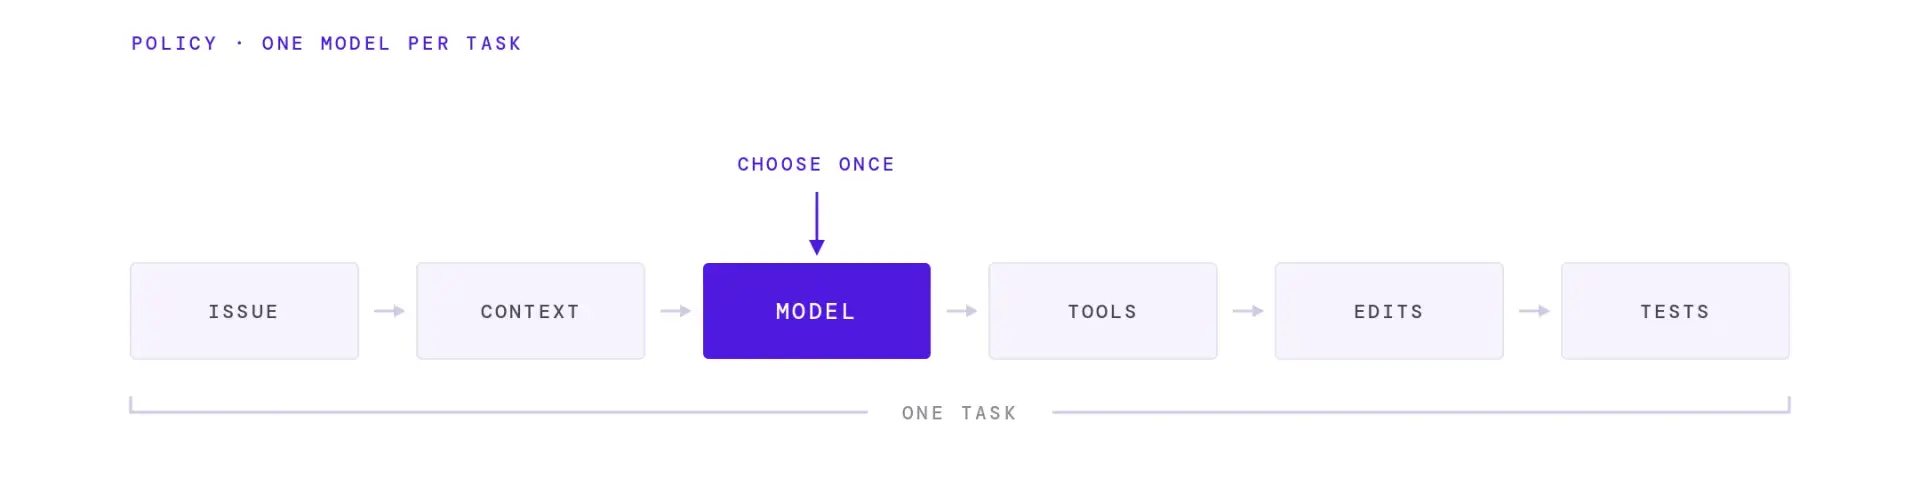
We analyzed DeepSWE v1.1:https://deepswe.datacurve.ai/, an agentic coding benchmark where the unit of work is an engineering task: the agent has to understand an issue, inspect a repository, use tools, edit code, execute it, and get the task to pass.
The policy is deliberately simple. Pick one model at the start of a task and keep it for the whole run, with no switching mid-session.
Then we name the winner for each task by measured pass rate, breaking ties on cost. That's the oracle router. the same method we used in our Kimi K3 and Fable analysis:/blog/kimik3-fable.
The oracle scores on the same 113 tasks it picks from, using four rollouts per model-task pair, and taking a maximum over 18 noisy estimates biases it upward.
The best models score around 70% and spend $6.46 to $13.41 a task getting there:
That's the best a fixed-model policy does. Now pick per task:
The oracle router across all eighteen models reaches 97.6% at $1.88 a task . That is 23 points above GPT-6 Astra, at under a third of its cost. Restrict it to open-weight models only (DeepSeek V4 Flash and Pro, GLM-5.3 and GLM-5.3 Flash, Kimi K3, Qwen3.8 Max), and it still reaches 90.3% at $1.45 a task , which beats every closed model here by 16 points while spending under a quarter of what Astra does.
These results make "open versus closed" a less interesting debate. The emerging race is to move from the theoretical oracle router to building a system of models with collectively better intelligence than any single model. A system of open models can in principle already far surpass the closed frontier.
There is substantially more capability in the pool than any individual model exposes.
In our prior work, we found different models are sufficient (even exceptional) on different tasks :/blog/kimik3-fable. The DeepSWE analysis makes the cost implications concrete. At that 97.6% point, the oracle still sends 94 of the 113 tasks to a model costing under $3 .
The three most expensive models in the field, all above $11.50 a task, are the sole best choice on only three tasks .
On 79 of the 113 tasks , at least one of those expensive models ties the top score and loses the task on price alone. A strong general-purpose model can be excellent across a broad distribution without being uniquely necessary on most individual tasks.
A fixed-model policy pays for broad capability on every task. A system can ask a narrower question:
What capability does this task actually require?
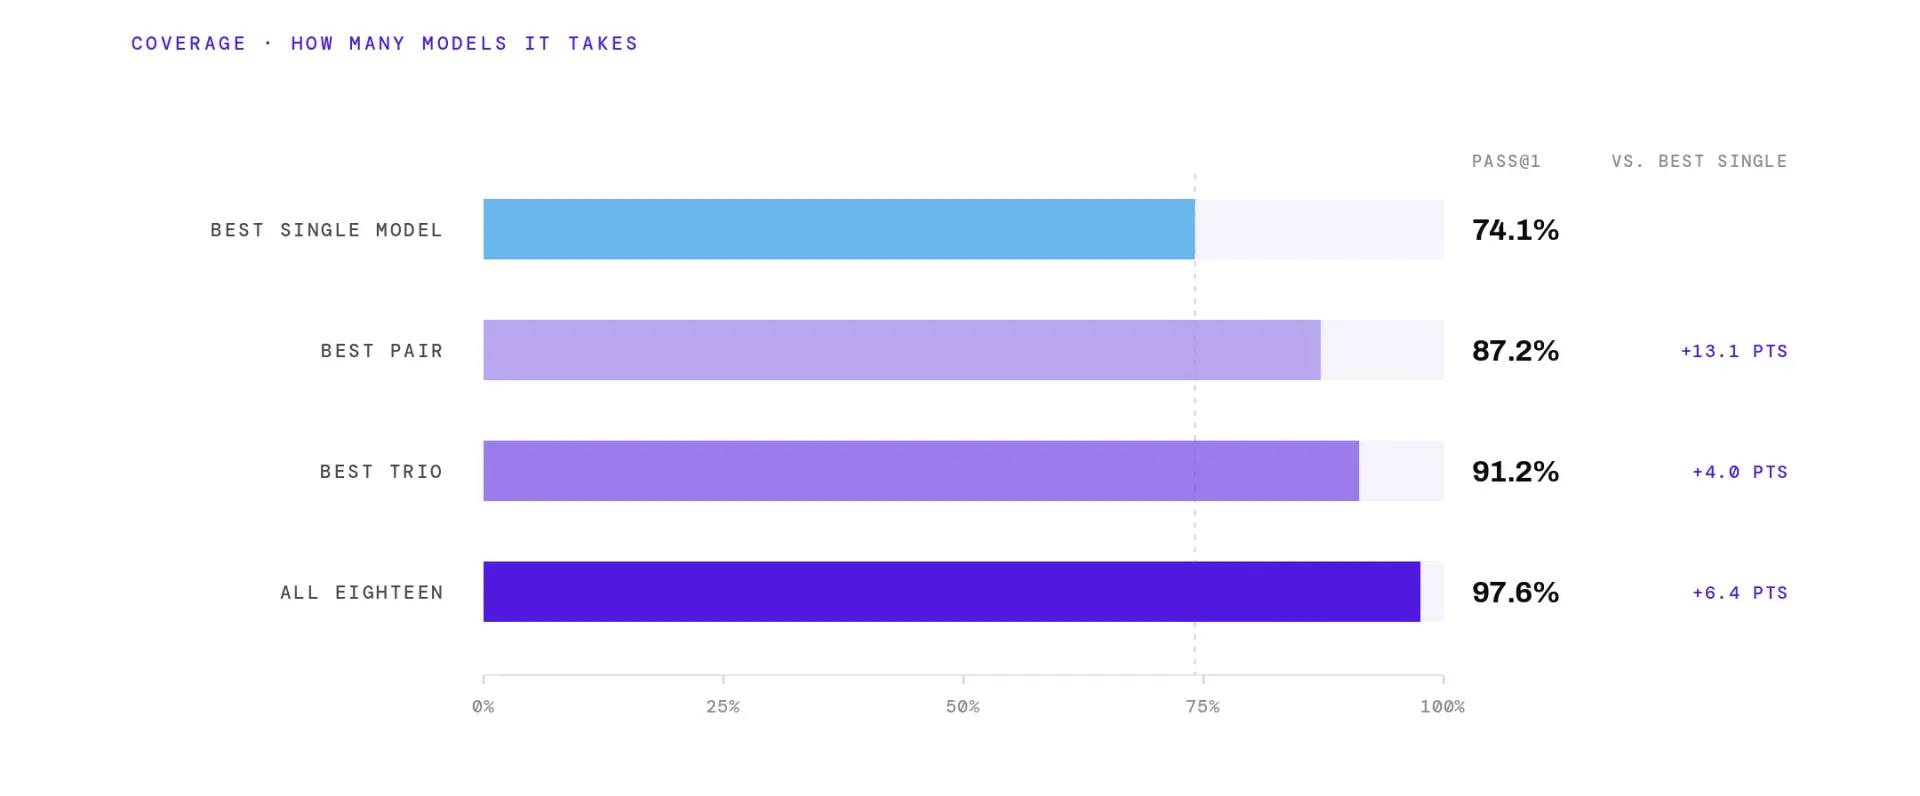
How many models does it take to capture the effect?
The best pair adds 13.1 points over the best single model, and the best trio reaches 91.2%. Expanding from three models to all eighteen adds another 6.4 percentage points. The useful object is not a catalog of hundreds of nearly interchangeable models. It is a portfolio with complementary coverage.
The value is capability coverage, not model count.
LLMRouterBench:https://aclanthology.org/2026.findings-acl.1881/ evaluates routing across 33 models and more than 400,000 instances. It finds that a handful of models covers most of what the full set can do, and that bigger pools add little without careful curation.
An oracle is easy to love because it never gets to be wrong. A production router does. We measured it strictly: we use pass@1, the probability that a single attempt passes, rather than a "did this model ever succeed across four attempts" rule. That second rule would make the ceiling look far more impressive while meaning much less.
The gap is a product problem and the literature is blunt about it. LLMRouterBench finds that several recent routing approaches, including commercial ones, fail to reliably beat simple baselines, and traces much of that to model recall: even when a model with the right capability exists in the pool, the router has to recognize when to reach for it.
So sticking with one model you know isn't conservative, it's rational: a stable error distribution beats a router that unpredictably picks the wrong specialist. The bar for a routing system is to make model specialization predictable enough that changing models improves the system without making its behavior less trustworthy .
Routing is usually introduced as a cost optimization: send easy work to a more cost-optimized model, reserve the expensive one for hard work, and keep the difference. At Fireworks:/nexus, we take a broader view.
If different models are genuinely complementary, then selecting among them moves you up the capability curve, not merely left along the cost curve.
That's what FireRouter is built for. It routes at the task level across both open and closed models, and it's cache aware, so switching models doesn't silently throw away the context you already paid for.
Over four weeks of our own production coding traffic, sessions routed through FireRouter cost $7.42 against $15.81 for Opus 5 alone, a 53% reduction across 2,334 sessions.
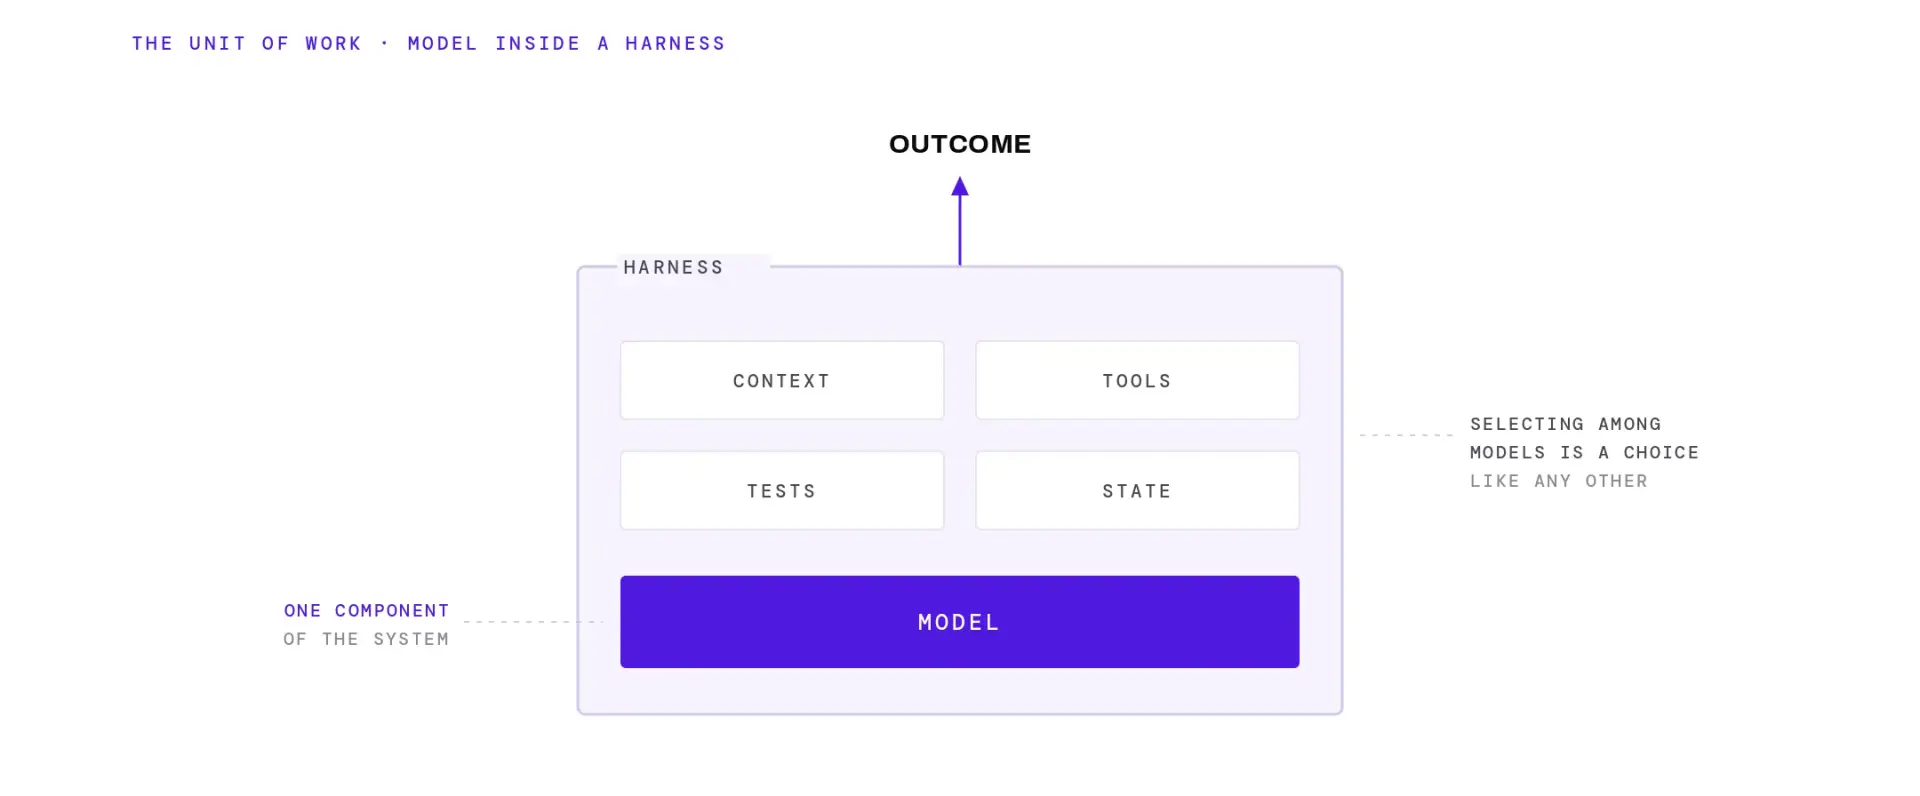
The useful unit of AI work is already larger than the single model call. A coding agent is a model inside a harness that supplies context, tools, execution, tests, state, and feedback.
Once several models have complementary strengths, the selection policy becomes a component of the system:https://www.faros.ai/blog/open-models-vs-frontier-models, alongside context, tools, and tests. Choosing and composing those components is the job. That's what AI engineering is.
Our experiment measures only the simplest version of that system: pick one model at the start of a task and leave it there. The selection policy is the part we can actually build.
We serve every frontier open model in production, which is where a real understanding of each model's strengths comes from. You do not learn what a model is uniquely good at from benchmark averages. You learn it by running all of them, on real work, at scale. That is where FireRouter's model choices come from, and that bar is the one we intend to clear. We will go into our own router:https://docs.fireworks.ai/ecosystem/firerouter/overview and how to hill-climb on your own specialized intelligence:/training in future posts.
Define your frontier on FireRouter:https://app.fireworks.ai/fire-router.
On costs. All cost figures in this analysis come from the DeepSWE leaderboard's published per-model numbers. The raw cost_usd in the public trials file does not match what the board displays, and for the DeepSeek family it differs by several times over, so each model’s per-task costs are scaled so its mean matches the published figure. Accuracy comes from the four raw rollouts of each task-model pair, cost from the board.
Source: DeepSWE v1.1 trials, refreshed 17 September 2026. 113 tasks, 18 models each at its best available configuration, 2,034 model-task cells.

 扫码直达文章详情