Nemotron 3 分辨可在 Hugging Face 获取:https://huggingface.co/nvidia/Nemotron-3-Diarization,以及在 Baseten 模型库中获取:https://www.baseten.co/library/nemotron-3-diarization/,提供批量、流式和实时分辨转录预设。只需几次点击即可部署,按请求选择延迟配置,并与您已经运行的 ASR 配对——或者联系我们的工程师:https://www.baseten.co/talk-to-us/?model=nemotron-3-td-nemotron-asr 了解我们如何优化您的语音工作负载。
保持对模型性能、推理基础设施等的最新了解。
专用推理:/products/dedicated-inference/
Model Labs:/products/baseten-for-model-labs/
模型运行时:/platform/model-performance/
基础设施:/平台/云原生基础设施/
多云:/products/multi-cloud-capacity-management/
自宿主:/deployments/baseten-self-hosted/
混合:/deployments/baseten-hybrid/
前置部署工程师:/平台/嵌入式工程/
转录:/solutions/transcription/
图像生成:/解决方案/图像生成/
文本转语音:/solutions/text-to-speech/
大型语言模型:/solutions/llms/
复合人工智能:/solutions/compound-ai/
文档:https://docs.baseten.co/
储蓄计算器:/resources/calculator/
信任中心:https://trust.baseten.co
条款和条件:/terms-and-conditions/
服务等级协议:/service-level-agreement/
DeepSeek V4.1 闪存:/library/deepseek-v41-flash/
GLM-5.3-Flash:/library/glm-53-flash/
NVIDIA Nemotron 3 Diarization answers who spoke when, 300ms–1s behind live, alongside any ASR.
Use NVIDIA Nemotron 3 Diarization from Baseten’s Model Library:https://www.baseten.co/library/nemotron-3-diarization/, with presets for prerecorded and streaming diarization, and real-time diarized transcription. This is an open, end-to-end diarization model that replaces the usual segmentation-plus-embedding pipeline and its tuning with a single pass, labeling up to eight speakers at a configurable interval as low as every 320ms.
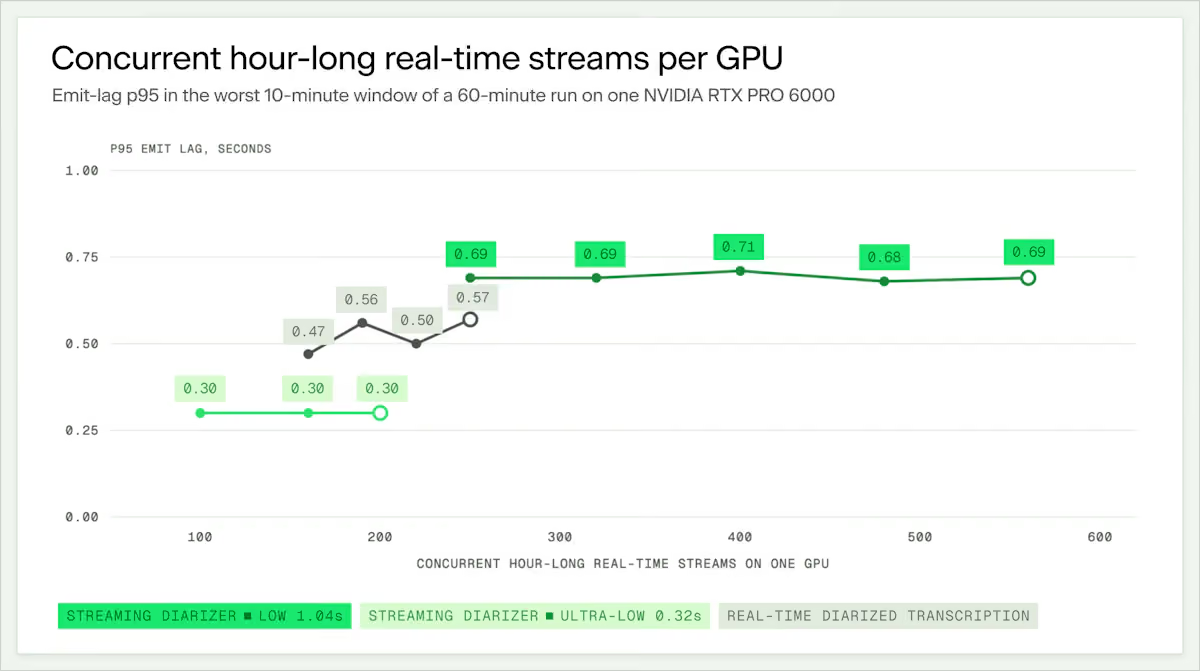
We optimized it on an RTX PRO 6000, which can sustain over 500 concurrent hour-long diarization streams (190 with transcription added). The same per-speaker activity can be used to inform VAD, endpointing, and turn-taking for voice agents.
Speaker diarization segments an audio stream by when each distinct speaker is talking, outputs timings for each distinct voice, and assigns every span a consistent speaker label. In conjunction with transcription, diarization can attribute transcribed words to who said them in a conversation.
The NVIDIA Nemotron 3 Diarization model has a ~100M-parameter transformer-based architecture built on top of NVIDIA Streaming Sortformer:https://developer.nvidia.com/blog/identify-speakers-in-meetings-calls-and-voice-apps-in-real-time-with-nvidia-streaming-sortformer/. It turns 16 kHz audio into 10ms frames and emits a T×8 matrix of speaker-activity probabilities.
Two pieces of state carry a conversation across chunks: an arrival-order speaker cache (speaker_0 is the first voice heard, and stays that way) and a FIFO (“First In, First Out”) of recent frames, with no embeddings or clustering required for an unbounded audio length.
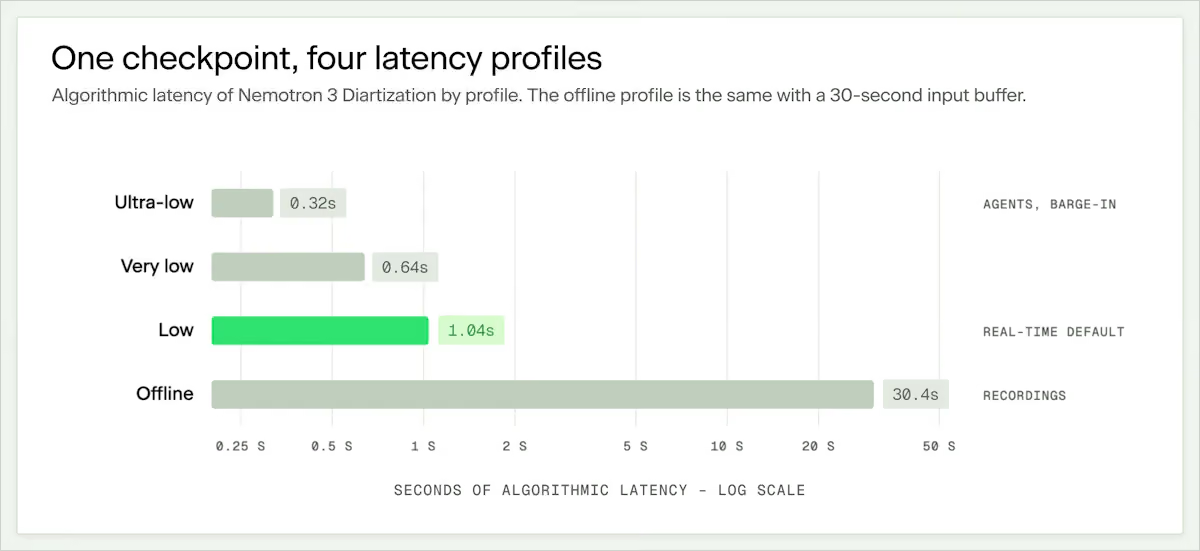
While prior diarization models require extensive configuration of several different parameters or lack support for multiple latency profiles entirely, the same Nemotron 3 Diarization checkpoint can serve each request at four algorithmic latencies between 0.32 and 30.4 seconds, referring to how much future audio the model sees before it commits a label. To accommodate diverse application requirements ranging from real-time agent interactions to offline media processing, Nemotron 3 Diarization supports flexible algorithmic latency settings within a single unified checkpoint.
Figure 1 illustrates how these latency profiles map directly to chunk sizes and right-context lookahead windows. Moving from the ultra-low profile to the standard low profile trades a modest increase in buffer delay for continuous quality gains. This predictability enables developers to configure buffer sizes dynamically per request without redeploying underlying model instances.
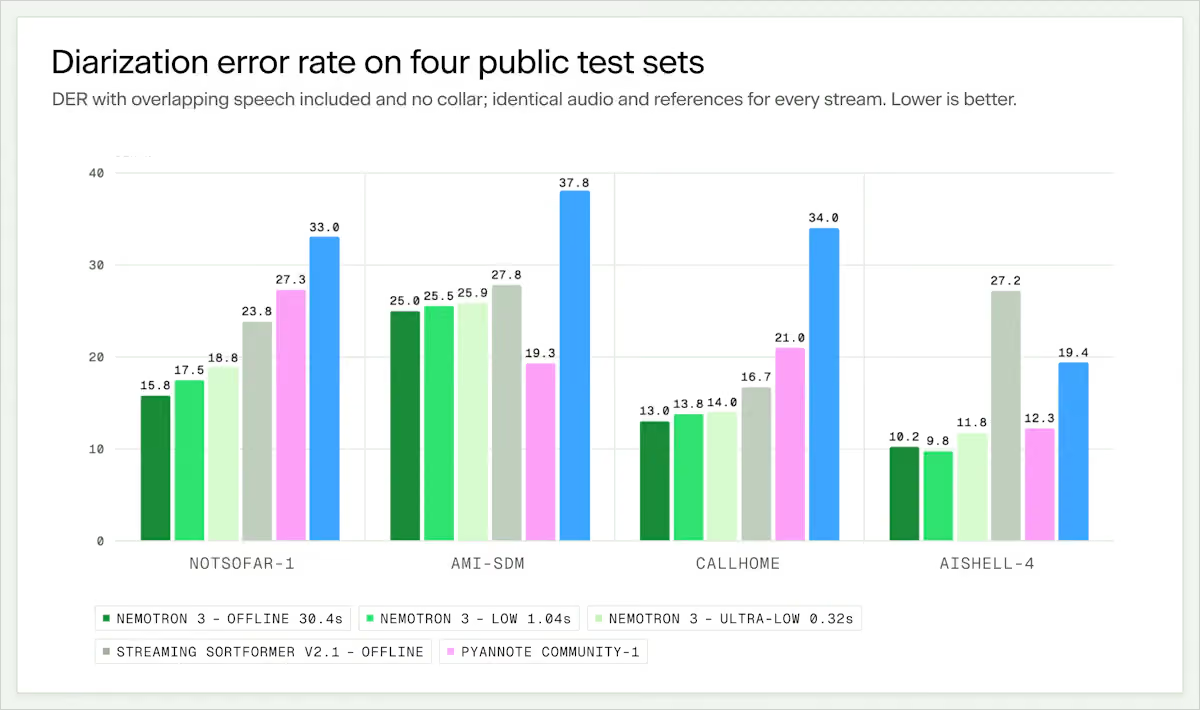
We report diarization error rate (DER) with overlap included and no collar. Nemotron 3 Diarization holds its accuracy as latency drops. Moving from the 30-second offline profile to the 0.32-second ultra-low profile increases DER by only 1-2 points compared to prerecorded, with quality sustained beyond four speakers. On AISHELL-4 at the “low” profile, we observed a DER of 9.8% against 27.2% for Streaming Sortformer v2.1, a significant improvement compared to this model’s predecessor.
To evaluate standard diarization accuracy across varied acoustic environments and speaker counts, we measured DER across benchmark datasets without applying a time collar.
The benchmarking results highlight consistent stability across multiple benchmark datasets in multiple languages, such as NOTSOFAR, AMI, CALLHOME, and AISHELL, outperforming Meta Muse Voice Transcribe on all datasets at even the ultra-low configuration and losing to pyannote community-1 only on AMI. Even under ultra-low latency configurations, the error rate remains within a tight margin of offline baselines, confirming robust speaker attribution under real-time constraints. Streaming diarization on Baseten remains close to prerecorded quality across the tested latency profiles.
Speaker-attributed time segments are only one way to use Nemotron 3 Diarization. At its core, the model tracks speech activity per speaker in 10ms increments. This raw data can be used by voice applications to support three key capabilities:
Voice activity detection : By combining data across all audio channels, it detects speech directly from the audio stream rather than relying on volume levels.
Speaker-specific end-of-turn detection : It tracks when a specific speaker stops talking for a set duration. This helps an AI voice agent distinguish between the primary user finishing a sentence and background chatter from someone else in the room.
Turn-taking and interruptions : The order in which voices appear identifies the primary speaker. If a second voice starts speaking, the model detects an interruption; if both speak at once, it flags overlapping speech, responding in roughly 300ms on ultra-low latency settings.
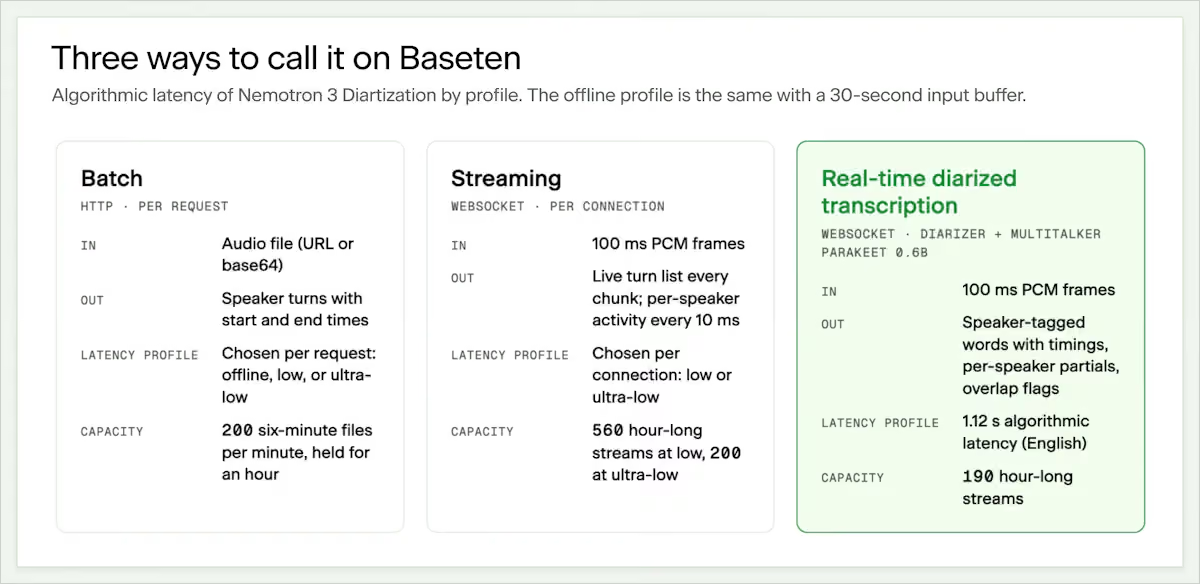
To streamline deployment across different audio infrastructure designs, Baseten exposes the model through three specialized serving presets. Figure 3 provides an architectural overview of these presets along with their target workloads and throughput characteristics.
These modular presets allow voice applications to choose between stateless batch requests, persistent WebSocket streams for live speaker tracking, or joint end-to-end transcription pipelines, matching backend infrastructure requirements directly.
Each latency level runs as its own ready-to-use instance, so you can easily choose your speed per request without redeploying. The real-time transcription option pairs the speaker tracker with NVIDIA's 600M English speech recognition model, NVIDIA Parakeet V2 ASR:https://huggingface.co/nvidia/parakeet-tdt-0.6b-v2, which is also in the Nemotron speech family. By using speaker activity to guide transcription on the same audio stream, it accurately captures both sides of a conversation, even when people talk over each other.
Combining speech recognition with diarization typically requires managing separate model pipelines and aligning transcripts post-hoc. Our real-time system directly conditions the ASR model on speaker activity features within the primary forward pass. By feeding per-speaker activity vectors directly into the initial encoder layers of Parakeet V2, the pipeline transcribes overlapped audio channels in a single pass, eliminating duplicate feature extraction steps and preserving temporal alignment between words and speakers.
Load came from k6 inside the cluster with a one-stream control on an idle replica in every run; every server frame is archived.
To establish reliable capacity limits for production infrastructure, we benchmarked total concurrent streaming capacity per GPU under continuous load tests. Figure 5 illustrates latency performance across varying concurrent stream counts on a single NVIDIA RTX PRO 6000.
The stress test results demonstrate flat latency scaling up to maximum hardware saturation points. By managing hardware resources strictly within predictable GPU utilization boundaries, system latency remains stable near single-stream baseline values until hard capacity limits are reached.
Using identical files and hardware, Baseten’s optimized serving preset delivered ~1.35x higher batch processing throughput than the NVIDIA reference setup used in our testing. Over an HTTP connection, a single GPU can continuously process 200 six-minute audio files every minute while maintaining steady response times.
For live transcription, the streaming and batch setups deliver virtually identical accuracy, successfully reconstructing speaker-tagged transcripts straight from the speech recognition model.
Nemotron 3 Diarization is available on Hugging Face:https://huggingface.co/nvidia/Nemotron-3-Diarization and in the Baseten Model Library:https://www.baseten.co/library/nemotron-3-diarization/ as batch, streaming, and real-time diarized transcription presets. Deploy one in a couple of clicks, pick a latency profile per request, and pair it with the ASR you already run — or talk to our engineers:https://www.baseten.co/talk-to-us/?model=nemotron-3-td-nemotron-asr about how we can optimize your voice workload.
Stay up to date on model performance, inference infrastructure, and more.

 扫码直达文章详情