在 Modal,我们运营着多个这样的编程智能体推理服务,并与多位客户合作,也提供类似服务。您可以通过推理路由平台间接使用我们的服务,如 OpenRouter:https://openrouter.ai/provider/modal 或 Vercel AI Gateway:https://vercel.com/ai-gateway/models/providers/modal,或者直接通过我们的共享终端:https://modal.com/endpoints/。
在这篇博客文章中,我们将介绍如何在从 Moonshot AI 的 Kimi K2.6 模型(链接:https://huggingface.co/moonshotai/Kimi-K2.6)为编码代理提供推理服务时优化推理性能。虽然按照该领域的标准,这个模型是“旧的”(字面意思是已经有数百天历史了!),但序列建模、硬件和扩展的基本原理变化足够慢,因此核心内容和许多细节与我们为更近期、在智能和性价比上超越 K2.6 的模型(如 Kimi K3:https://modal.com/library/moonshot/kimi-k3)所做的工作相符。
其次,互动性特别适合通过推测解码进行改进:https://modal.com/blog/achieve-sota-specdec。因为这是一种简单、基于学习的技术,其性能收益会随着计算能力和数据量的增加而扩展:机器学习著名的“苦涩教训”:http://www.incompleteideas.net/IncIdeas/BitterLesson.html,在 ML 系统的性能工程中再度显现。我们也知道如何扩展训练:https://modal.com/blog/reinforcement-learning-infrastructure-problem。
Software is eating the world :https://a16z.com/why-software-is-eating-the-world/ , and agents are eating software engineering :https://martinalderson.com/posts/ai-agents-are-starting-to-eat-saas/ . It is imperative that software engineers develop an understanding not just of the agent software that is now their most important tool but also of how the intelligent core of agent software works, through inference by large generative models of language — if not out of the engineer’s need to understand and control their tools, then at least because inference is poised to consume more computing power and produce more benefit than all other uses of computers.
The central fact about inference services for coding agents is that they must operate at extremely high relative and absolute performance.
By relative performance, we mean large fractions of the peak rate or “speed of light” :https://modal.com/gpu-glossary/perf/peak-rate of the hardware that it uses. By absolute performance, we mean that the scale of that peak rate and the amount of work done per request is large. Contemporary matrix math accelerators like Tensor Cores :https://modal.com/gpu-glossary/device-hardware/tensor-core operate at the petaFLOP per second scale. Large generative sequence models with sufficient intelligence to automate software development have trillions of floating point parameters, and each of them must be accessed many times per second, even when serving just a single request.
Due to these requirements, economically viable coding agent inference services are currently only feasible by operating at a scale sufficient to amortize hardware and engineering costs — roughly, at the scale of trillions of input and output tokens.
We’ve done this, and we’d like to share how.
At Modal, we operate a number of such inference services for coding agents at this scale and work with a number of customers who do the same. You can use our services indirectly via inference routing platforms like OpenRouter :https://openrouter.ai/provider/modal or Vercel AI Gateway :https://vercel.com/ai-gateway/models/providers/modal or directly through our Shared Endpoints :https://modal.com/endpoints/ .
In this blog post, we will walk through how we optimized inference performance when serving inferences from Moonshot AI’s Kimi K2.6 :https://huggingface.co/moonshotai/Kimi-K2.6 model to power coding agents. Though this model is “old” by this field’s standards (literally hundreds of days old!), the fundamentals of sequence modeling, hardware, and scaling change slowly enough that the core story and many of the details match what we have done for more recent models that have superseded K2.6 in intelligence and cost-performance, like Kimi K3 :https://modal.com/library/moonshot/kimi-k3 .
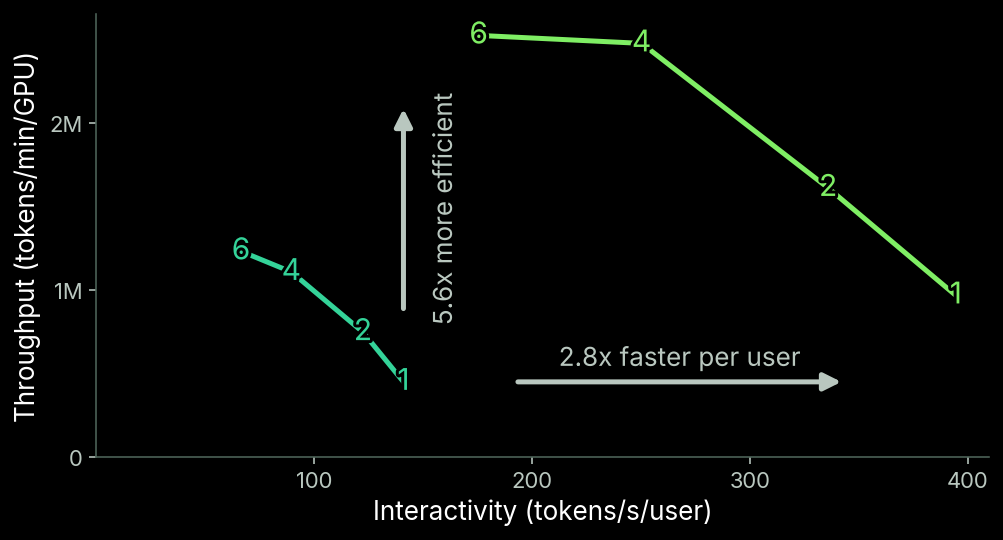
Our optimizations allowed us to scale per-replica performance of inference replicas by 2.8x per user and 5.6x across users on the replica:
This chart relates the individual user’s experience (decode tokens per second per user, aka interactivity ) on the x-axis with the cost-performance of the overall system on the y-axis (total tokens per minute per GPU, aka token throughput), with the number of concurrent users indicated at each point.
More intuitively, that’s the difference between a ruinously expensive service with the UX on the right below and a price-competitive service with the UX on the left:
We then scaled those single-container replicas into deployments and services. One particular service processed hundreds of billions of tokens a day and trillions in aggregate:
Below, we aim to make this performance engineering legible to a general software engineering audience. By sharing how we, and our customers, are able to operate these services, we hope it enables you to do the same — perhaps by deploying a Dedicated Endpoint :https://modal.com/docs/guide/endpoints on Modal.
We break this down into two sections: understanding the sequence model that infers the response to each request and understanding workload structure across requests.
Contemporary coding agents are powered by probabilistic generative models of unicode sequences pre-trained mainly via unsupervised masked sequence prediction and post-trained mainly by reinforcement of output software correctness. Like the parser of a compiler, they operate not on raw strings but on tokenized sequences, so we call their inputs and outputs tokens . Because we are, in the end, guessing what output tokens should be, this is called inference . If you prefer deduction, stick to databases and operating systems.
The underlying sequence models these days are hybrid-attention, mixture-of-experts Transformer neural networks . These networks apply computations both per token in the sequence and across tokens in the sequence .
Attention has evolved into a generic term for cross-token computation. Mixture-of-experts refers to the dynamically routed block-sparse matrix multiplication that applies the majority of the per-token computation. These computations iteratively update the network’s internal, or latent , representation.
For insight into what’s going on inside these sequence models, see Anthropic’s “A Mathematical Framework for Transformer Circuits” :https://transformer-circuits.pub/2021/framework/index.html (2021, but still undefeated).
A single forward pass through such a neural network produces both substantial internal state and a probability distribution over the next token(s) in the sequence for each sequence position. Because we predict ( ”regress” :https://en.wikipedia.org/wiki/Regression_toward_the_mean ) based on our own outputs (”auto”), this is autoregressive sequence modeling.
To respond to a client request, we generally chain multiple forward passes together like this:
Forward passes are expensive, so we want to amortize this work as much as possible. Much of the work in per-token computation amortizes by batching several sequences together. Much of the work in cross-token computation amortizes by caching the internal state. For historical reasons, this is called the key-value cache (KV cache or just KV ), even though contemporary models like Kimi don’t have distinct keys and values. You can read more about the “napkin math” here in Kipply’s excellent “Transformer Inference Arithmetic” blogpost :https://kipp.ly/p/transformer-inference-arithmetic (2022, but still undefeated).
When a forward pass processes a request’s input tokens, we call it a prefill , because it is “prefilling” the KV cache. When a forward pass produces a response’s output tokens, we call it a decode , because we are “decoding” the model’s “encoding” of past state into predicted future. What about forward passes that do both? Yeah, we don’t like the terminology either.
Prefill performance is mostly tracked by the latency to complete all prefills for a request, aka time-to-first-token (TTFT). Decode performance is mostly measured by the rate at which output tokens are produced after that, aka output tokens per second (TPS). Both can be measured client-side or server-side, causing no end of confusion.
The particular sequence model covered in this post is Kimi K2.6 :https://huggingface.co/moonshotai/Kimi-K2.6 by Moonshot AI. This model parametrizes its matrix multiplications with approximately one trillion numbers ( weights in its matrices), the majority of which are stored as four bit integers (INT4).
We serve the model, however, with four bit floating point numbers (FP4) :https://modal.com/llm-almanac/quant-formats/0x6 . Four bits only gives you sixteen distinct values, so you further need a micro-scaling format :https://modal.com/llm-almanac/block-quants/mx-fp8-e4m3 to scale individual blocks within tensors independently. We chose the NVFP4 micro-scaling format :https://modal.com/llm-almanac/block-quants/nvidia-fp4 , which has native hardware support at the petaFLOP/s scale in the Tensor Cores :https://modal.com/gpu-glossary/device-hardware/tensor-core of Blackwell Streaming Multiprocessor Architecture :https://modal.com/gpu-glossary/device-hardware/streaming-multiprocessor-architecture GPUs like the B200 and B300. Because we operate a dynamic GPU fleet in a time of constrained compute supply, we prepare our deployment to run on both B200 and B300 GPUs. Results below are all for B200 GPUs; B300s are substantively similar but operate at higher request concurrency because they have more high-bandwidth memory (HBM) :https://modal.com/gpu-glossary/device-hardware/gpu-ram available for caching.
We chose the SGLang inference engine as our base. We found several opportunities to improve performance by patching the engine. As contributors to the SGLang project, we upstreamed these patches, described and linked in the post below.
When you serve such models on coding agent traffic naïvely, you get bad results.
This chart indicates that throughput and interactivity rapidly collapse above 6 concurrent users. Furthermore, even before that peak, the interactivity is below user expectations and the system is below acceptable efficiency.
So from here, you need to increase interactivity and throughput to deliver better outcomes to users while decreasing your own costs. To do that, you need to understand the sequences in this workload deeper than just “tokens in and tokens out”.
Individual requests for output tokens are created in “sessions”: the user, the generative model, and the tool calls chain together iteratively to construct a tower of input sequences, accumulating context — and value — over time. The iterative process of meaning construction, information discovery, and sense-making strikes us as fundamental to the nature of sequence modeling and sequential action, so we expect this pattern to far outlast “coding agents”.
Concretely, a single session looks something like this:
That is, the input sequence (green) for each turn T is the entire session history up to T (darker green), plus something new (lighter green). This has two key consequences.
First, it means requests inherently have long input sequences relative to their output sequences (pink, above) — there are T-1 past output sequences in the input to turn T, and T is in the dozens. For the core workload we used in optimization and served in production, this ratio was 200:1; requests contain roughly 100k input tokens and produce roughly 500 output tokens. That means the majority of processed tokens will be input tokens (just check the token usage numbers in your coding agent software).
Second, it means the input sequences have high overlap with previously processed input sequences — the ones from turns 1 to T-1. That means that on the way to serving turn T, the tokens in turn 1 are processed T times. This makes caching absolutely critical — we can avoid linearly-scaling recomputation to save effort, but we introduce linearly-scaling state that must be managed and has its own performance characteristics. Navigating this tradeoff is the core engineering problem we’ll tackle in this post.
With this picture of the workload in mind, we turn to optimization.
To optimize performance :https://modal.com/gpu-glossary/perf/performance-bottleneck , build a working system, identify the bottleneck, then lift it. Repeat as needed until you’ve won.
Though our ultimate goal was to optimize an entire service, we decomposed that problem into two simpler problems: optimize a single replica first, then scale from one to many replicas.
We further split the problem of single replica performance into two sub-problems: first maximize interactivity, then maximize throughput without losing interactivity.
Interactivity primarily impacts request latency. Request latency and throughput interact through concurrency , the number of in-flight requests, by a rearrangement of Little’s Law :https://modal.com/gpu-glossary/perf/littles-law :
Our key bottlenecks for latency, concurrency, and throughput started in the GPU HBM :https://modal.com/gpu-glossary/device-hardware/gpu-ram .
Our key bottleneck on latency was HBM bandwidth :https://modal.com/gpu-glossary/perf/memory-bandwidth during decode. We lifted it by parallelizing matrix multiplication across GPUs (tensor parallelism, TP) and by applying custom DFlash :https://www.lmsys.org/blog/2026-06-15-next-generation-speculative-decoding-dflash-v2/ speculative decoding :https://modal.com/blog/spec-is-all-u-need — doing more computation per memory load, even when that computation may not be needed.
That created a bottleneck on concurrency through HBM capacity : how much work can we keep in a cache that loads faster than we could just recompute results. We lifted it by clearing up intermediates in HBM, quantizing intermediates to lower floating point precision :https://modal.com/llm-almanac/quant-formats/ , and extending the cache hierarchy to CPU RAM with HiCache :https://www.lmsys.org/blog/2025-09-10-sglang-hicache/ . We used the cache hit rate (CHR) as a targeted metric of improvements to caching. CHRs between one and two 9s are very much feasible for most coding agent workloads.
Increasing interactivity increases the system performance as observed by individual users. We chose to work on this first. We made that choice for several reasons.
First and simplest, we found that coding agent users enjoy and will pay more for tokens that come to them faster, so high interactivity was key to building the service that our and our customers’ users wanted.
Second, interactivity is particularly amenable to improvement by speculative decoding :https://modal.com/blog/achieve-sota-specdec . Because it is a simple, learning-based technique, its performance benefits scale with compute and data: machine learning’s famous “bitter lesson” :http://www.incompleteideas.net/IncIdeas/BitterLesson.html , returning in performance engineering for ML systems. And we know how to scale training :https://modal.com/blog/reinforcement-learning-infrastructure-problem .
This choice to interactivity-maxx had two additional benefits, one operational and the other for throughput, which were especially salient because we operate a dynamic, autoscaling fleet :https://modal.com/blog/resource-solver of thousands of GPUs :https://modal.com/blog/gpu-health .
Maximum interactivity replicas are smaller and therefore easier to serve.
Using multiple processors together requires an interconnection network (interconnect) for communication. The lowest latency, highest bandwidth interconnect for Nvidia GPUs is NVLink. NVLink operates across a group of processors in a “domain” of some size.
A single host operating system can support an NVLink domain of up to 8 GPUs. The largest NVLink domains that are generally available comprise 72 accelerators (in a multi-node IMEX domain :https://docs.nvidia.com/multi-node-nvlink-systems/imex-guide/overview.html ). Using more accelerators would require a slower interconnect (IB/RoCE or, worse, standard Ethernet). That means that for maximum interactivity we should not expect to use more than 72 accelerators per replica — the communication overhead will almost surely dominate any per-request latency wins.
But that doesn’t mean we must use 72 accelerators.
Consider these results from SemiAnalysis’s InferenceX benchmarks for this same NVFP4 Kimi K2.6 model :https://inferencex.semianalysis.com/inference/kimi-k26 , which show throughput per GPU as a function of interactivity, annotated with GPU count, for a variety of deployments:
The highest interactivity is achieved by a deployment with just eight GPUs per replica. Furthermore, that interactivity is achieved with comparable throughput per GPU, which means that by choosing a smaller domain, we are not obviously forgoing peak throughput cost-performance (subject to our interactivity constraint).
To keep the chart legible, we selected only a small subset of deployments most similar to ours, but the pattern holds across more accelerator types and across more models in the InferenceX benchmarks (explore them here :https://inferencex.semianalysis.com/inference/kimi-k26 ). Generally, you can achieve the highest interactivity at comparable per-GPU throughput with only four or eight GPUs. You can then achieve the same aggregate throughput by scaling smaller replicas. The core Modal serverless platform :https://modal.com/blog/truly-serverless-gpus makes this scaling performant and reliable.
This is a huge operational win. Smaller, simpler units make for easier scaling. Eight GPUs can be driven by a single host OS kernel. An NVL72 domain, on the other hand, is comprised of nine such subsystems sharing an address space (yes, you should be shuddering). Availability is constrained and contracts are long and inflexible.
Eight-GPU Blackwell systems, on the other hand, are standard enough to be available via on-demand and spot markets, which makes it much more cost-effective to handle variable load :https://modal.com/blog/how-to-price-serverless . Replicas with one, two, or four GPUs can furthermore be packed inside of a single physical eight-GPU machine — which already has all the resources required to start another replica (model weights, JIT artifacts).
Of course, as and if the compute supply and user demands change, we will happily revisit this choice.
By reducing the latency of individual requests, we indirectly improve throughput by freeing up resources for new requests.
Agentic coding workloads are approximately “closed-loop” per session. Sessions are almost always chains — of user-written tokens, of tool call responses, and of model outputs. The next request in the session, therefore, almost always arrives some time after the previous response has finished generating. The session’s next request is therefore latent for some time, outside the inference system — for tool calls, 10s of ms to seconds with a tail of minutes; for user responses, seconds to minutes, with a tail of hours or more.
During that time, other requests can be processed on the same node. When you have sufficient load for the active capacity, there are always requests ready for a node to process. When you have sufficient capacity for the active load, there are always nodes to map requests onto. Both of these are guaranteed by our fast autoscaling system :https://modal.com/blog/truly-serverless-gpus . We’ll talk more about request routing in the section on scaling to multiple replicas.
Interactivity measures output tokens per second per user. Naïvely, autoregressive sequence models like Transformers produce these tokens sequentially. Amdahl’s heartbreaking Law strikes again.
情报判断
Aioga 编辑摘要
Modal 官方工程博客介绍了为 Moonshot AI 的 Kimi K2.6 编码 Agent 提供推理服务的优化实践。文章称,优化后单副本每用户性能提升 2.8 倍、单副本跨用户整体吞吐提升 5.6 倍。
背景分析
文章指出,编码 Agent 推理服务需要较高的相对与绝对性能,并称经济可行的服务目前需达到足以摊销硬件和工程成本的规模,约为万亿级输入与输出 token。Modal 表示其运营此类服务,并介绍 Kimi K2.6 的优化。
Aioga 观点
Aioga 判断:这篇文章的主要价值在于呈现推理服务的性能与规模约束,以及 Modal 对 Kimi K2.6 的优化结果;这些数据反映的是文中所述服务实践,不应直接视为其他模型或部署环境的表现。
影响与后续
可能影响:关注编码 Agent 推理服务时,需要区分单用户性能与跨用户吞吐指标;文章给出的提升数据不足以说明具体硬件配置、成本变化或其他模型上的效果,也不代表所有服务都能达到相同结果。 后续观察:可留意 Modal 是否进一步披露该优化实践的硬件配置、成本及测试条件,并关注文中提及的较新模型是否有对应的性能数据;在这些信息明确前,不宜外推 Kimi K2.6 的结果。
 扫码直达文章详情