As agents have matured and learned to tackle more ambitious tasks, token spend has shifted. Agents now work for longer and carry more context from one step to the next, making the way we assemble and manage that context increasingly important.
Production traffic · width = share of total spend · shade = billing type
Notes: System & tool defs includes compaction summaries. User text includes manually attached skills. Skills & plugins includes skill descriptions, MCP tool descriptions, and rules that go in static context.
Over the past few months we've responded to this shift by improving the efficiency of Cursor's agent harness. The harness gives us direct control over how each request is assembled, how context is reused, and when work is divided across agents. Changes across each of these layers reduced token costs for users by 7% without reducing agent quality.
Every agent turn includes context supplied by Cursor before the model begins working. This includes the system prompt and definitions for the tools the agent can use. Because this context is included throughout a conversation, it had become one of the largest sources of spend that we fully control.
When models were less capable, we had to spell out instructions for tool usage, task management, and code-change workflows. We also had to guard against strange behaviors like extremely long hash dumps, binary output, and emojis.
As models improved, much of that direction became unnecessary. Instead of long lists of "DO NOT do this," "You must," or "Important" instructions, we could simply define how a tool behaves and models would generally comply. This was true across model families, allowing us to trim roughly 66% of our system prompt.
Over time, we continue to add and remove instructions as new models require new guidance, which then flows into the training of future models. Leveraging A/B tests on a large user base is crucial to effectively optimizing the harness for real traffic. While evals can be a fast and useful proxy, they often represent "hard" problems and don't properly reflect the true distribution of user requests.
The system prompt is only one part of the context Cursor supplies on every turn. Another is tool definitions, which had grown dramatically over the course of the year as we added more powerful capabilities to the Cursor agent, including background shell monitoring, cloud subagents, and more reliable access to web content. Most of these tools are important, but each is needed in fewer than 20% of conversations.
That created an opportunity to improve efficiency by keeping tools available without including their full definitions in every request. We'd solved a similar problem earlier this year when we moved MCP tools into dynamic context, loading them only when needed. This reduced total tokens by 46.9% across sessions that called an MCP tool.
We have now applied the same technique to our own built-in tools.
To decide which tools to keep in static context, we A/B tested several configurations based on how often each tool was used and whether models needed to see it from the start. We tracked token usage, cost, latency, tool-call errors, and overall agent usage to make sure the savings did not degrade quality.
Share of agent conversations invoking each tool at least once
Ultimately, we kept the high-frequency tools for reading, searching, editing, and using the shell in static context. We also retained ask_question , which some models tended to hallucinate calls for, and tools that are crucial to specific product flows, such as create_plan in Plan Mode. The remaining tools now load when the agent needs them.
After reducing the amount of static context in each request, we improved how effectively repeated context could be cached across turns.
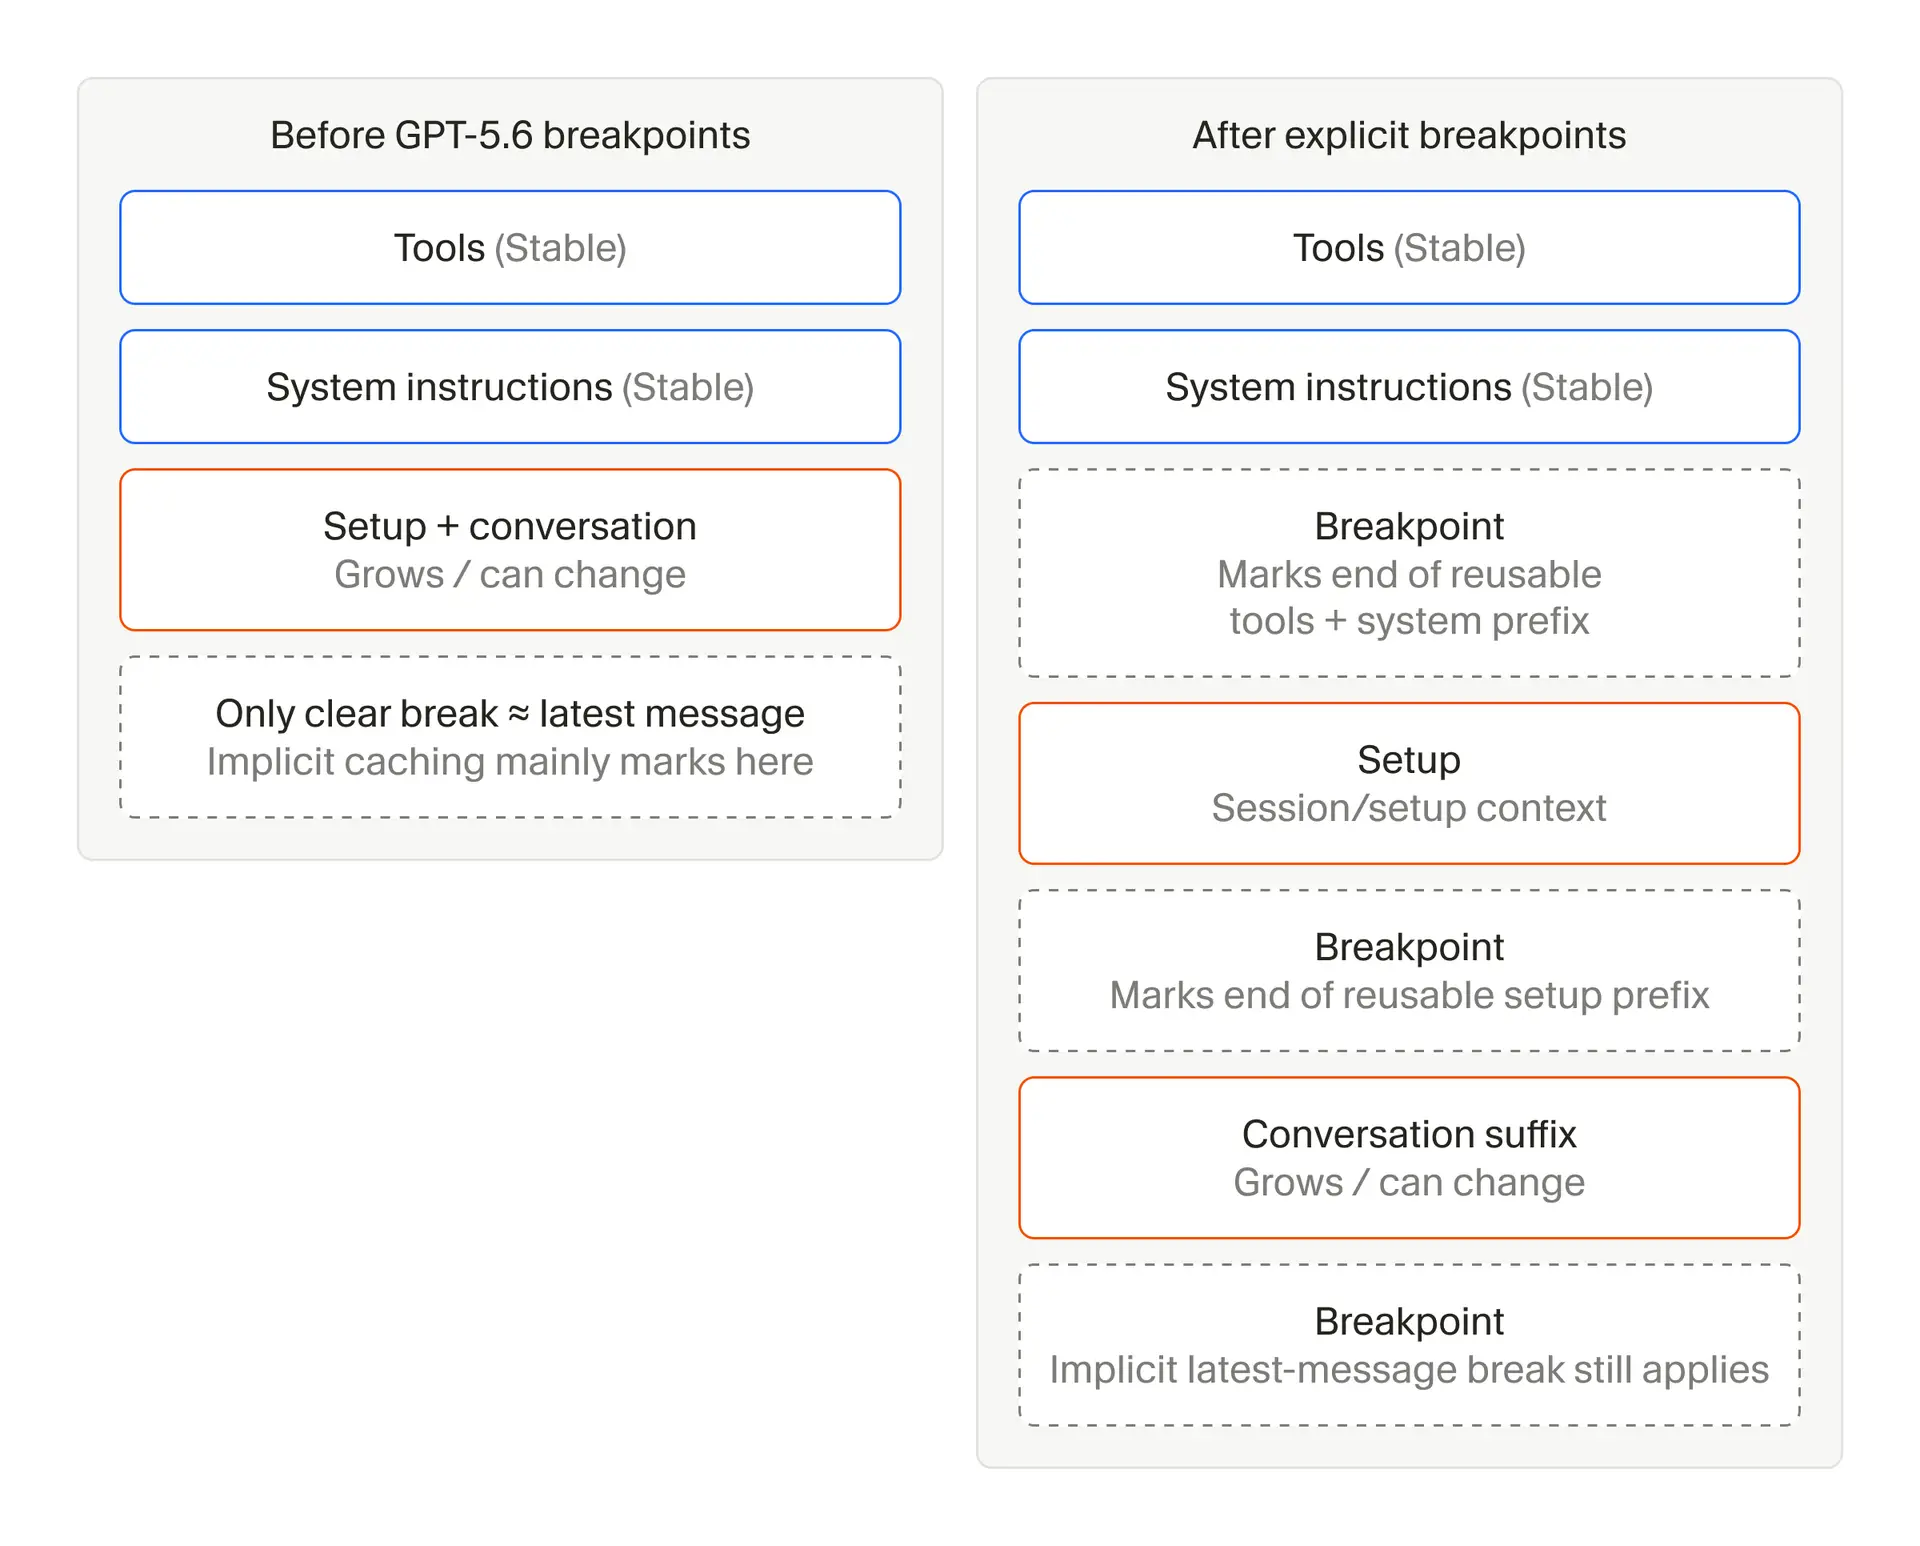
Every agent turn resends a long request containing tools, system instructions, setup, and the conversation so far. Much of the beginning stays the same from one turn to the next, while the conversation at the end continues to grow.
Prompt caching allows the model provider to reuse that unchanged prefix. However, caching configurability can vary by provider. Before GPT-5.6, the cache boundary was determined automatically based on the latest request. Even though tools and system instructions rarely changed, they were not cleanly marked as reusable on their own.
Since GPT-5.6, the OpenAI API allows clients to mark explicit cache breakpoints alongside its default implicit caching. We now place breakpoints after stable layers of the request and before the growing conversation, allowing later turns to reuse more of the unchanged prefix.
Breakpoints only help if the prefix itself stays stable, so we also tightened what sits at the front of each request. We did this by reserving tools and system instructions for content that rarely changes, and by moving more variable setup past the cache boundaries into our "phantom user message." This holds user- and request-specific context like skills, subagents, and environment info.
These changes reduced the rate of cold cache misses by 20%.
Another large source of token spend is the context an agent adds as it works, much of which comes from reading files.
Cursor's agent reads files through a Read tool, which traditionally numbered every line because models are not good at counting lines on their own and need to cite specific sections for the user.
A single line number uses only around three to five tokens, but when an agent reads tens of thousands of lines during a session, numbering every one adds a meaningful amount of context.
We reduced that overhead by including line numbers only on every tenth line. This is still frequent enough for models to cite code properly, and the change reduced cache-read tokens by 1.6% with no reduction in quality.
Longer agent runs create more opportunities to delegate work to subagents. This can reduce token spend because each subagent typically starts with a fresh context window rather than carrying the parent agent's full conversation. Once it reports its results, the parent can continue without carrying the subagent's full working context.
This kind of context isolation between agents and subagents does carry a coordination tax, though, because agents that do not share context can duplicate work or pursue tasks that are no longer necessary.
We made two changes to capture the efficiency benefits without adding unnecessary coordination. First, we removed instructions that strongly encouraged agents to use subagents for codebase exploration. As subagents became more prevalent in training data and researchers incorporated them into post-training, models learned this pattern natively. Removing the extra prompting produced more balanced subagent usage.
We also tightened how subagents select models. Cursor can spawn subagents using any of our available models, which makes it possible to shore up blind spots across models or pair an expensive planning model with a cheaper one for implementation. We updated the tool arguments so agents choose a different model only when directed by the user or the harness.
We'll continue measuring how context accumulates across longer runs and testing where the harness can reduce repeated processing without affecting agent quality. Over time, we expect this will allow token use to grow far more slowly than the amount of work agents can complete. We've also taken these learnings to Grok Bot, where we're working to optimize its unique harness so that users can accomplish the most work at the lowest cost.
Filed under: research:/blog/topic/research
Author s : Jediah Katz, Connor O’Keefe & Calvin Yee

 扫码直达文章详情