像 Kimi K3 这样的推理模型,将其生成的大部分标记,有时超过 90%,用于内部推理,而不是直接给出答案。这种思考结构在单次请求中代价高昂,但在多轮的自主任务中情况会更糟。每一轮都会将之前的所有推理传回模型,因此上下文随着轮数的增加大致呈二次增长。早期轮次的长推理轨迹会在每次后续调用中被重新读取(并重新计费)。
所有这些推理真的有必要吗?我们的实验表明没有。Kimi K3 输出的推理远比任务需求长,多余部分可以在不触及答案的情况下去除。这就是我们如何创建 Ember-1 的方法,它是一个经济版的 Kimi K3,由专门的智能构建而成。
在您的工作负载上尝试 Ember-1:/models/fireworks/ember-1 吗?我们很想听听您的体验,所以请在 X 上标记我们 (@FireworksAI_HQ) 并告诉我们您正在构建什么!
Join us for our inaugural conference, Forge 2026
Ember-1:/models/fireworks/ember-1 is a new specialized model from Fireworks Research that delivers Kimi K3’s quality with 40% fewer tokens. Built on Kimi K3, it learned to cut unnecessary reasoning while keeping the thinking that matters. We tested it on external benchmarks, in live customer A/B tests, and on our own coding and agent workloads, and quality held up in every setting. Available today, Ember-1 kicks off an ongoing series of specialized models by Fireworks, shaped by what developers want next. Ember is just the start of what you could build with the Fireworks Training platform.
We heard from users that they needed K3’s coding capabilities at a lower cost, because its long reasoning traces made automated coding expensive at scale. Turning down K3's reasoning effort didn't solve this. Lower effort settings gave up too much quality. To keep the quality and cut the tokens, the model had to learn to reason more efficiently, and that meant training it.
Getting there took serious research. Our team ran more than 50 training experiments and over 200 evaluations, and developed new training algorithms along the way to shorten reasoning without losing accuracy. We did it all on Fireworks Serverless Training:/training#training-api:~:text=RUN%20THE%20LOOP-,Training%20API,-For%20ML%20researchers. Because we didn’t have to provision or manage GPUs, we could launch experiments as soon as we had an idea, pay only for what we ran, and move from research to launch in a fraction of the usual time and cost.
We trained across a broad set of tasks so the token savings would carry over to many workloads. We then evaluated Ember-1 on the Specialized Intelligence Index:/specialized-intelligence-index/, public benchmarks, and live production traffic to confirm it used fewer tokens with no drop in quality. Ember-1 is Fireworks own model and the first in a series of models from Fireworks Research.
Reasoning models like Kimi K3 spend the majority of their generated tokens, sometimes more than 90%, on internal reasoning rather than the answer itself. This thinking structure is expensive on a single request, but it gets much worse in multi-turn agentic workloads. Every turn replays all prior reasoning back to the model, so context grows roughly quadratically with the number of turns. Long reasoning traces from early turns get re-read (and re-billed) on every subsequent call.
Is all that reasoning actually necessary? Our experiments said no. The reasoning Kimi K3 emits is far longer than the task requires, and the excess can be removed without touching the answer. This was how we created Ember-1, an economic version of Kimi K3 built from specialized intelligence.
Not all of K3's reasoning is wasted. Some of it is self-reflection: revisiting an assumption, responding to feedback, or tracing an outcome back to an earlier decision can help the model recover from mistakes. The opportunity is to preserve this ability while reducing unnecessary reasoning and escaping unproductive loops. We believe that learning from tasks and environment feedback can teach the model to reason more efficiently while maintaining its capabilities.
For agentic tasks, this learning extends across the interaction. The model explores possible actions, incorporates new observations, and refines its reasoning as it progresses. Feedback connects decisions to their consequences, encouraging useful reflection throughout the task.
We carried these insights into a training collection spanning mathematics, coding, instruction following, conversation, search, tool use, and software engineering, covering both standalone problems and extended interactions to enforce adaptation to observations and outcome. Task feedback guides on-policy planning and learning, with an emphasis on preserving capability across this range of settings.
Results on public benchmarks and live A/B tests support this direction: across seven benchmarks and two customer production traffics, Kimi K3’s reasoning could be shortened by 35–50% without sacrificing accuracy. The internalized behavior also shows restrained token use on unsuccessful attempts, reducing prolonged, unproductive reasoning.
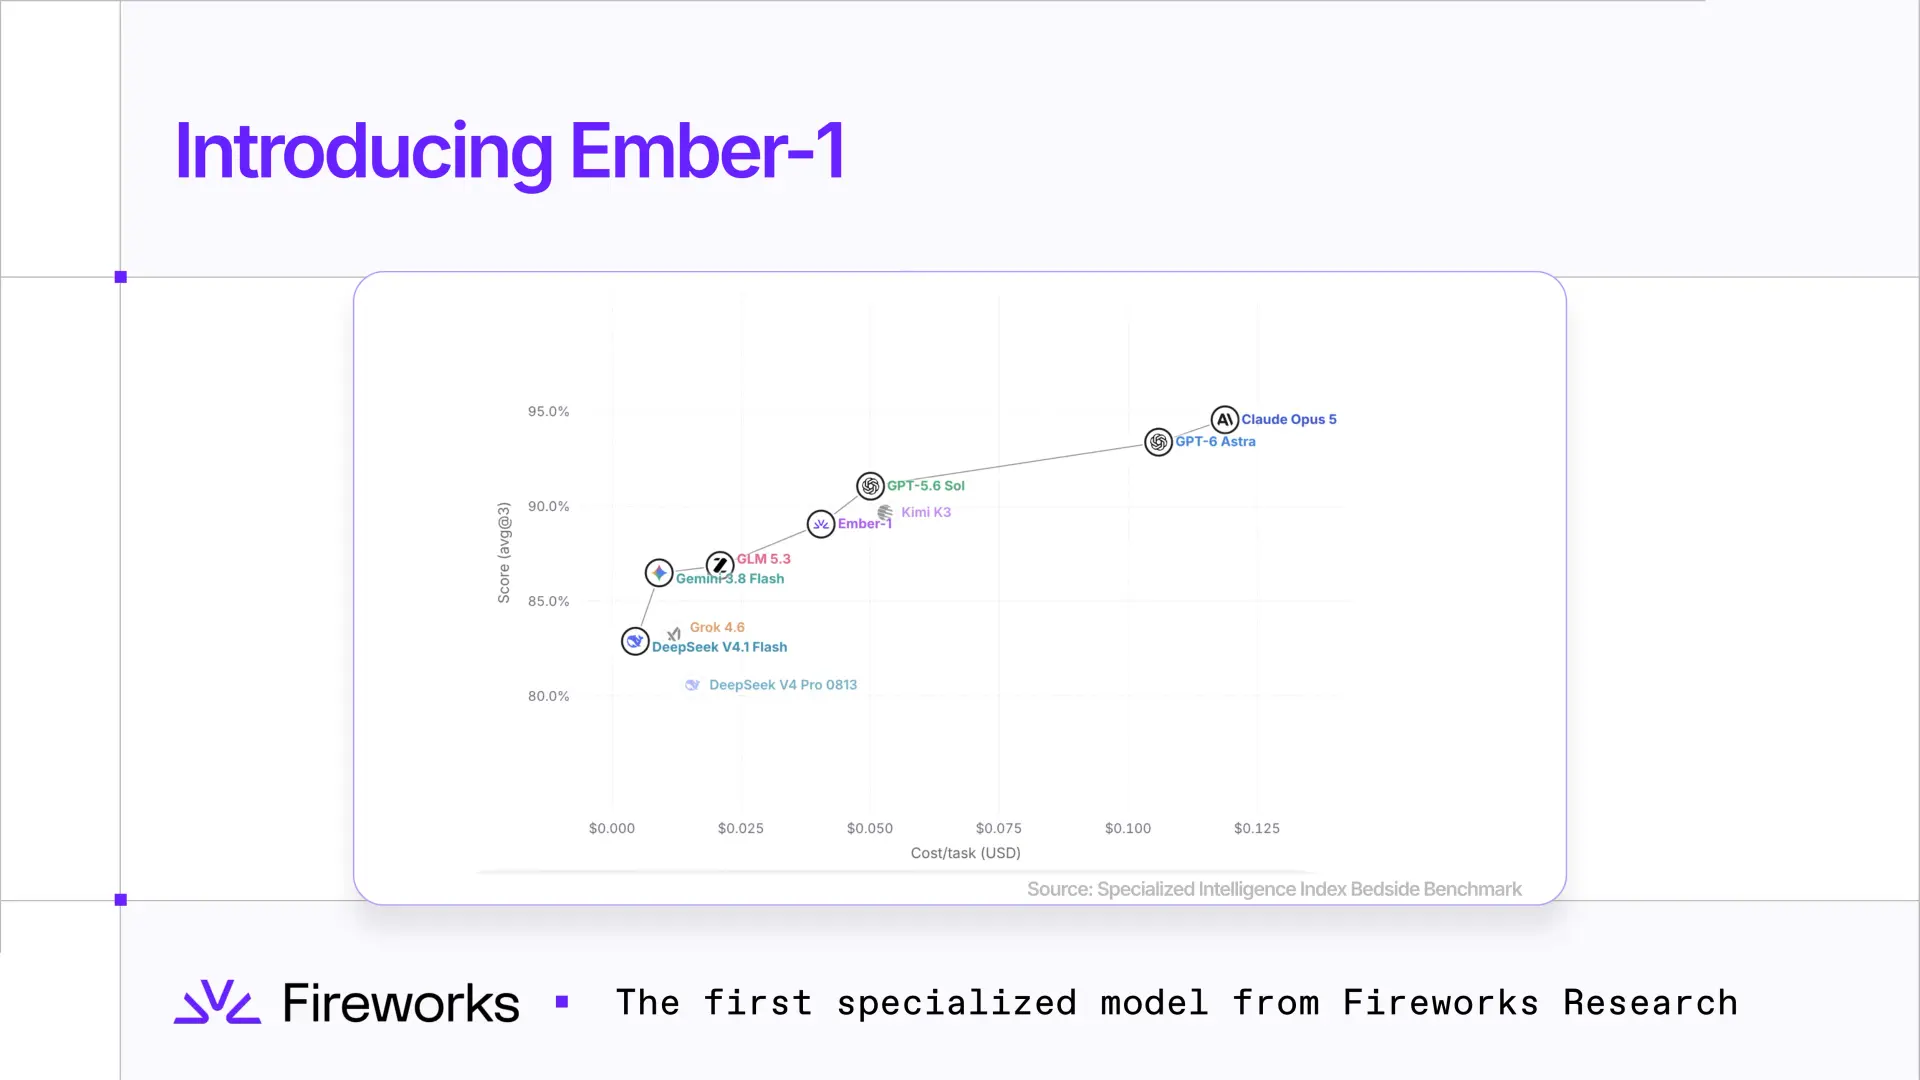
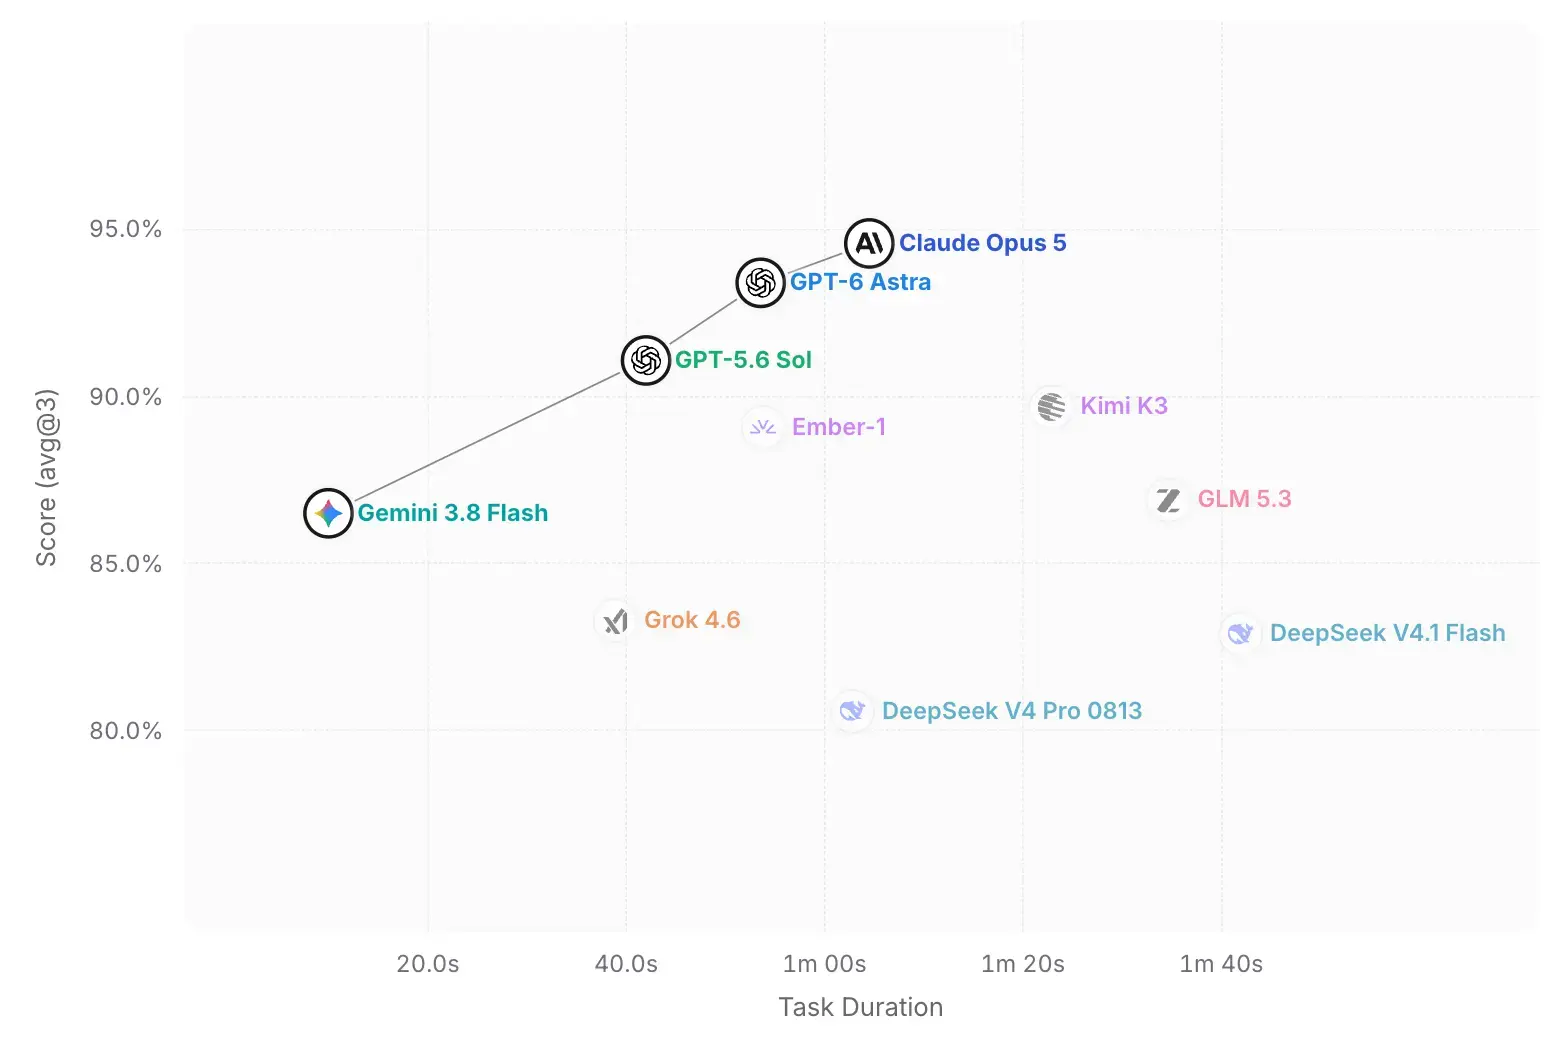
Earlier this week, we introduced the Specialized Intelligence Index (SII):/specialized-intelligence-index/ to benchmark open, closed, and specialized models against real-world tasks created by industry experts.
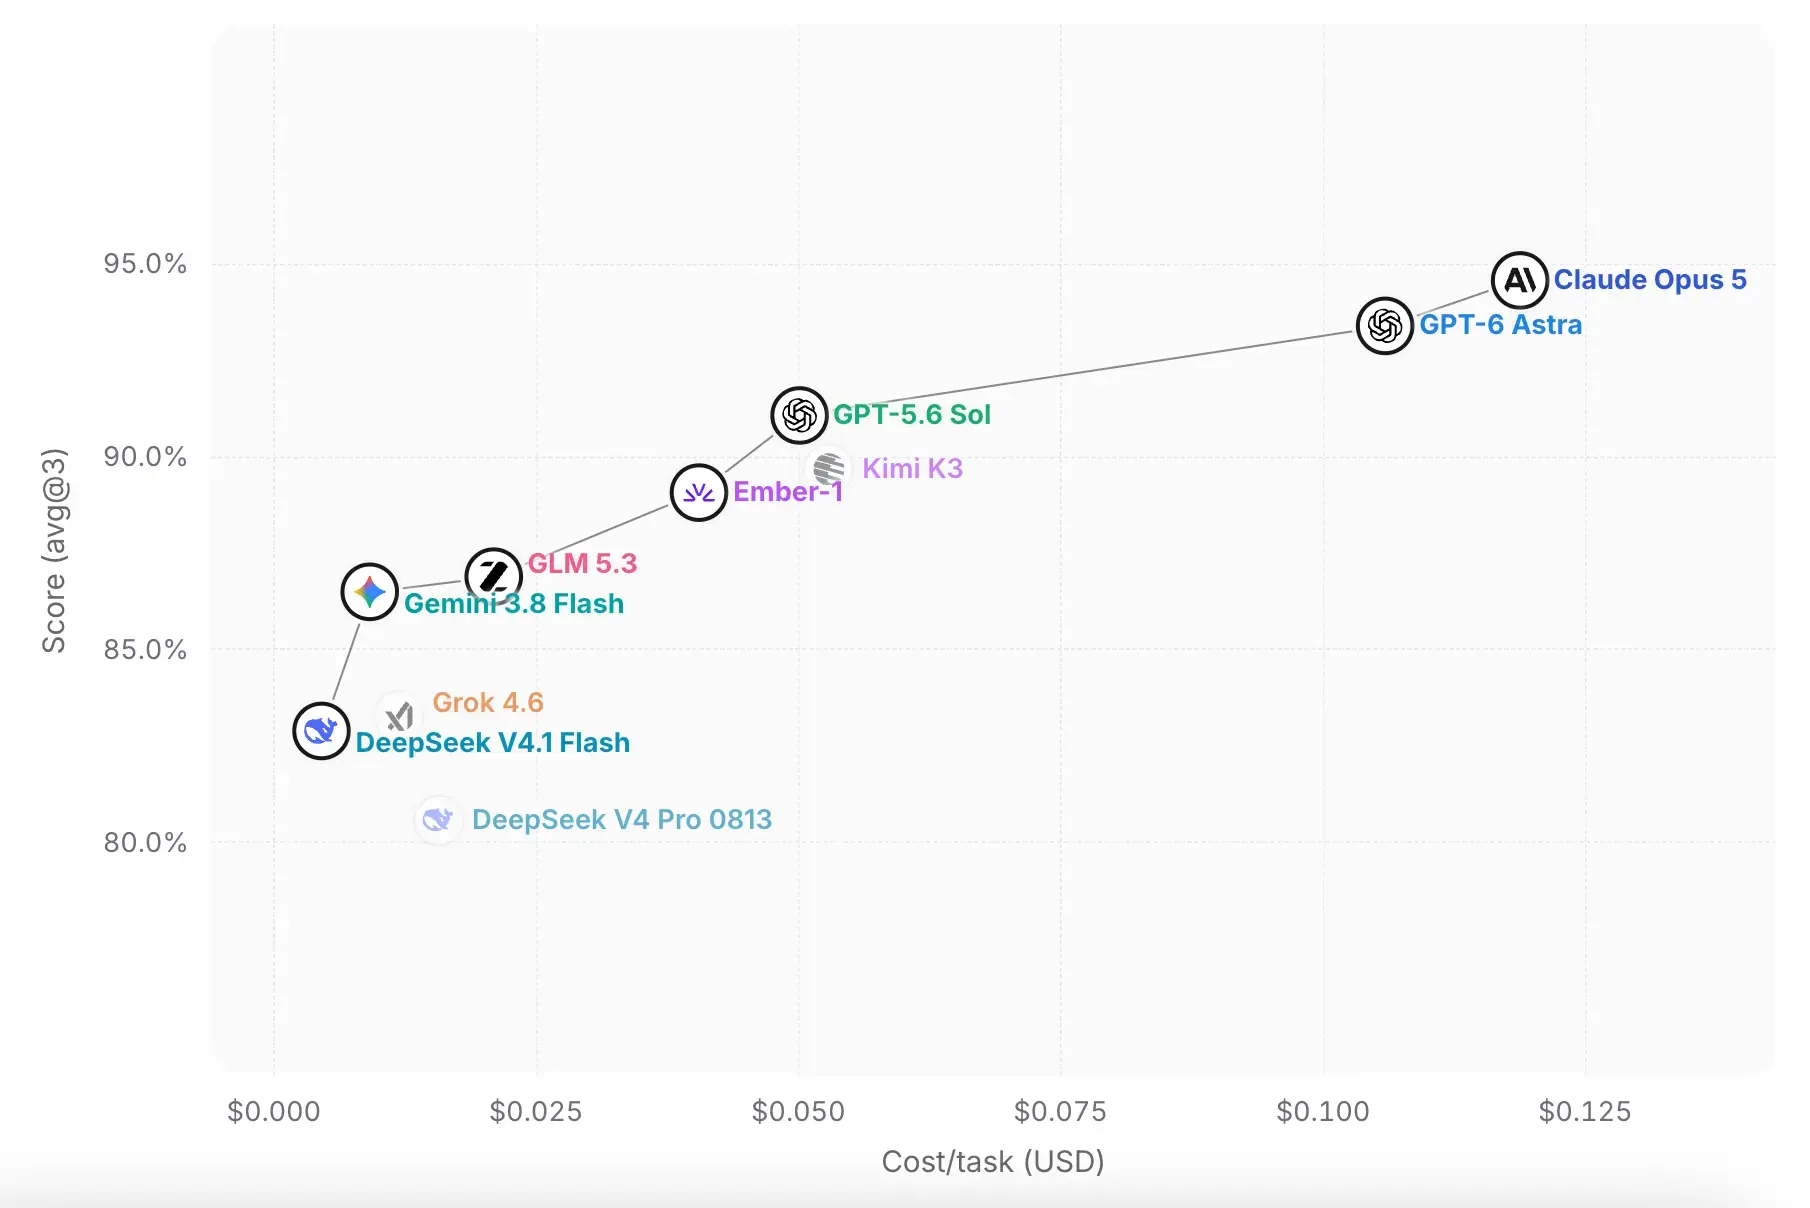
We evaluated Ember-1 on Doximity’s Bedside Bench, a physician-validated benchmark spanning 500 clinical cases across 10 specialized categories.
The result? Ember-1 set a new pareto frontier for Bedside Bench across both open and closed models including GPT.5 Sol, GPT-6 Astra, and Claude Opus 5 on cost/task.
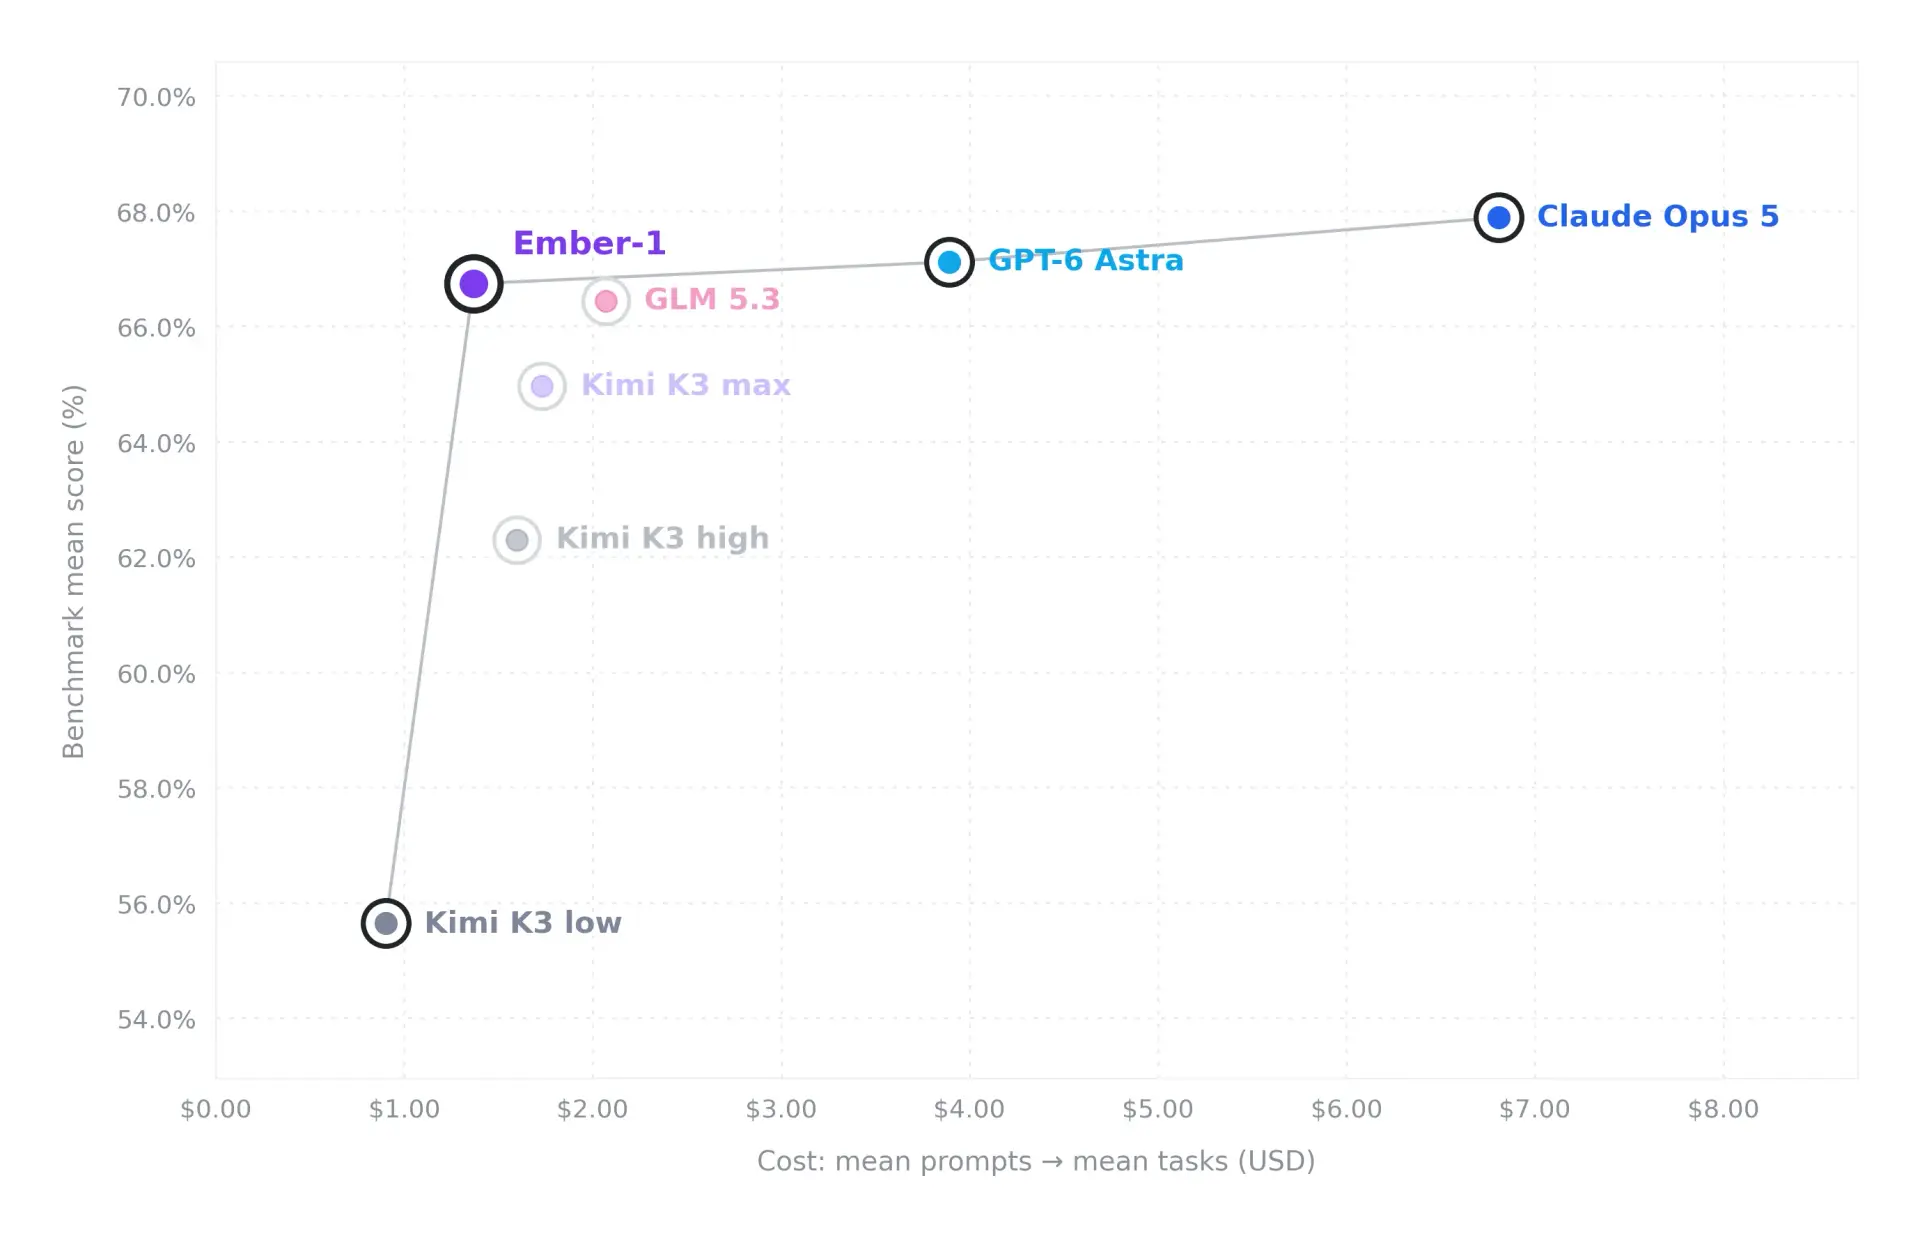
We also evaluated Ember-1 on the quality-vs-cost frontier across some other industry benchmarks. We computed per-benchmark cost using the public Kimi K3 API pricing (uncached input $3/M tokens, cached input $0.30/M, output $15/M) and plotted it against pass rate for three arms: K3 at reasoning effort low , K3 at reasoning effort high, K3 at reasoning effort max (default) , and Ember-1. Across every benchmark with more than 50 test samples, Ember-1 sits on or near the Pareto frontier, matching K3-max quality at a fraction of the cost, and strictly dominating K3-low. We also analyzed GPT-6 Astra, Claude Opus-5, GPT 5.6 Sol and GLM 5.3, and found that Ember-1 was a leader on the Pareto Frontier.
We took a double-click on the results directly comparing Ember-1 to the original K3, and found the following results:
The most cost optimized way to run K3 is no longer to make it think less, but it’s to run Ember-1 the model that learned to think efficiently.
Benchmarks only tell you so much. Like what we found in the Specialized Intelligence Index results, we wanted to test the model on more real workloads, and to test the model using production traffic. The real test is often whether the model holds up on production traffic, in products users depend on.
We ran live A/B tests with two customers on their production coding workloads. In both cases, Ember-1 delivered impressive token savings, approximately 35% fewer tokens per task at comparable quality . Most of the downstream product metrics held or improved including task completion, success scores, and failure rates all moving in the right direction at substantially lower token cost. Following the A/B tests, one customer is now running Ember-1 in live production, with plans to scale it up to replace the base model entirely.
A large part of Fireworks internal coding/cowork traffic is powered by our own inference service. Before any customer saw the model, we put Ember-1 into Fireworks' internal and let our own developers use it for everyday coding work including things like vibe testing at scale on real tasks.
The outcome we're proudest of: no news. No news is good news. Developers carried on their coding workloads without noticing the switch, while consuming substantially fewer tokens. For a model whose entire value proposition is "same answers, fewer tokens," an invisible rollout on internal traffic is the strongest possible signal.
Ember-1 is rolling out as a serving option alongside the base Kimi K3 model as a Research Preview release on Serverless.To support the rapidly growing open-source ecosystem, we're introducing research releases to give developers two-week serverless access to new research models, making them permanent based on community demand. For agentic coding and other workloads where reasoning tokens account for most of the cost, it delivers the same quality at roughly half the token cost.
Fireworks Research will continue to push the frontier of model efficiency by bringing specialized intelligence to more Ember models to enable you to deploy the most economic models, and reduce your token spend.Token efficiency is becoming a theme of Fireworks.
Looking to take Ember-1 one step further, and optimize it for your use case? We are also launching training support for Ember-1, enabling enterprises to build customized, token-efficient models tailored to their needs with their own data. The future of open-models is specialized models trained on your specific workload.
Trying Ember-1:/models/fireworks/ember-1 out on your workloads? We'd love to hear about your experience, so tag us on X (@FireworksAI_HQ) and let us know what you're building!
情报判断
Aioga 编辑摘要
Fireworks Research 发布专门化模型 Ember-1。来源称,该模型基于 Kimi K3 训练,在保持同等质量的同时减少约 40% 的 token 消耗,现已提供,并被称为 Fireworks Research 系列模型的首款产品。
背景分析
Fireworks 表示,用户希望以更低成本使用 Kimi K3 的编码能力,而降低推理力度会损失过多质量。团队进行了超过 50 次训练实验和超过 200 次评估,并在公开基准、生产流量及多类任务中测试 Ember-1。

 扫码直达文章详情