Prime Intellect 发布推理平台 Prime Inference,已上线 GLM-5.3 端点
Prime IntellectAioga 编辑团队2026-10-01T16:00:00.000Z热度 72
Prime Intellect 发布推理平台 Prime Inference,提供 serverless 端点与预留容量,跨数据中心服务前沿开源模型,内部每天处理近一万亿 to...
行业动态Prime Intellect
今日 AI 情报摘要
Prime Intellect 发布推理平台 Prime Inference,提供 serverless 端点与预留容量,跨数据中心服务前沿开源模型,内部每天处理近一万亿 token。
中文正文 · AI 翻译
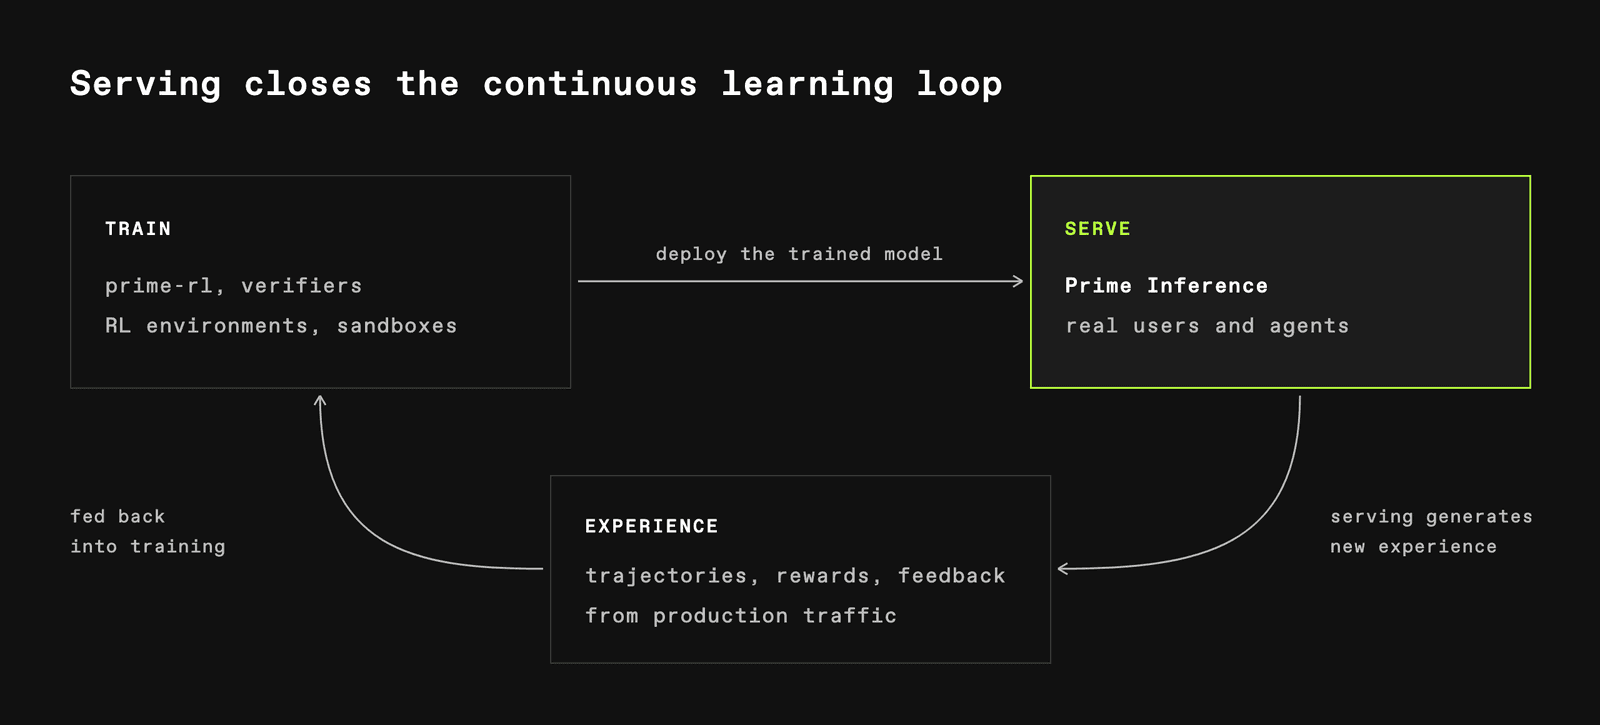
Prime 的使命是构建前沿开放模型和开放超级智能堆栈,以持续改进智能体。我们已经提供了端到端的训练后基础设施,从 prime-rl 和验证器到沙盒和强化学习环境。但持续学习循环只有在训练好的模型能够服务真实用户、生成新经验并将这些生产痕迹反馈到训练中时才算完整。
我们今天很高兴发布 Prime 推理(Prime Inference)。它涵盖无服务器端点和保留容量,并在我们的多数据中心 GPU 基础设施上稳定提供前沿开源模型的服务。
Prime 推理最初是作为我们自己所需的服务平台。早在公开发布之前,它就支持大规模强化学习部署、合成数据生成、评估和长期运行的编码智能体,在内部每天处理近一万亿个令牌。除了我们自己的工作负载,我们自今年一月起也在生产环境中为大规模客户部署提供服务。这种规模推动我们优化持续性能、质量和可靠性,而不仅仅是基准速度。
Prime's mission is to build frontier open models and the open superintelligence stack for continuously improving agents. We already provide end-to-end post-training infrastructure, from prime-rl and verifiers to sandboxes and RL environments. But the continual learning loop is not complete until a trained model can serve real users, generate new experience, and feed those production traces back into training.
We're excited to release Prime Inference today. It covers both serverless endpoints and reserved capacity and offers resilient serving of frontier open-source models on our GPU infrastructure across multiple datacenters.
Prime Inference began as the serving platform we needed ourselves. Long before public release, it powered large-scale RL rollouts, synthetic data generation, evaluations, and long-running coding agents, processing nearly a trillion tokens every day just internally. Beyond our own workloads, we've also been serving large-scale customer deployments in production since January. This scale pushed us to optimize for sustained performance, quality, and reliability, rather than benchmark speed alone.
Our first public deployment, GLM-5.3, went live on OpenRouter on September 22. It currently ranks among the fastest GLM-5.3 endpoints on OpenRouter, with a near-zero tool-call error rate and 100% uptime since launch.
Or point any OpenAI SDK at https://api.pinference.ai/api/v1 . See the docs:https://docs.primeintellect.ai/inference/overview for the full API reference.
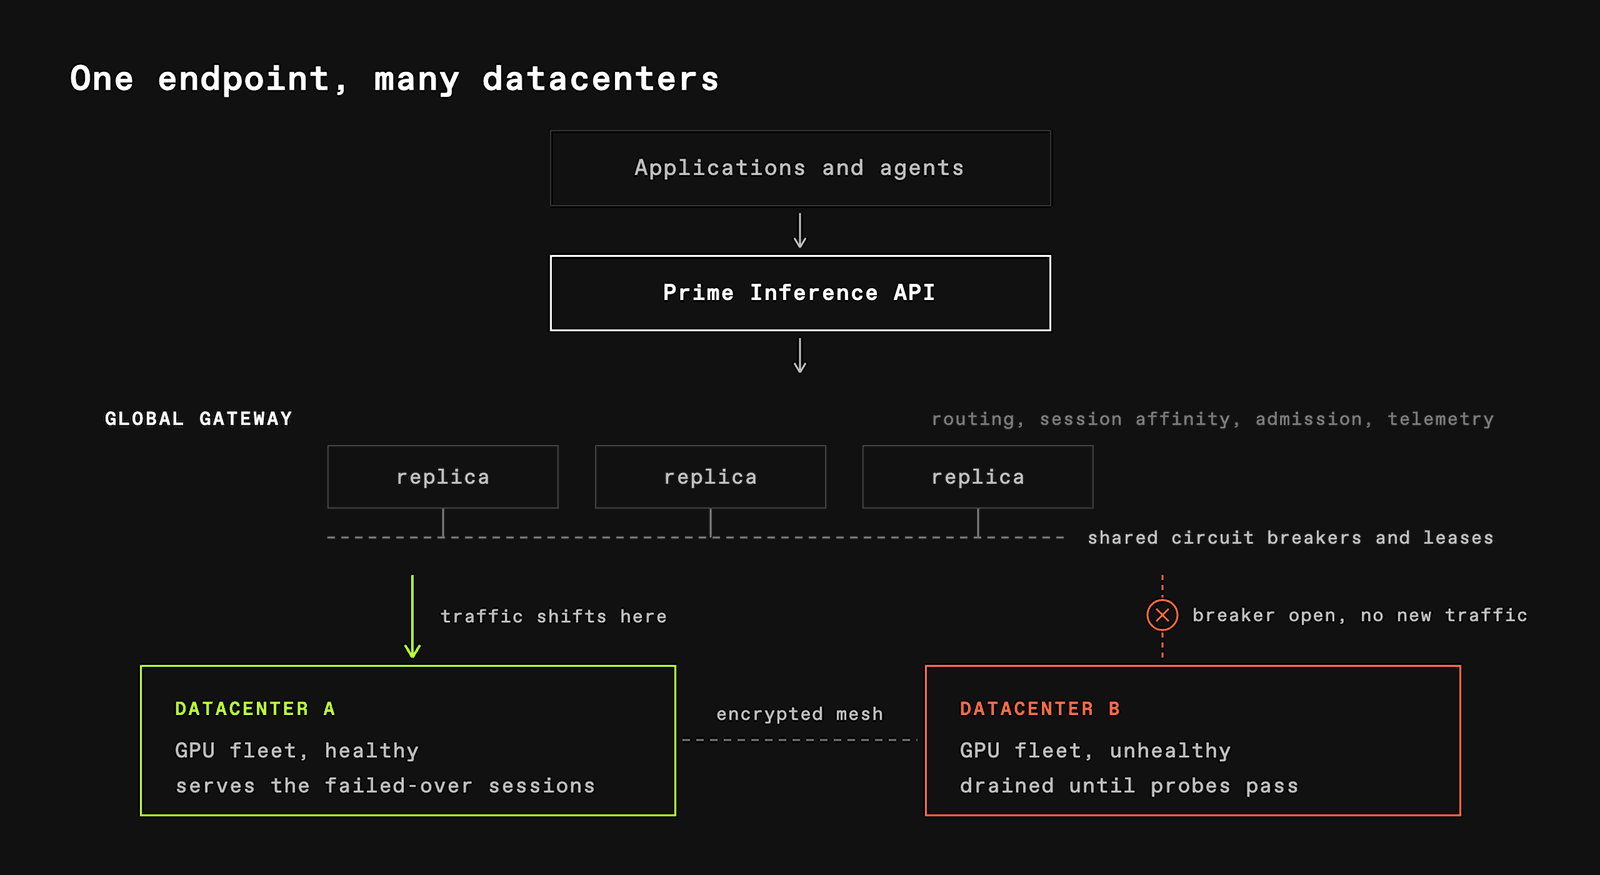
Prime Inference separates the public API from the model fleet, so capacity can move, fail, or scale without changing the client endpoint.
Our shared circuit breakers let every gateway replica react to failures consistently, while lease-based admission control prevents overload and automatically recovers capacity when a process disappears.
Below the software layer, every cluster is continuously monitored, with health checks that reach all the way down to NVLink and InfiniBand. Alerts go to an on-call team staffed 24/7, so GPU failures are caught and repaired quickly instead of slowly degrading service. And because Prime maintains significant overflow capacity, we can reroute traffic and bring up new deployments whenever more capacity is needed.
Together, these safeguards keep the service available. The next sections look inside a production deployment through our work serving GLM-5.3 on GB200 NVL72.
A typical agent turn adds about 6K tokens to a 140K-token prompt, reusing most of the conversation history. Under load, these returning sessions run alongside new requests with long, uncached prompts.
We benchmark this mix with AgentX:https://inferencex.semianalysis.com/agentx from SemiAnalysis, which replays multi-turn agent sessions. Our benchmark harness also injects cold arrivals with long prompts. We measure end-to-end tokens per second per user for interactivity and output tokens per second per GPU for efficiency.
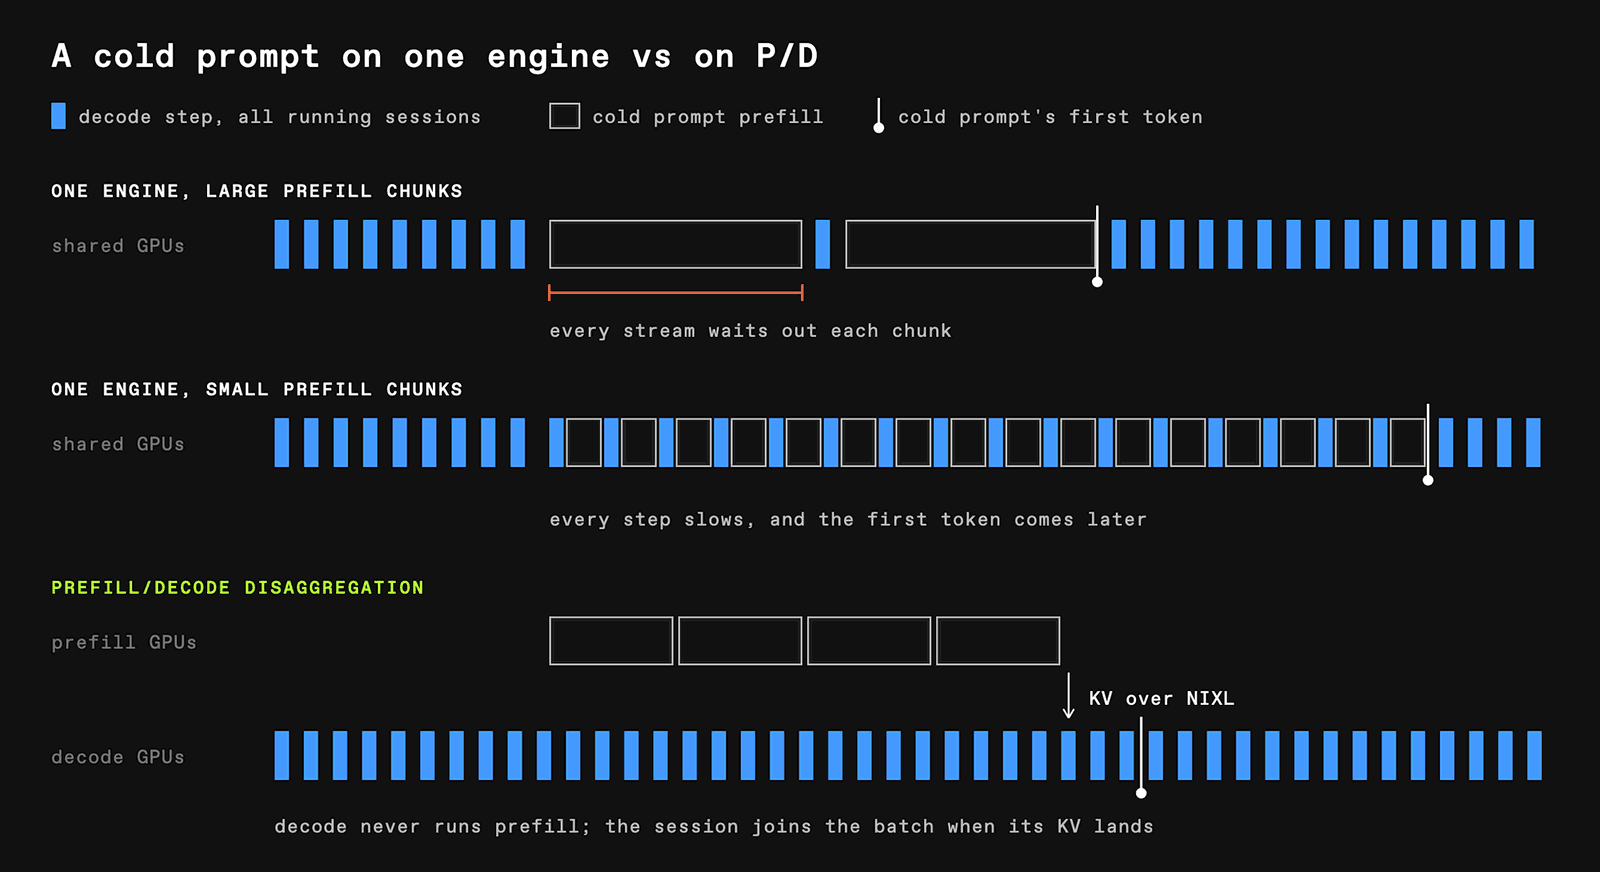
On shared GPUs, processing a long prompt can interrupt token generation for existing sessions. Chunked prefill limits these interruptions, but both workloads still compete for GPU time.
We run prefill and decode on separate GPU groups. NVIDIA Dynamo handles routing and orchestration, while vLLM runs the model on each group. Once prefill finishes, the decoder pulls the computed KV through NIXL and adds the request to its batch.
With Dynamo coordinating separate prefill and decode pools, we reduced p90 inter-token latency by nearly 40% in our tests.
Dynamo's KV-aware router chooses a prefill worker based on how much of the prompt it already has cached and how much work is queued there. Workers publish cache updates so the router can track where prefixes are available. We also keep sessions on the same decoder between turns to support KV reuse.
Mooncake provides a second cache tier in host DRAM. Prefixes offloaded from GPU memory can be retrieved instead of recomputed, allowing us to retain more conversation history.
With this architecture in place, we tuned GLM-5.3 on GB200 NVL72 for three goals at once: interactive speed, model quality, and concurrency.
Long-context agentic serving is as much a cache-management problem as a compute problem. Performance therefore depends on retaining that history, scheduling new work promptly, and moving cached state without interrupting ongoing generation.
Our interactivity target was 100 end-to-end tokens per second per user. We tune for the number of concurrent sessions we can support at that speed.
We optimized these paths separately: prefill topology and scheduling to reduce time to first token; compressed KV and a fused attention kernel to support low-latency decoding; and a transfer-friendly cache layout to reduce the overhead of moving KV between workers.
At the 100 tok/s/user bar, a 1:4 P/D ratio serves the most: 66 sessions per prefill group at 101 tok/s/user and 100 output tok/s per GPU.
For readers who want the engineering details, the rest of this post walks through each optimization in depth, followed by our work on reliable tool calls.
The sections below cover our work on topology, scheduling, compressed attention, and KV transfer:
Time to first token depends on more than processing the prompt. A request may need to retrieve cached history, wait for admission, compute new tokens, and transfer KV to a decoder. We investigated delays across this path, starting with cache capacity and scheduling.
We chose DEP8: eight data-parallel attention ranks with expert parallelism across the group. DEP8 distributes requests across eight attention workers while sharing the model's experts across the group. With the MLA cache layout we used, TEP8 replicated each request's KV across all eight ranks, while DEP8 let the ranks cache different requests. Even after accounting for the extra weight memory this requires, we had roughly five times more usable prefix-cache capacity on the same hardware compared to a topology like TEP8, which was also benchmarked.
The downside of DEP8 is the DP rank synchronization: each DP rank processes different requests but joins the same all-to-all communication at every MoE layer, so even an idle rank may need to run forward passes to keep up with its peers.
The dispatch overhead would further increase as EP goes wider. We found 1 DEP16 took 17.9% longer than two DEP8 groups, with combine and finalization growing the most.
Cache capacity does not eliminate scheduling delays. We found that a request's cached KV could already be available while the request still waited to enter the running batch.
Workers check for completed loads between forward passes. Results then pass through a batch queue and scheduler, where a ready request can miss the current decision and wait another step. Under load, requests already in progress can fill the next prefill batch, delaying admission even when the cached history is ready. This creates a scheduler bubble.
To reduce this bubble, we halved the number of prompt tokens processed in each prefill step, from 8K to 4K per GPU. Shorter steps let waiting requests start sooner. On our configuration, median queue wait fell from 550ms to 110ms, reducing median time to first token by roughly 20%.
Smaller steps add overhead for long, uncached prompts, but the tradeoff worked for our workload because most turns reused an existing prefix.
At our target load, TP4 gave us the lowest inter-token latency among the configurations we tested. With the same GPU budget, we could run more decode engines with fewer sessions running on each one.
However, TP topology comes with a KV capacity tradeoff. TP distributes model weights across GPUs, but with the MLA cache layout we used, each rank still holds a full copy of a request's latent KV, so TP therefore stores KV copies, which also increases the amount of data NIXL transfers from prefill to decode. TP4 stores fewer KV copies than TP8, but each GPU also holds a larger share of the model weights. We wanted to keep the TP4 latency advantage while fitting more KV into the memory available per GPU.
DEP avoids this replication by assigning requests to separate attention ranks, giving it more usable KV capacity, but when testing, we found that the synchronization between DP ranks before MoE dispatch increased decode latency.
We also tested decode context parallelism (DCP), which distributes the cached sequence across ranks while retaining tensor parallelism for the model. This reduced KV duplication, but introduced communication to gather queries, merge selected candidates, and combine partial attention outputs. With sparse attention, each query reads at most 2,048 cached tokens, so there wasn't much attention work to split across ranks in the first place. In our tests, distributing that work across ranks saved too little computation to offset the added communication. We therefore kept TP4 and looked for a way to fit more KV.
We compressed the 512-value MLA latent using NVFP4: four bits per value, with an FP8 scale for each group of 16 values. The 64-value positional component remained FP8. Including scales, each MLA cache row shrank from 576 to 352 bytes.
With the indexer and other state unchanged, total cache capacity increased by roughly 50%, from 1.09 million to 1.63 million cached tokens per decoder at the same memory budget.
Our first implementation unpacked the selected rows into temporary FP8 buffers in GPU memory before calling the existing attention kernel. This gave us the capacity benefit, but every layer paid for conversion and an extra write-and-read through GPU memory.
We built a native sparse-MLA kernel to remove that intermediate buffer. It consumes the positions selected by the sparse indexer, loads the compressed rows, and unpacks them on-chip as attention needs them. NVFP4 is the storage format; the attention computation uses FP16 operands with FP32 accumulation.
For each query token, a cluster of cooperating thread blocks divides the selected rows. In the GB200 configuration, each cluster spans three to eight SMs. The blocks combine their partial results through distributed shared memory, without a second kernel launch.
Inside each SM, separate groups of warps unpack rows, compute attention scores and softmax, and accumulate the output.
Three changes were particularly useful:
At 15 query tokens per launch, the optimized kernel took approximately 12.0 μs on GB200, compared with 17.7 μs for the staged NVFP4 path and 13.7 μs for FP8 attention. These are results for that workload, not a speed advantage over FP8 at every batch size.
Attention accounted for about 8% of a decode step at 32 concurrent sessions, so the larger practical benefit came from retaining more KV. NVFP4 gave us roughly 50% more KV-cache capacity while maintaining comparable per-user speed with decode prefix caching enabled.
We ran a rigorous evaluation suite, with particular emphasis on long-context tasks, to ensure that NVFP4 KV compression does not degrade accuracy.
We are contributing the native kernel to FlashInfer as an experimental operation.
Compression increased decode capacity, but disaggregation introduced another bottleneck: moving KV efficiently from prefill to decode.
We use vLLM's NIXL connector to let each decoder pull KV from the prefill workers over multi-node NVLink. In an early comparison, the NVLink configuration added roughly 292 ms to time to first token relative to InfiniBand. The faster interconnect was not translating into faster serving.
The bottleneck was transfer fragmentation. In the path we profiled, each transfer descriptor became a small device-to-device copy. A single 200K-token request arriving at one TP4 rank triggered 32K copies. Submitting and processing that many small operations limited the transfer before we could make effective use of NVLink's bandwidth.
The original layer-major KV layout, LBHNC, stored each layer's cache separately. Transferring a logical block across the model therefore required separate descriptors for its data in different layers.
Increasing the block size helped: using 1,024-token blocks reduced the number of transfer descriptors. However, larger blocks still left data fragmented across layers and could reduce KV-cache utilization by wasting more space in partially filled blocks.
We then tested BLHNC, a block-major layout recently introduced by the vLLM community. It places a block's data from multiple layers together in memory, allowing NIXL to transfer those contiguous regions with fewer, larger copy operations. We're grateful to the vLLM community for developing and sharing this layout.
In a separate TP8 comparison, the layer-major layout (LBHNC) used 1,024-token blocks , while the block-major layout (BLHNC) used 64-token blocks . Despite using 16× smaller blocks, BLHNC reduced the descriptor count from 19,559 to roughly 1,940 — about 10× fewer — and lowered mean transfer time from 146 ms to 78 ms, a reduction of roughly 47%. The BLHNC layout let us use finer-grained KV blocks while also reducing transfer overhead.
Performance is only part of production agent serving. Agents also need reliable tool calls to read files, run commands, and make edits. If the model calls the wrong tool or produces unusable arguments, the agent must retry or stop.
In our configuration, Dynamo converts the model's generated tool calls into the API response the agent receives. When serving GLM-5.3 at scale, we found several recurring failure patterns. Initially, we found the system could silently discard calls to undeclared tools and return a normal stop, leaving the agent with no action to execute or error to recover from.
Other calls had missing arguments or incorrect types, even when the client explicitly required the model to follow the tool's input format. The model received these definitions, but our GLM serving path wasn't enforcing them during generation.
Dynamo already had a mechanism for this, but lacked structural-tag support for GLM's format. We contributed a structural-tag builder to Dynamo to translate tool definitions into rules that restrict the names and arguments the model can generate.
vLLM uses xgrammar to enforce those rules during decoding, masking tokens that would violate the tool-call grammar. We also fixed errors introduced during parsing: literal strings such as were being converted into , altering code or file contents, while some schema references and nullable argument types were interpreted incorrectly.
We tested the final API responses for:
We maintain our own tool-call test suite covering these cases, validating the final API responses and checking for regressions as we update the serving stack.
情报判断
Aioga 编辑摘要
Prime Intellect发布推理服务平台Prime Inference,提供无服务器端点和预留容量,依托跨多个数据中心的GPU基础设施,为前沿开源模型提供服务。

 扫码直达文章详情