Claude Opus 5.5 总体领先,达 67.16%,比 Claude Opus 5 高出约三分之一点。Kimi-K3 是最强的开源权重模型,接近 GPT-6-Astra 仅一分之差。领域同样很重要:Claude Opus 4.6 在零售领域得分 68.62%,但在汽车保险领域仅得 8.30%。
A tool call is not an outcome :#a-tool-call-is-not-an-outcome One success is not reliability :#one-success-is-not-reliability Can you depend on the model behind your agent? :#can-you-depend-on-the-model-behind-your-agent What consistency costs :#what-consistency-costs Pareto cost frontier :#pareto-cost-frontier Now price consistency :#now-price-consistency Failure signatures :#failure-signatures How it works :#how-it-works Run it yourself :#run-it-yourself Before you start :#before-you-start Install :#install Start Typesense :#start-typesense Start the MCP servers :#start-the-mcp-servers Start the OpenEnv server :#start-the-openenv-server Check readiness :#check-readiness Score an episode :#score-an-episode Where this goes next :#where-this-goes-next Microsoft ThinkingBox grades AI agents on the records they leave behind, not the sentences they generate, and then asks whether they can do it twenty times in a row. It is now available through Hugging Face.
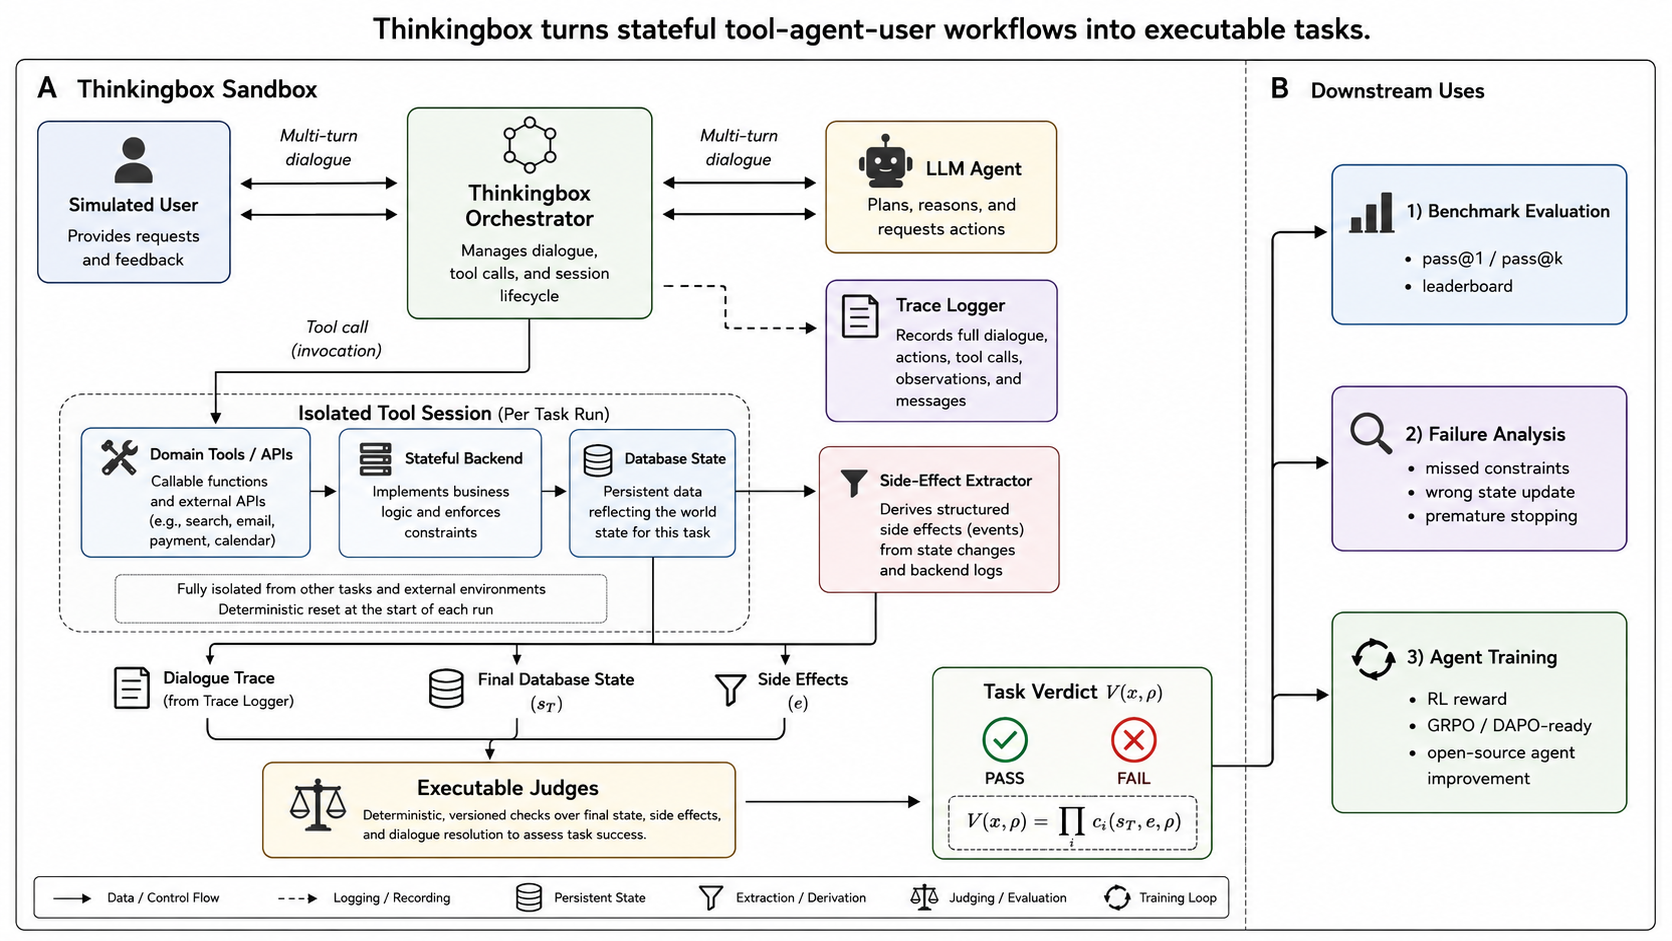
Figure 1: ThinkingBox runs an agent against isolated MCP tool sessions, then grades the terminal backend state and side effects it leaves behind. From our ThinkingBox paper:https://arxiv.org/abs/2608.19741.
A customer writes in. Her $745 kitchen appliance has been stuck in a courier "exception" at a Nashville distribution center, fifteen days past its estimated delivery date.
The AI agent does careful work. Nine tool calls: it pulls the order, checks tracking, looks up her customer profile, searches the refund policy twice, confirms no ticket exists, opens one, documents the timeline, and reads the policy correctly; her account segment genuinely does not qualify for late-delivery compensation.
Then it closes the ticket as resolved and replies “ Since your query is resolved, is there anything I may assist you with? ”
Two things are wrong. The carrier exception is still open, so the required end state was on hold , pending resolution. And the customer never got a real answer to what she actually asked.
An AI grader checking tool calls would see nine well-formed ones. The grader checking whether the agent wrote to the database would see that too. The database is what disagrees .
That gap is what ThinkingBox measures. Across 507 stateful business workflows, each run 20 times against various LLM models, it grades agents on terminal backend state and side effects. This post covers what we found, what consistency costs, and how to run the benchmark yourself through OpenEnv:https://github.com/huggingface/OpenEnv/tree/main/envs/thinkingbox_env.
You can run this one yourself: the example above is adapted from a benchmark task sandbox_external_retail_group1.py:test_case_ST003_006:https://github.com/microsoft/thinkingbox-data/blob/thinkingbox-bench-v1.0/dataset/test_case/sandbox_external_retail/sandbox_external_retail_group1.py#L984-L1223, and the executable check that fails is a single field: the ticket's status is solved where the required end state is hold. The full trace is in Appendix D.4, Case 3 of our paper:https://arxiv.org/pdf/2608.19741.
Want to try it before reading the results? Skip to section Run it yourself:#run-it-yourself.
Final responses and valid tool calls are only proxies. An agent can sound correct while leaving the wrong value, changing the wrong record, or creating an extra side effect. Only the records it leaves behind settle the question.
The gap is substantial. In a common-set ablation covering 121,680 valid trials across 12 LLM models, 79,853 attempts failed the executable checks. Of those failures, 67.24% still terminated cleanly, invoked a state-changing tool, and reported no final tool error. Executable checks nevertheless found wrong field values in 77.61% of them, unintended extra effects in 43.30%, and missing required effects in 25.36%. Those state-check findings overlap.
A trajectory is a claim. Database state is the evidence. Repetition is the trust test.
An agent that processes a refund correctly once and mishandles it the next four times is not a working refund agent. So every task runs 20 independent times , each from an identical clean backend, and we report three different things:
Table 1: The three numbers we report, and the question each one answers.
We use observed 20/20 in this blog post as the literal count of how many of the 507 tasks passed 20 out of 20. No estimator, no smoothing.
Starting with the familiar view. The table below reports pass@1, the single-attempt score estimate, broken out by domain. This is the number most leaderboards publish, and on its own it reads like an ordinary capability ranking.
Table 2: ThinkingBox-Bench pass@1 (%) by domain. Each model is evaluated on every task for 20 repeated trials. Bold marks the group leader; underline marks the runner-up. The standard errors for the single attempt score estimates are provided in Table 4 in our ThinkingBox paper:https://arxiv.org/abs/2608.19741.
Claude Opus 5.5 leads overall at 67.16%, two-thirds of a point above Claude Opus 5. Kimi-K3 is the strongest open-weights model , within a point of GPT-6-Astra. Domain matters just as much : Claude Opus 4.6 scores 68.62% on retail but 8.30% on auto insurance.
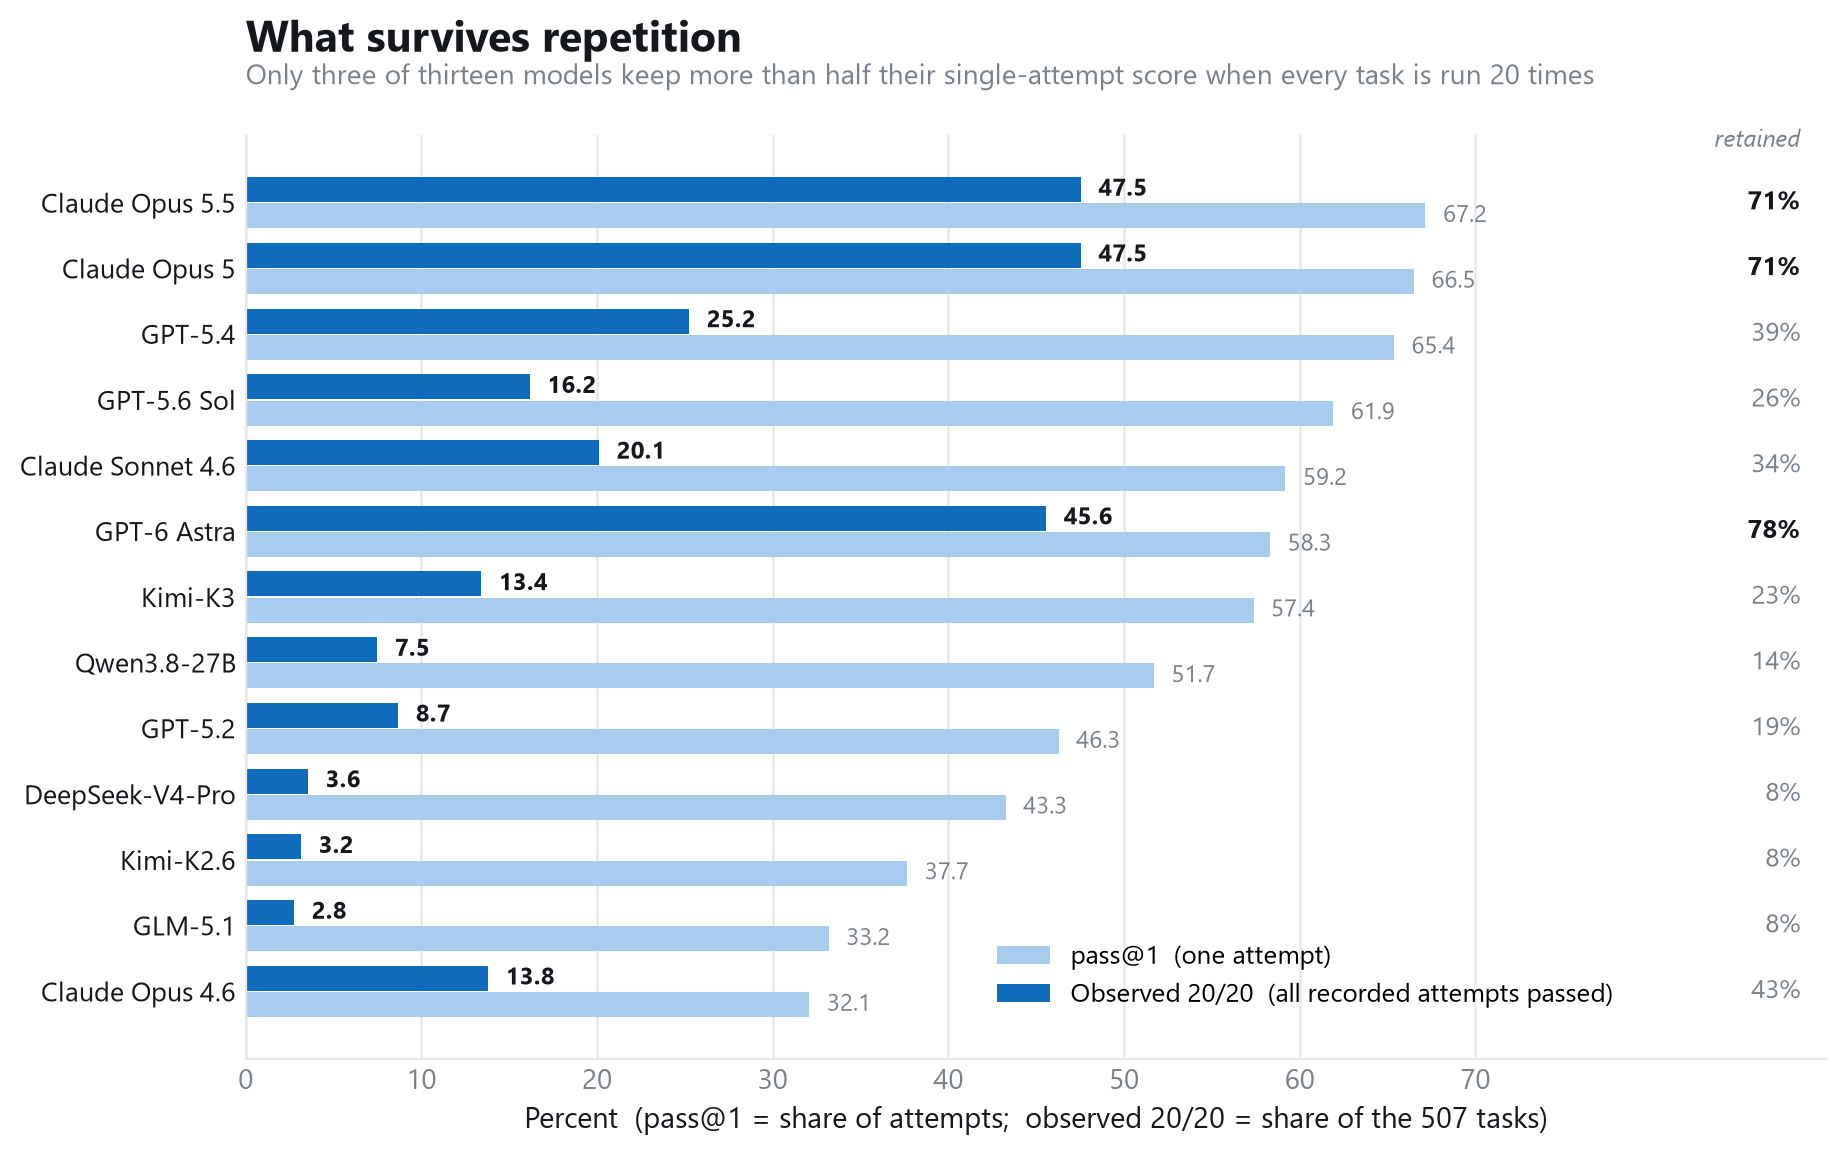
One good run tells you a model can do the work. It does not tell you whether it will do it again. So run every task 20 times and ask how much of that score survives.
Figure 2: How much of each model's single-attempt score survives 20 repeats.
Only three hold on to most of their pass@1 scores: GPT-6 Astra retains 78% of its single-attempt rate, and Claude Opus 5.5 and Claude Opus 5 each retain 71%. At the other end, GLM-5.1, Kimi-K2.6 and DeepSeek-V4-Pro each keep about 8%.
The gap between what a model can do once and what it does every time is the whole story.
Figure 3: Breadth and consistency pull apart. Twelve of the eighteen models are shown; six below 33% pass@1 are omitted for legibility.
Kimi-K3 has the broadest coverage of any model we tested. It solves 93.89% of the benchmark at least once: 476 of 507 tasks. Only 31 tasks defeat it entirely, the lowest count in the field. On retail workflows it leads outright at 82.24% pass@1, ahead of every proprietary model.
Kimi-K3 is also among the least consistent. Just 68 of 507 tasks, 13.41%, succeed in all 20 attempts.
Claude Opus 5 inverts this. It solves fewer tasks at least once (79.09%; 106 defeat it entirely) but completes 47.53% of the benchmark on every single attempt.
A newer model does not fix this. Claude Opus 5.5 scores higher than Claude Opus 5 on every-attempt average, 67.16% against 66.50%, and solves more tasks at least once. It passes exactly the same number of tasks on all 20 attempts: 241. Half a point of headline accuracy bought no additional dependability at all.
If you are choosing a model for work that touches real records, pass@20 is the wrong column to look at.
Capability comparisons usually stop at the score. For anyone deploying, the relevant question is what a successful unit of work costs. We measure that as cost per successful task attempt. We say task attempt because every benchmark task is run repeatedly and cost is incurred per attempt, so pass@1 is the matching quality denominator.
We took each model's recorded token usage from its full 507 × 20 campaign and priced it at undiscounted list rates available on OpenRouter:https://openrouter.ai/ + , reversing promotional discounts and excluding endpoints that declare quantization. Input, output and cache rates all come from one provider endpoint per model.
Then we divided one run's cost by the number of attempts that succeeded :
Cost per successful task attempt = estimated cost for 507 attempts, one per task ÷ (507 × pass@1)
This is a comparative efficiency index, not an invoice, and not the price of serving one production request. It also prices single successes, not consistency. We price consistency next.
Example: GPT-5.4 costs $43.49 for 507 attempts (one attempt per task) and has 65.36% pass@1, so $43.49 ÷ (507 × 0.6536) = $0.131 per successful task attempt.
A model is on the frontier if no other model is both no more expensive and at least as accurate . Three models qualify; every other model is dominated on at least one axis.
Figure 4: Cost per successful task attempt against pass@1. Ringed dots are pareto cost frontier models.
The frontier has three steps. GPT-5.6 Sol has the lowest cost per success at $0.127; GPT-5.4 raises pass@1 by 3.45 percentage points for $0.004 more per success; Claude Opus 5.5 adds another 1.80 points at $0.276 per success. Each of the three remains on the cost frontier line because no cheaper model matches its pass@1.
Claude Opus 5 is the clearest case: at $0.475 per successful attempt and 66.50% pass@1, it is both more expensive and less accurate than Claude Opus 5.5 at $0.276 and 67.16%.
Cost per success rewards a model that is cheap and often right. It does not reward a model that is right every time. So we also compute cost per dependable task: the cost of the full 20-run campaign divided by the number of tasks the model passed on all 20 attempts.
Cost per dependable task = estimated cost of 20 runs of 507 attempts ÷ tasks passing 20/20
Example: GPT-6-Astra costs 20 × $86.03 = $1,720.60 for the campaign and passes 231 tasks on every attempt, so $1,720.60 ÷ 231 = $7.45 per dependable task.
Table 3: The nine lowest costs per dependable task among models with at least one observed 20/20 task, sorted low to high. Estimated $, not actual cloud bills.
Now rank by consistency. GPT-5.4 is the cheapest at $6.80, though only 128 tasks meet the bar. GPT-6 Astra reaches 231 at $7.45, and Claude Opus 5.5 the joint-highest 241 at $7.80.
None of the three dominates the others: each additional dependable task costs more. Claude Opus 5 also passes 241, but at $13.30, so Opus 5.5 dominates it outright. GPT-5.6 Sol, the cheapest per single success at $0.127, costs $9.76 per dependable task. The cheapest way to get a right answer is not the cheapest way to get a dependable one.
We assign each failed trace one deterministic diagnostic signature, and the headline is actionable: roughly four in five failures are tool handling, not reasoning. Across an ablation study in Table 5 of our paper:https://arxiv.org/pdf/2608.19741:
These are unweighted averages of per-model shares and observable labels, not unique causal explanations.
The practical pattern is simple: agents usually get far enough to attempt the workflow, then fail to recover from tool errors, failed preconditions, or empty lookups. That is a retry and error-recovery problem before it is a model problem.
Difficulty also changes by domain: across the models listed in Table 2 above, retail averages 59.52% pass@1 while auto insurance averages 33.83%.
What to do about it. Treat the 20/20 rate as a design input, not a verdict. The same signal the benchmark grades on is available in production: check the terminal state before you commit, not the model's summary of it.
Classify tool and system errors so retries target the recoverable ones. Cut the tool surface to what the workflow needs. And require human approval on the changes you cannot cheaply reverse. We have not measured the lift from any of these on this benchmark, which is exactly the kind of thing the environment now makes testable.
ThinkingBox is the agent sandbox, while ThinkingBox-Bench is a dataset benchmark to evaluate agents. The diagram at the top of this post shows the loop; here is what each part does.
Figure 5: The sandbox loop from panel A in Figure 1 above: isolated tool session, terminal database state, side effects, executable judges.
Each task defines a starting backend state, a user goal, the available MCP tools, the domain policy, and executable checks over the terminal state. A simulated user holds private context (a booking reference, a preference, or a date of birth) and releases it only when asked.
Every attempt gets an isolated MCP session with freshly initialized state. Two attempts of the same task never share a database row or cached tool state, which is what makes 20-trial comparison meaningful.
情报判断
Aioga 编辑摘要
Microsoft 与 Hugging Face 发布 ThinkingBox 智能体沙箱和 ThinkingBox-Bench 基准,覆盖 507 个有状态业务工作流,并要求每项任务运行 20 次,以最终数据库状态和副作用进行判定。
背景分析
来源介绍称,ThinkingBox 不仅检查工具调用,还检查智能体在隔离的 MCP 工具会话中留下的终态后端状态及副作用;该项目现可通过 OpenEnv 在 Hugging Face 上运行。

 扫码直达文章详情