当地时间 10 月 1 日,AI 音乐制作平台 Suno 宣布推出 Speech 功能并开放公测(Beta),官方称这是业界首个将语音与音乐作为单一连贯音轨共同生成的端到端闭源音频模型。
Suno 推出 Speech 语音功能,语音与音乐可单轨共同生成 这条更新来自 ithome.com,发布时间为 2026-10-03,Aioga 保留原文入口以便核验。
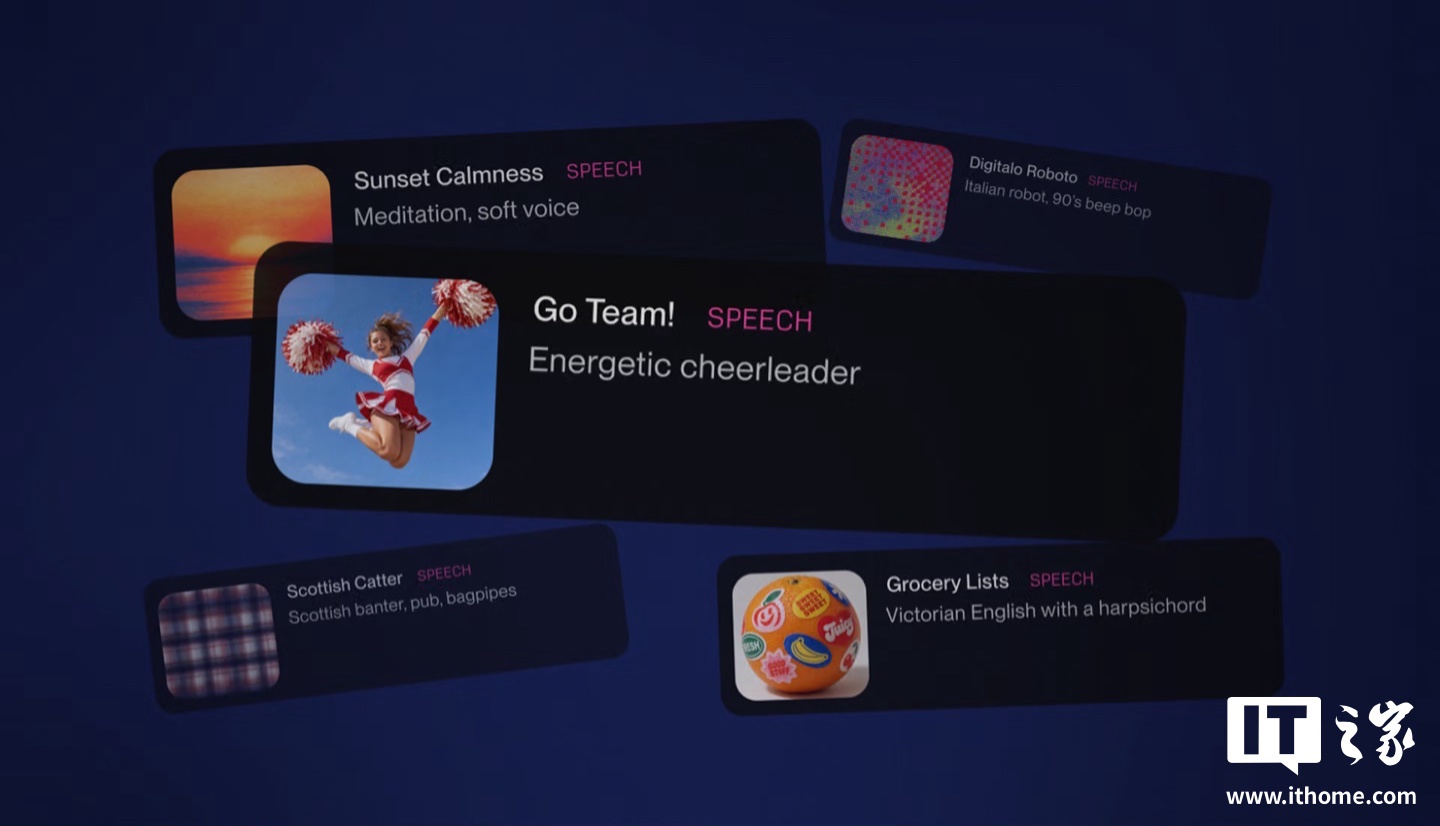
摘要:当地时间 10 月 1 日,AI 音乐制作平台 Suno 宣布推出 Speech 功能并开放公测(Beta),官方称这是业界首个将语音与音乐作为单一连贯音轨共同生成的端到端闭源音频模型。该功能内置于 Suno 中,输入一段文字并描述音色与音乐风格即可生成带 BGM 的语音音频;官方承认当前版本偶发口音漂移和语调过于戏剧化的问题。
背景:背景分析:公司与行业类动态需要放在竞争格局、商业化路径、资本信号和监管环境中观察,单条公告不能代表最终结果。
Aioga 观察:Aioga 判断:这条动态更适合作为行业观察信号,当前信息足以建立线索,但不足以推导长期结论。
影响与后续:影响分析:对相关团队而言,短期应先核对来源、可用范围和实际成本,再判断是否值得接入或跟进。 后续观察:继续观察官方文件、合作落地、收入或用户信号、竞品动作和监管后续。
IT之家:https://www.ithome.com/ 10 月 3 日消息,当地时间 10 月 1 日,AI 音乐制作平台 Suno 宣布推出 Speech,Suno 宣称这是 业界首个能够将语音与音乐作为单一连贯音轨共同生成的音频模型 。
据悉,该模型并非像传统工作流那样先做 TTS(文本转语音)再拼接 BGM,而是端到端一体化生成,是首个能单次生成完整融合“语音朗读 + 原创 BGM”的端到端闭源音频模型。
在过去一个月中,Suno 与小范围用户共同测试了该功能,现在正式面向所有人开放公测(Beta)。
官方表示,通过 Speech,用户可以轻松创作带有 BGM 的语音音频。该功能已直接内置于 Suno 中:只需输入一个灵感、一首诗或一段文字,再描述用户心目中的音色与音乐风格即可。
IT之家注意到,Suno 官方也指出了当前 Beta 版的不足,当前版本偶发口音不稳定的问题,例如英音可能会在中途漂移到澳音然后又漂回来;语调与情感停顿有时会显得“过于戏剧化”,导致断句节奏过慢。

 扫码直达文章详情