A memory plugin analyzes your conversations. It generates 1,000 isolated snippets and inserts them into a vector database. With your every prompt, it attaches the five most similar snippets; if the agent is confused (which it is), it manually searches for more. That’s the product they call “memory.”
It’s a strange thing to use when you think about what problem you’re trying to solve. You want your agent to understand your project. To know where a feature is, why it was built, what you agreed on and what you care about. Instead, you get a lottery over RAG snippets, injected on every prompt, hoping the right ones float up.
Even when it does work, the agent still doesn’t understand your project. The entire memory plugin ecosystem is solving the wrong problem.
Because agents don’t need memory. They need documentation.
Every memory plugin on the market works the same way:
That’s the whole architecture. Some tools are extra fancy; they let the agent search through past transcripts word for word. Or they implement some kind of multi-tier memory system that classifies short or long-term memory. Or they add a bunch of background daemons to review, merge, or deduplicate memories. “Dreamers” that rewrite memories overnight. Continuous context compression. Rerankers. Et cetera.
Each plugin tries to add new token-burning “features” to fix the same flawed architecture underneath. And that’s why none of them reliably work.
All of these memory plugins suffer from the same broad set of problems.
These are only five of the many problems that memory plugins face, attempt, and fail to fix, because they all make the same assumption:
Agents forget: that’s the problem. So the fix is to remember. To remember better, we should capture more, index better, retrieve smarter.
Their entire thesis revolves around capturing and recalling the past. But that’s not how anyone else handles knowledge. No one rewatches a team meeting from 3 years ago to remember constraints around a feature. People write things down and use those records instead.
Similarly, the solution is NOT to give an agent a search tool that it uses to search over the past 10 million tokens worth of conversations, reconstructing fragments of what happens.
The solution, is document-based memory.
Today, people use AI to pump out products, features, and slop at the speed of light, all without reading or understanding a single line of code. Under these circumstances, it’s easy to see how documentation ends up becoming an afterthought when it should be more important than ever.
People already knew agents needed context. That’s why they invented AGENTS.md files: so agents don’t jump into a codebase blind. It works. But oftentimes, that single file is the ONLY documentation that the project has.
A single file is not enough. The agent needs an entire brain, a structured workspace where it can record instructions, specs, decisions, research, indexes, anything without being asked. Instructions for how the code review process works, specs detailing what was discussed with the user, reusable research into a foreign library or API.
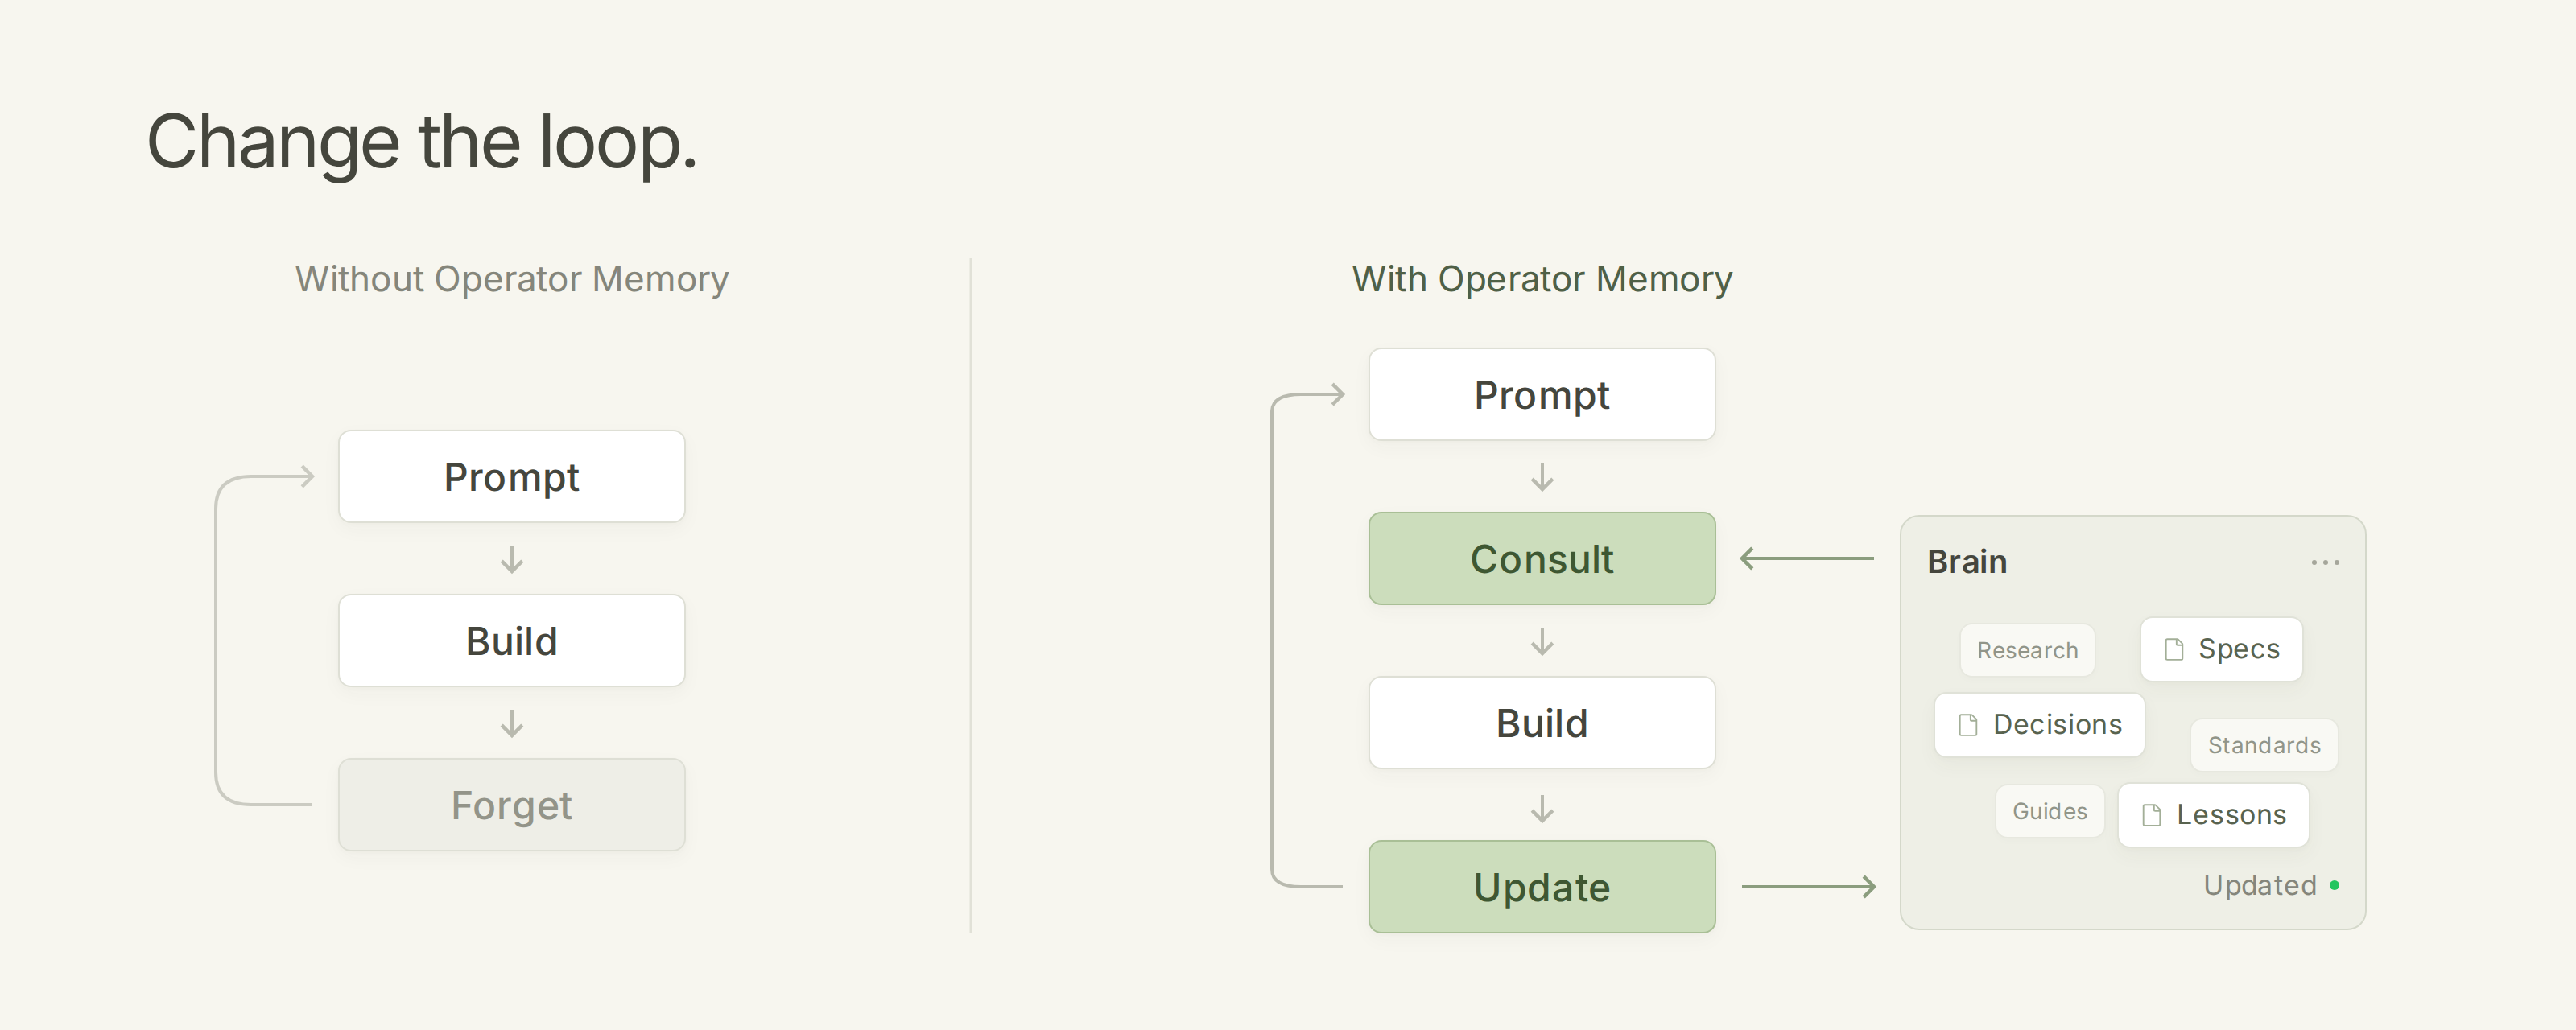
When the agent works, the agent can read files from the brain to gain relevant and complete context. After the agent works, it updates what’s outdated, adding new documents where necessary, while the full picture is still in context. In this way, the agentic loop changes from prompt → build → forget to prompt → consult → build → update . Memory turns from a RAG database you bolt onto the agent into a workspace you can read, update, and even share.
I recognized this problem over a year ago when I first started programming with AI. I wanted a way for an agent to remember work across sessions, so I started by creating an internal/ folder where I asked the agent to write everything down: specs, plans, indexes. I tasked the agent with always reading the appropriate documents and index before doing work and updating afterwards.
This set of rudimentary instructions slowly transformed into a formal system, and then into a plugin called Operator Memory that I’ve been using regularly within all of my projects.
Operator Memory provides document-based memory using the model described above. Operator provides your agent with a Markdown brain where it can persist important knowledge: instructions, specs, research, indexes. Before working, the agent always consults the brain for relevant documents. After working, the agent updates the brain; revisiting stale documents, adding documents where missing.
No vector databases. No embeddings. No summarizers, curators, updaters, dreamers, or any other token-burning background daemon. No black-box retrieval.
With Operator, everything is a plain Markdown document that you can read, update, commit, and share with your team. I’ve been using this system for over a year. If you want to try it out, it’s free and open source: https://github.com/aerovato/operator-memory:https://github.com/aerovato/operator-memory

 扫码直达文章详情