模型变得更聪明,对长周期任务的处理能力更强,Anthropic 发布的 Mythos 5 和 Fable 5 模型标志着在可以可靠委托给 AI 系统的任务类型上迈出了重要一步。我记得上一次类似的时刻是 2025 年底 Opus 4.5 的发布,到那时,许多工程师,包括我自己,都从将 AI 编码工具作为辅助自动补全,转向使用像 Claude Code 这样的编码工具作为主要工作接口。
与此同时,代理协调工作流和原语正被直接打包进流行的开发框架,使复杂的多代理工作流程更易于访问和操作。其中一个重要功能是由 Claude Code 和 Codex 提供的“Goals(目标)”,它能让模型在长期内保持工作并专注于可衡量的目标。我大约在六个月前第一次在 Karpathy 的 Autoresearch:https://github.com/karpathy/autoresearch 项目中遇到过这种实验-测量-迭代的循环,但现在它已经成为常规编码框架的一部分。
随着 AI 系统能力的不断提高,对推理服务的市场需求也在增长,从而带来了不断提高成本和性能的巨大压力。
Claude Code with Fable 5 built a Qwen 3.6 inference engine that beat vLLM by up to 90% on decode speed and 2.3x on TTFT, using MetaInfer skills on one B200.
Baseten is the kind of place where we have Slack channels like #ai-papers-discuss and #model-performance-reading-group , and it was in one of these channels that a paper caught my attention recently: MetaInfer: A Knowledge Only LLM Inference Engine Generator SKILL Toolbox:https://arxiv.org/abs/2607.12875v1.
In it, the authors provide a skills-only framework for building custom inference engines from scratch, claiming their results beat SoTA open solutions like vLLM on common inference performance metrics like time per output token (TPOT). “Skills-only” here means no model post-training, and no specialized harnesses. I’ll admit, I was skeptical, but they provided a repo with the skill toolkit, and we’re still living that unlimited-token good life here, so I thought I’d give it a try on a popular model just to see how it did.
With Qwen-3.6-35B-A3B in NVFP4 precision on a single B200, our LLM-generated inference engine outperformed vLLM 0.25.1 (latest at the time of the experiment) by up to 90% on single-stream decode speed, and with 2.33x faster TTFT, opening up new ultra-low-latency use cases for the model that had not been practical before.
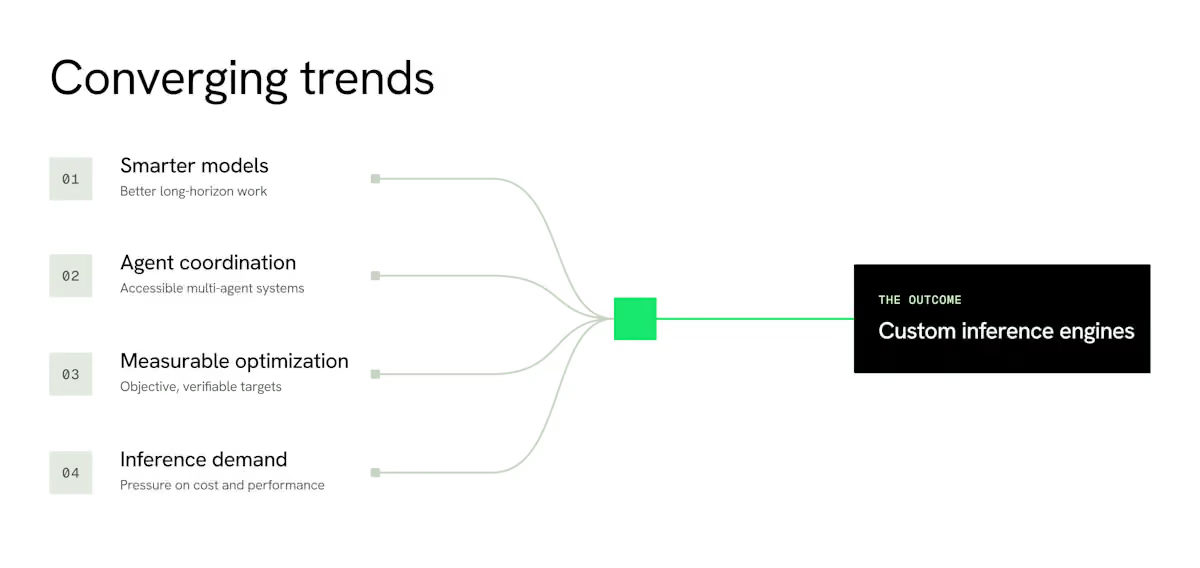
There are a few large-scale trends that are converging right now, creating fertile ground for discoveries and techniques like MetaInfer.
Models are getting smarter and better at long-horizon tasks, with the release of Anthropic’s Mythos 5 and Fable 5 models marking a meaningful step forward on the kind of tasks that can be reliably delegated to AI systems. The last such moment I remember was the release of Opus 4.5 in late 2025, at which point many engineers, myself included, moved from using AI coding tools as a spicy autocomplete to driving coding harnesses like Claude Code as our primary work interface.
At the same time, agent coordination workflows and primitives are getting packaged directly into popular harnesses, making complex multi-agent workflows more accessible and easier to operate. One important such feature is “Goals”, provided by both Claude Code and Codex, which keep models working and on-task toward measurable goals over long periods of time. I first encountered this experiment-measure-iterate loop in Karpathy’s Autoresearch:https://github.com/karpathy/autoresearch project about 6 months ago, but it's now just part of normal coding harnesses.
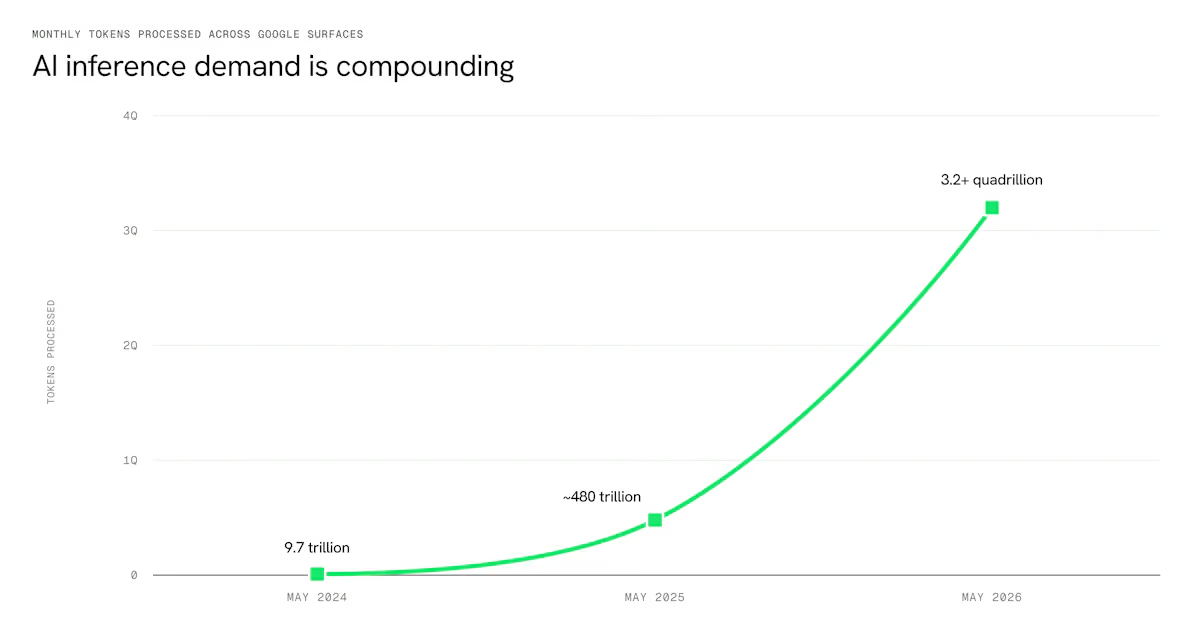
As the capabilities of AI systems keep increasing, so does the market demand for inference services, creating enormous pressure to continuously improve both cost and performance.
With all of these factors combined, it starts making a lot of sense to point LLMs at well-defined optimization problems and just let them grind away at solutions. Inference performance turns out to be an ideal domain for this kind of automated optimization. The problem space is well-defined in terms of quantifiable metrics like TTFT, TPOT, throughput-per-chip, and required memory. Even correctness can be numerically verified against full-precision reference implementations of the model, to ensure that performance gains do not come at the expense of accuracy.
This objective verifiability is critical to the success of autonomous optimization. We also know that there is a huge gap:https://arxiv.org/pdf/2606.26383 between current SoTA performance and speed-of-light theoretical maximum performance. Additionally, inference is enormously complex, and the search space for optimizations is very large, ranging from low-level CUDA kernel authoring all the way to serving-layer optimizations like dynamic batching.
LLMs may be very good at solving well-defined optimization problems, but now the challenge shifts to how to frame your problem as a well-defined optimization problem. You need to be able to define your constraints well, and choose your optimization targets carefully. The agent will absolutely try to game the system to “pass” the goal, so it’s up to you as the engineer to design the game in such a way that the agent’s success actually aligns with what you need. As an example, if you don’t set accuracy-preserving constraints, your “model” will converge on:
Such a simple model will have unbelievably good TTFT and TPOT scores, but is no longer useful for anything.
Existing open inference engines like vLLM, SGLang and TensorRT-LLM do an overall great job at serving a wide range of models on a large variety of accelerators at commercially acceptable performance levels. However, the benefits they offer in generality and ease of use come with a tradeoff: they are not hyper-optimized for any specific (model + accelerator + workload) tuple. The premise behind MetaInfer is that for any specific deployment, a highly specialized (i.e., constrained) engine can outperform these generalized engines.
In the original MetaInfer paper, they challenge off-the-shelf agents to build inference engines from a knowledge base of contracts and constraints, with no direct access to source code from open engines. It’s extremely likely that such source code was present during model training, but agents did not have direct file-level access. Agents expand the knowledge base as they work, proactively identifying gaps and filling them through structured experimentation and verification.
While the experimental purity taken on by the authors is admirable and interesting, we’re very outcome-oriented at Baseten. I did allow my agents to access SoTA open solutions for reference when needed, including finding pre-optimized kernels from vLLM and TensorRT-LLM where available, and only writing their own kernels when needed. Additionally, while the original paper focused on just the inference engine component, I broadened the scope to the full serving stack, with final outcomes measured against deployed multi-replica services behind a load balancer, using AIPerf:https://github.com/ai-dynamo/aiperf to generate load and measure performance.
In both the original paper and my extension, the result is two deliverables: the inference engine itself, and reusable extensions to the knowledge base that can be used in subsequent runs.
In kicking off the experiment, I gave Claude Code with Fable 5 access to the paper and the MetaInfer Repository:https://github.com/HuangPuStar/MetaInfer, as well as access to an NVIDIA B200 workstation via SSH. I told it the target hardware and provided a link to the Hugging Face repo for both the NVFP4 quantized weights:https://huggingface.co/nvidia/Qwen3.6-35B-A3B-NVFP4 I wanted to use for Qwen-3.6-35B-A3B, as well as the original full-precision weights:https://huggingface.co/Qwen/Qwen3.6-35B-A3B to be used as an accuracy oracle. The agent was also able to deploy engine candidates to Baseten, and to run AIPerf profiles against the deployed endpoint.
We have internal agent skills and MCPs to facilitate all of the required Baseten interactions, and the agent did have access to those as well. I set a /goal telling it I wanted to beat vLLM by 20% on all performance metrics without accuracy loss vs. the NVFP4 baseline.
I was surprised and impressed both by the final results and the relatively low amount of human intervention required. Claude worked mostly autonomously for roughly 1 week on this project, with me providing occasional steering to keep it from over-fixating on one particular traffic shape or another, and to keep it focused on production inference performance, and not just isolated engine benchmarks. The MetaInfer framework uses a series of immutable gates and checks that enable productive long-horizon work like this.
Claude would periodically pause to ask me to approve any changes that came with accuracy differences. I ultimately allowed it to have subtle numerically different outputs from the reference NVFP4 implementation, as long as overall accuracy vs. the BF16 baseline was at least as good.
I did very little to manually manage agent coordination or context management other than requesting that it use Fable 5 for all subagents after some disappointing early results from smaller models. It underwent automatic context compaction many times, and consumed roughly 1.7 billion tokens (overwhelmingly cached input tokens) and ~200 B200 hours. It actually reached parity with vLLM relatively quickly, within the first few days, but I had it keep grinding away for the sake of science.
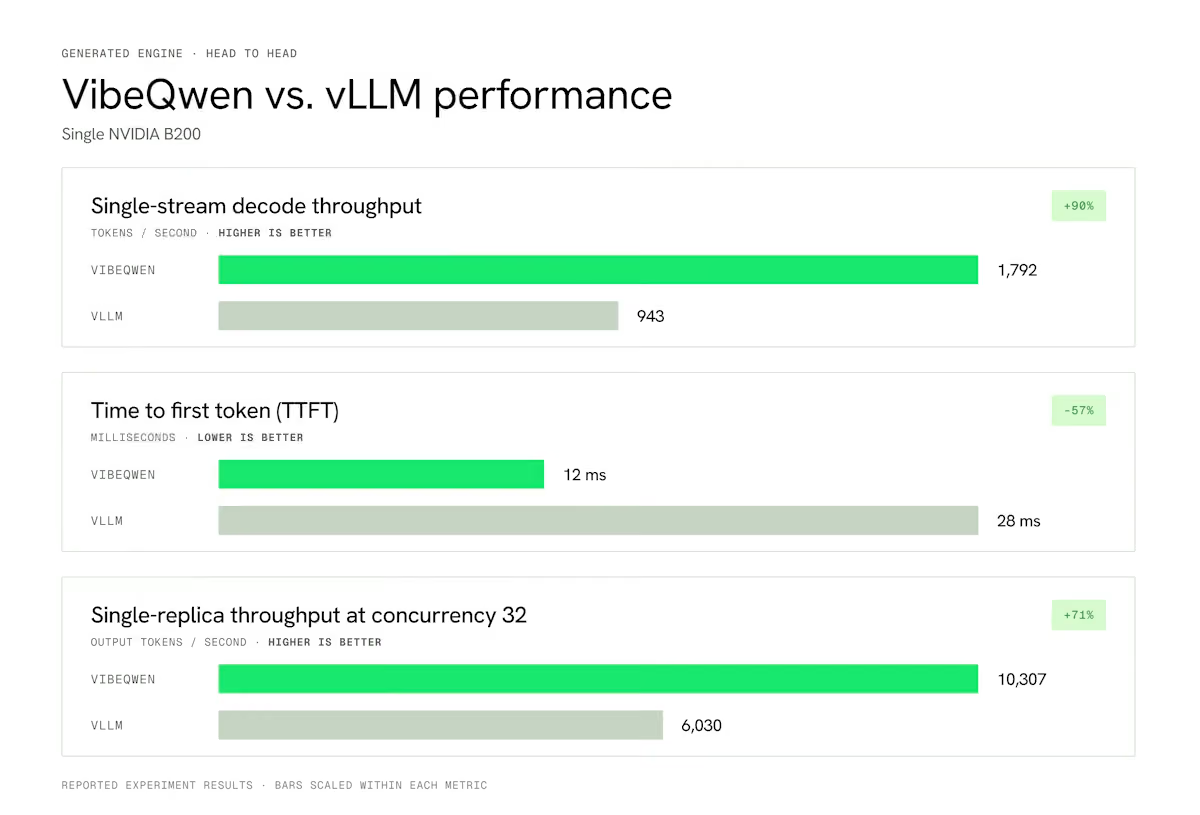
By the end, the generated engine, called VibeQwen , outperformed vLLM across all tested traffic patterns, and by very large margins in some cases. In head-to-head comparisons on a single B200, VibeQwen achieved 1,792 tokens per second (TPS) on single-stream, speculator-friendly text (repetitive and structured), vs. 943 TPS on a well-tuned vLLM deployment (a 90% improvement). It also returned its first token in 12ms on the tested corpus, vs 28ms with vLLM, a 2.3x improvement. In single-replica throughput at concurrency of 32, VibeQwen beat vLLM by 71%, at 10,307 output TPS vs 6,030 output TPS in vLLM.
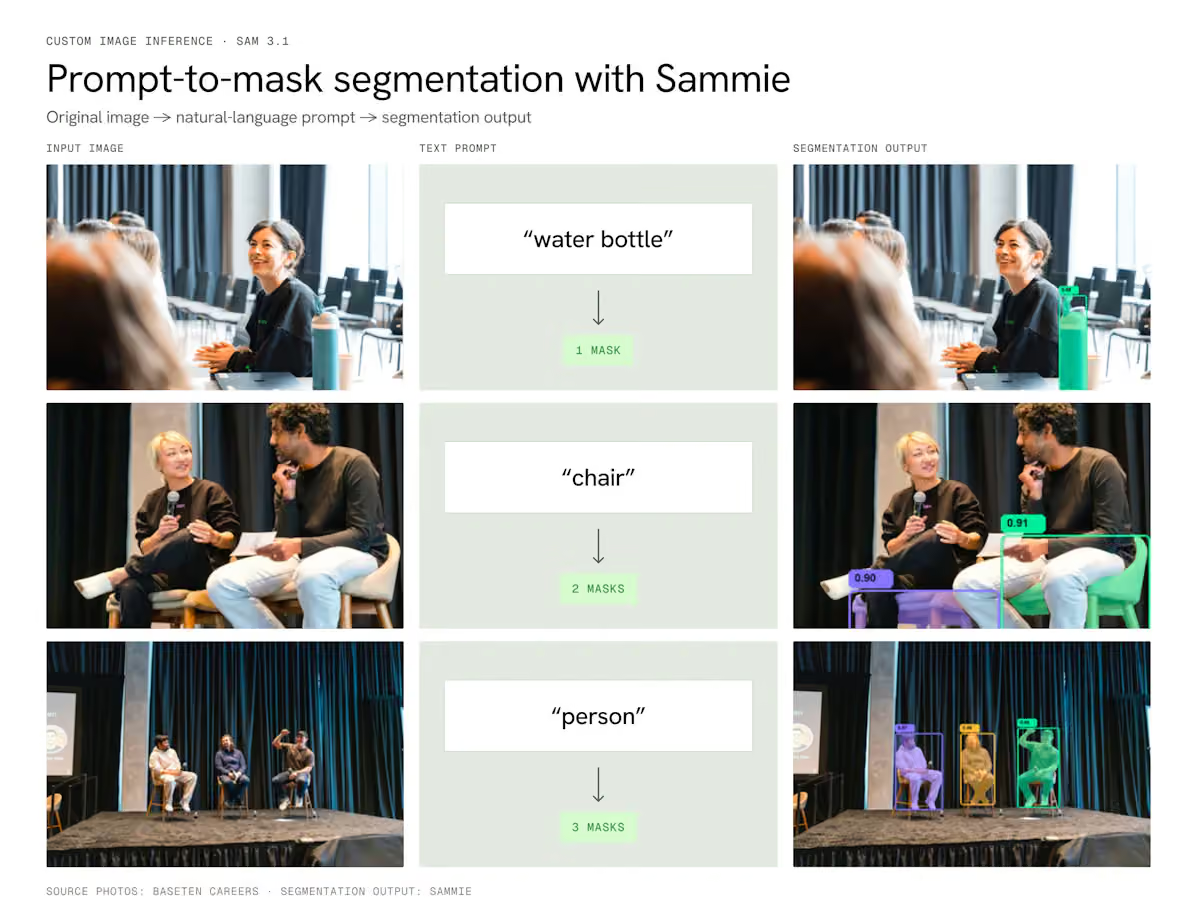
The results from this first experiment were so encouraging that I decided to try it out on another model, of a completely different type, using the newly expanded knowledge base generated from the VibeQwen experiment. This time I wanted an optimized inference server for SAM 3.1:https://huggingface.co/facebook/sam3.1, a state of the art image segmentation model.
In this case, I used Facebook’s reference server:https://github.com/facebookresearch/sam3 as the baseline. Despite entirely different model architectures and modalities, the process worked very well, and we achieved 91 images/second on a single H100, a 50% throughput improvement vs. the baseline in just a couple of days and ~200M tokens.
This second experiment, called Sammie , was much faster and less expensive than the initial VibeQwen project, but due to different model architectures, accelerator types, and no control testing, it provides only suggestive, not definitive, evidence that the knowledge base reuse has value.
While VibeQwen and Sammie are still very much experimental, with neither serving production traffic currently, the performance improvements vs. SoTA baselines are quite remarkable. They were also delivered in relatively little time (days), with very little human labor (hours), and a low enough cost ($100s for Sammie to $1000s for VibeQwen) to be very compelling in a world where companies spend tens or even hundreds of millions of dollars annually on inference. At such large scales, even single-digit percentage improvements can represent millions of dollars in savings, making the investment easy to justify.
The opportunity space for AI to create value in optimization problems is vast, and AI systems themselves are prime candidates for these autonomous optimizations, as we’ve seen. The cost of doing so will continue to come down as inference systems get more efficient, and as more models achieve the level of intelligence required to succeed at the task.
While VibeQwen and Sammie were built with Fable 5 in late July, it’s October now, and the open frontier has nearly caught up, with models like Kimi K3:https://www.baseten.co/library/kimi-k3/ and GLM-5.3:https://www.baseten.co/library/glm-53/ scoring very close to the best closed models on many benchmarks. Between rising model intelligence, falling inference costs, and efficiency gains from the reusable knowledge base, it’s easy to imagine a not-so-distant future where these optimizations become so cheap and reliable that they are a standard part of the model deployment lifecycle.
Join us in building the inference platform for production AI.

 扫码直达文章详情